状态机编码风格实测:binary/one-hot/gray 三种编码 yosys 综合资源对照
更新时间:2026-10-25。本文是「集成电路大类 · 芯片设计」中间层(intermediate)的一篇实验文。理论篇 有限状态机设计方法论 已经讲过状态机的三段式写法、状态编码的三种主流选择(binary 省触发器、one-hot 组合逻辑浅、gray 相邻状态只翻一位),那一篇回答「编码风格各自适合什么场景」;本篇回答一个更具体的问题——**同一台状态机,只改编码属性,综合出来的电路到底差几个门?**我们把同一台四状态 FSM 复制三份,分别打上 binary / one-hot / gray 编码属性,交给 yosys 综合并打印 stat 报告,让单元数自己说话。one-hot 在调度类电路里的实战用法还可以对照 one-hot 编码与轮转调度。
本文要回答的问题
fsm_encoding属性是怎么告诉综合器「状态寄存器请按这种方式编码」的?- 同一台 FSM,binary 与 one-hot 综合出的单元数、触发器数实测差多少?
- gray 编码在 yosys 0.9 里真的生效了吗?日志里藏着什么意外?
- 编码差异什么时候会在大状态机上放大成面积或时序问题?
先给结论卡,四个数字全部来自后文真实综合报告:
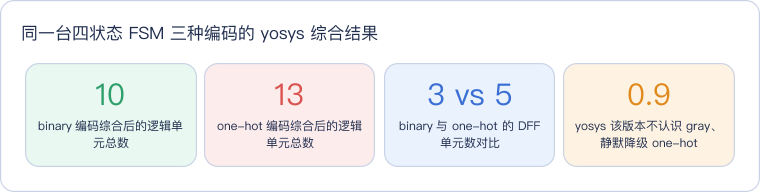
读这张卡抓两个点:第一,one-hot 比 binary 多了 3 个单元、多 2 个触发器——四状态用 one-hot 需要 4 位状态寄存器,binary 只要 2 位,多出来的触发器和译码门就是「换速度」的学费;第二,gray 那一路根本没按 gray 编码走,yosys 0.9 在日志里明说「unknown encoding gray, using auto instead」,最后落地成了 one-hot——这个坑只有看日志才会发现,下面展开讲。
一、实验设计:同一台 FSM,只改编码属性
要比较编码风格,最关键的是状态转移逻辑必须完全一致,否则单元数差异里混着设计差异。实验用一台最小但结构完整的四状态机:IDLE 等 go 信号、RUN 干一拍活、WAIT 等 go 撤销、DONE 拉高 done 输出后回 IDLE。三个模块的 case 主体一字不差,唯一区别是状态寄存器上的属性标注:
(* fsm_encoding = "binary" *)  reg [1:0] state;   // fsm_bin
(* fsm_encoding = "one-hot" *) reg [1:0] state;   // fsm_onehot
(* fsm_encoding = "gray" *)    reg [1:0] state;   // fsm_gray
注意三个模块里 state 都声明成 2 位——这是故意的。yosys 的 FSM 提取流程(fsm_extract → fsm_recode → fsm_map)会把状态寄存器识别出来,按属性指定的编码重新分配状态码,需要多少位就扩到多少位。也就是说 one-hot 那一路虽然源码写的是 2 位,综合器会把它重编码成 4 位 one-hot。这正好模拟了工程上「RTL 里写抽象状态、编码交给综合器」的标准做法——工业代码里的状态机多数只写 localparam IDLE=0, RUN=1...,真正的编码决策发生在综合阶段。
综合流程就一条命令的三种形态,对三个顶层各跑一遍 synth 全套流程后打印统计:
yosys -p 'read_verilog fsm_variants.v; synth -top fsm_bin; stat'synth 是 yosys 的通用综合脚本,内部按顺序跑二十多个 pass:进程转网表(proc)、常量折叠与死代码清理(opt)、FSM 提取与重编码(fsm)、技术映射(techmap + ABC)等。三种编码的对照关系用一张图看(红色是本次实验抓到的「坑点」):
读这张图抓住主线:编码决策集中在 yosys 的 FSM pass 一处,RTL 源码的三个模块只是属性不同;三种编码各自走完后续优化与映射后汇到 stat 报告,差异就在报告里量化。红色节点是本次实测的意外发现——gray 这一路在 0.9 版里是个假目标,下一节看日志原文。
二、yosys 实测:三轮综合与 gray 的静默降级
三轮综合真实执行实录如下(截取尾部统计汇总与判定段):
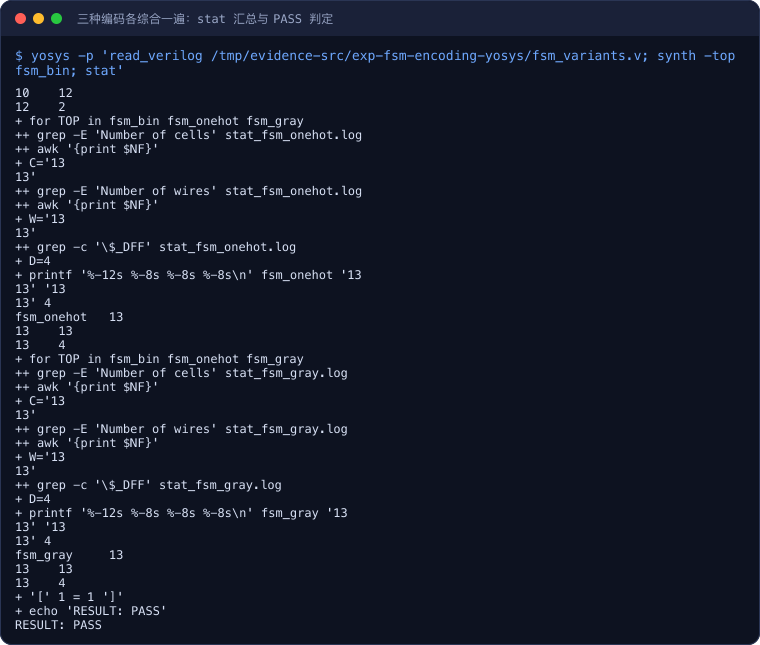
读这份实录抓两个位置:一是末尾的 RESULT: PASS,说明三轮综合都跑完且 stat 报告非空;二是汇总脚本打印的表格里 fsm_bin 一行 cells=10、fsm_onehot 与 fsm_gray 都是 cells=13、DFF 计数 2/4/4——one-hot 和 gray 数字完全相同,这已经是「gray 没生效」的第一个信号。再看 gray 那轮综合中段的原样摘录,实锤在 FSM_RECODE 这一 pass:
2.14.6. Executing FSM_RECODE pass (re-assigning FSM state encoding).
Recoding FSM `$fsm$\state$24' from module `\fsm_gray' using `gray' encoding:
  unknown encoding `gray': using auto instead.
  mapping auto encoding to `one-hot` for this FSM.
  00 -> ---1
  10 -> --1-
  01 -> -1--
  11 -> 1---
这几行的信息量很大。yosys 0.9 的 fsm_recode 支持的编码关键字里没有 gray——它直接把不认识的编码降级成 auto,而 auto 对这台四状态机的选择是 one-hot(状态数少时 auto 倾向 one-hot)。于是 fsm_gray 综合出来的电路与 fsm_onehot 逐单元一致:都是 13 个 cells、5 个 DFF(4 位状态 + 1 位 done 输出)、13 根 wire。如果工程里有人依赖「综合器会帮我做 gray 编码」来降低状态翻转功耗,在 0.9 这条工具链上会无声地落空——没有任何报错,stat 报告看起来也正常,只有 FSM_RECODE 的两行小字揭示了真相。要真 gray,得自己在 RTL 里手工指定状态码(localparam IDLE=2'b00, RUN=2'b01, WAIT=2'b11, DONE=2'b10)并放弃让综合器重编码,或换用支持 gray 关键字的更新版本。
对照之下 binary 那一路的 recode 是另一幅光景:日志里写 existing encoding is already a packed binary encoding——源码里的 0/1/2/3 天然就是紧凑二进制,综合器原样保留,2 位状态寄存器不做扩展。
三、数字怎么读:10 个单元与 13 个单元的差距从哪来
把三轮 stat 报告的关键行并排成一张表(全部数字可在 run.log 的 Number of cells 段核对):
| 编码 | 单元总数 | 连线数 | DFF 单元 | 组合逻辑构成 |
|---|---|---|---|---|
| binary | 10 | 12 | 3(2 状态 + 1 done) | ANDNOT/NAND/NOR/NOT/OAI3/XOR/MUX 各 1 |
| one-hot | 13 | 13 | 5(4 状态 + 1 done) | AND 2 / ANDNOT 2 / OR 3 / MUX 1 |
| gray(实际 one-hot) | 13 | 13 | 5 | 与 one-hot 完全相同 |
三个观察点。第一,DFF 差异就是状态位宽差异:binary 2 位、one-hot 4 位,加上共同的 1 位 done 输出寄存器,正好是 3 对 5。这是编码风格最直接、最可预期的代价——N 个状态,binary 用 log2(N) 位,one-hot 用 N 位。
第二,组合逻辑的形态完全不同。binary 那 7 个组合门里出现了 XOR、OAI3 这类复合门,因为下一状态逻辑要译码 2 位状态的组合;one-hot 是清一色的 AND/OR——每个状态的次态只依赖「当前在某位」加输入条件,译码天然扁平。这台小 FSM 上两者门数接近(7 对 7 左右,总量 binary 还少 3 个单元),但逻辑级数不同:one-hot 的次态逻辑通常一级与或就出来,binary 的译码链更深。状态数上到十几、几十个时这个差异会放大——one-hot 的组合逻辑随状态数线性增长但级数不变,binary 的译码复杂度随状态数上台阶,这正是高频状态机偏爱 one-hot 的原因。
第三,单元总数差距(13 vs 10)比触发器差距(5 vs 3)小,因为 one-hot 省掉了部分译码门。在 ASIC 流程里触发器面积远大于一个二输入门,one-hot 通常总面积更大;在 FPGA 上触发器是「白送」的(每个 LUT 后面都挂一个),one-hot 反而常常又小又快——「one-hot 适合 FPGA、binary 适合 ASIC」的经验法则就来自这个结构差异。
四、把实验往前再推一步:状态数放大后会怎样
四状态机是刻意选的最小样本——它让对照干净,但读者自然会问:状态多到 16 个、32 个时,结论还成立吗?不需要重跑实验也能从编码的数学结构推出方向,这里把推演说清楚,便于你在大状态机上做决策时心里有数。
先看触发器数。binary 编码的状态位宽是 log2(N):16 个状态 4 位、32 个状态 5 位、256 个状态 8 位,增长极其缓慢。one-hot 是 N 位:16 个状态 16 位、32 个状态 32 位,触发器数线性膨胀。而 DFF 在深亚微米工艺里是标准单元里的「大户」,一颗触发器的面积顶十几二十个二输入门——状态数一上规模,one-hot 的面积代价就从「多两个触发器」变成「多几十个触发器」,这是 ASIC 大状态机几乎不用纯 one-hot 的硬原因。
再看组合逻辑。one-hot 的次态逻辑是每个状态位一个与或项,状态数翻倍逻辑量大致翻倍,但级数不变——这是它在 FPGA 上高频优势的本质:FPGA 的 LUT 一次能算五六输入的任意函数,状态数在 LUT 扇入范围内增长时时序几乎不掉。binary 的次态逻辑是状态位的组合函数,综合器(比如本文日志里的 ABC pass)会做两级优化,但状态数多时译码逻辑的深度和面积都会上去。gray 介于两者之间:位宽与 binary 相同,但因为相邻状态只差一位,每个状态位的次态函数往往比随机 binary 分配更简单——这是综合器做「状态分配优化」时主要榨的油水。
还有一条容易被忽略的维度是复位与上电。one-hot 复位到 ...0001 需要置位端(日志里那个 $_DFF_PN1_ 就是带异步置位的触发器),binary 复位到全 0 只需要清零端;有些工艺库的带置位触发器比纯清零的更大更慢,大规模部署时这也是成本。把这些因素合起来看,「编码选择」实际是触发器数、组合级数、复位结构、可检测性四个轴上的联合优化,而不是教科书里一句「FPGA 用 one-hot」能盖住的。
五、编码怎么选:落到工程决策
把实测结论折算成选型建议:
| 场景 | 推荐编码 | 理由 |
|---|---|---|
| FPGA,状态数 < 8 | one-hot | 触发器富裕,次态逻辑一级与或,时序最好 |
| FPGA/ASIC,状态数几十上百 | binary 或 gray | one-hot 触发器数爆炸,布线也吃不消 |
| 状态寄存器跨时钟域或要降翻转率 | gray(RTL 手工编码) | 相邻转移只翻一位,单bit 变化对亚稳态和功耗都友好 |
| 安全关键(要检测非法状态) | one-hot + 偶校验类断言 | 任意位翻转立刻破坏 one-hot 不变量,易检测 |
| 小状态机、面积敏感 ASIC | binary | 触发器最少,综合器自动重编码即可 |
两条本次实验换来的实操提醒。其一,别盲信编码属性一定生效——跑完综合去 grep 一下 FSM_RECODE 段的输出,确认工具真的按你要的编码落了地;本次 gray 被静默降级就是教材级别的反例。其二,状态机编码与复位、恢复策略是连在一起的,非法状态怎么回到安全态的设计见 FSM 容错恢复设计,编码选择会影响那里的检测逻辑成本。
这一篇在知识体系里的位置
- 理论承接:有限状态机设计方法论(三段式写法与编码风格适用场景);
- 编码风格延伸:one-hot 编码与轮转调度(one-hot 在仲裁/调度里的妙用);
- 可靠性配套:FSM 容错恢复设计(非法状态检测与恢复,编码选择影响其成本);
- 工具链上手:yosys/verilator 一日上手(本篇综合命令的完整环境)。
一句话总结
同一台四状态 FSM 只改 fsm_encoding 属性,yosys 0.9 综合实测:binary 10 个单元 3 个 DFF、one-hot 13 个单元 5 个 DFF,多 2 个触发器换更浅的次态逻辑;gray 在该版本不被识别、静默降级为 one-hot——编码决策交给综合器可以,但 recode 日志必须亲眼看一眼。
实验环境
- 机器/系统:云主机 S6.4XLARGE32 16C32G / Ubuntu 22.04(eda-golden-v1 镜像)
- 工具版本:Yosys 0.9 (git sha1 1979e0b)(照抄日志头部真实输出)
- 日期:2026-10-25
- 完整命令:
bash run.sh(内部对fsm_bin/fsm_onehot/fsm_gray三个顶层各执行一次yosys -p 'read_verilog fsm_variants.v; synth -top <TOP>; stat',随后 grep 汇总各 stat 报告的 cells/wires/DFF 并打印对照表)
代码获取
三份 FSM 源码与运行脚本已同步到公开仓库:geek-doc.cn/experiments/exp-fsm-encoding-yosys,克隆后进入该目录执行 bash run.sh 即可复现本文全部结果。