bringup 冒烟:新验证环境最小用例集设计与失败定位路径
更新时间:2026-10-02。每个验证工程师都经历过这个早晨:新的 testbench 合入了主干,或者 DUT 换了大版本,或者回归场从 VCS 切到 Xcelium,你按下回归按钮,四百条用例全军覆没,日志几十万行,没有人知道该从哪一行看起。这种局面的病根只有一个:环境还没做过 bringup 冒烟,就直接上了全量回归。本站的 回归管理与失败分诊 讲的是回归稳定运行之后怎么分诊零星失败,验证环境调试方法论 讲的是单个疑难 bug 的调试套路,而这一篇回答的是更靠前的问题——环境第一次点火时,怎么用最少的用例、最短的时间确认「这台机器本身是好的」,以及冒烟失败后沿哪条路径把故障一层层剥出来。bringup 冒烟的核心思想一句话可以说完:新环境的信任是分层挣来的,每一层只花几分钟,层与层之间设准出闸门,没过闸门前绝不让更贵的用例进场。
本文要回答的问题
- bringup 冒烟和日常回归、和硅后 bringup 分别是什么关系,为什么新环境不能直接跑全量回归?
- 最小用例集按什么层次设计:从零到端到端第一笔事务,每层选哪几条用例、准出标准是什么?
- 冒烟失败后怎么分诊:编译挂、elab 挂、超时、X 传播、数据比对错,各自的定位路径怎么走?
- 超时和挂死这类「没有报错信息的失败」怎么定位,heartbeat 与超时预算怎么配合?
- 冒烟通过之后怎么进回归:准出门禁、冒烟集的长期维护、哪些坑会让冒烟集慢慢失效?
一、先分清三件事:冒烟、回归、硅后 bringup
bringup 这个词在芯片行业有两个语境,先掰清楚。硅后 bringup 指第一版芯片回片后在实验室里上电、扫 JTAG、跑诊断的那套流程,本站的 硅后 bringup 调试 和 硅后 bringup 协作 讲的就是它。本文讲的是硅前的另一半:验证环境 bringup——当你手里有一个「新的会跑代码的东西」(新搭的 testbench、大改过的 DUT、新迁移的回归场、新升级的仿真器版本),在信任它的输出之前,先用一组精心设计的小用例把它本身的正确性确认掉。
冒烟(smoke test)这个词来自硬件行业的老传统:设备修好第一次上电,看一眼冒不冒烟,冒烟就别往下修了。搬到验证领域,bringup 冒烟的定义是:一组数量极小(通常五到十五条)、运行极快(单条几分钟内)、覆盖环境关键通路(编译、连接、复位、寄存器、一条协议、一笔端到端)的用例集合,用来回答一个问题——这个环境值不值得把全量回归的算力押上去。
它和日常回归的分工用一张表说清。
| 维度 | bringup 冒烟 | 日常回归 |
|---|---|---|
| 回答的问题 | 环境本身能不能跑通 | 设计改了之后还对不对 |
| 用例数量 | 5-15 条,人工精选 | 数百到数千条 |
| 单次耗时 | 目标 30 分钟内全部跑完 | 数小时到一夜 |
| 触发时机 | 环境/DUT/工具链变更后第一时间 | 每日或每次合码定时跑 |
| 失败时动作 | 停全量回归,先修环境 | 进分诊流程逐条 triage |
| 覆盖目标 | 环境通路(编译到比对全链路) | 设计功能与覆盖率 |
这张表里最容易被忽略的是最后一行。回归关心 DUT 的功能覆盖,冒烟关心的是「环境通路覆盖」——编译器、elab、testbench 连接、时钟复位、寄存器通路、协议 VIP、scoreboard 比对,这七段通路每一段至少被一条用例踩过。功能覆盖率的玩法见 代码与功能覆盖率,那是冒烟通过之后才轮得到的话题。
为什么新环境不能直接跑回归?算一笔账就够了:假设全量回归四百条用例、跑六小时,环境里有一个「reset 释放后第一拍 monitor 采样错相位」的系统性 bug——四百条用例会全部失败,烧掉两千四百核时,然后你面对四百份失败日志,其中三百九十份是同根因的复读。而一条三分钟的冒烟用例就能把这个 bug 打出来。冒烟的本质是用小成本买「失败的可解释性」:用例少,失败模式才数得过来;用例简单,定位路径才短。
二、最小用例集:五层递进,层层设闸门
bringup 冒烟的用例集不是随便挑几条跑得快的,而是按「环境信任建立的顺序」分五层组织,每层的准出是下一层的准入。这个顺序的逻辑是:越底层的故障污染面越大,必须最先排除。
第零层,编译与 elaboration。用例就是「空跑」:编译 DUT 加 testbench,elab 到顶层,起仿真,零延时后 $finish。这一层能抓出文件列表缺漏、宏定义冲突、参数传递错误、interface 端口不匹配这类纯结构性问题。听起来太简单不值得列一层?实际项目里新环境 bringup 第一天,三成以上的时间耗在这一层——尤其是 testbench 是从别的项目移植来的时候。SystemVerilog testbench 基础 的编译单元与作用域规则,是这一层报错的第一本参考书。
第一层,时钟与复位。跑一条「只产生时钟复位、不发任何激励」的用例,检查:时钟频率相位对不对、复位极性和保持拍数对不对、复位释放后 DUT 关键状态寄存器是不是复位值。时钟复位生成器的写法如果吃不准,时钟与复位生成 有现成模式。这一层的典型事故是 testbench 的复位时序和 DUT 的上电假设不一致——DUT 假设复位至少保持 20 拍,testbench 只给了 3 拍,后面所有用例的失败都源自这里。
第二层,寄存器通路。用 UVM 寄存器模型的内建序列(uvm_reg_hw_reset_seq 加一条单寄存器读写)验证:总线接口通、地址映射对、复位值对、读写属性对。寄存器模型集成的细节见 寄存器模型集成。这一层是分水岭——寄存器能读对,说明从 sequence 到 driver 到总线到 DUT 到 monitor 到寄存器模型的整条链是通的,后面出问题大概率在数据面而不是控制面。
第三层,单接口协议冒烟。对 DUT 的每个主要数据接口各跑一条「最小合法事务」:AXI 口发一笔单拍写加一笔单拍读,流接口发一包最短帧。目标是确认 VIP 或自研 driver 的协议时序与 DUT 咬合,有效就绪握手验证 这类接口级检查在这一层直接被复用。
第四层,端到端一笔。一条用例,从最上游接口灌一笔最小业务,让数据穿过 DUT 全部主要模块,从最下游接口出来,scoreboard 比对通过。这是冒烟集的封顶用例——它过了,说明环境的激励、驱动、监测、比对四大件全部在线。
上图是整篇的骨架:五层用例像五级火箭,每层点火前检查下一级是否正常工作。工程上要给每层定硬性准出——L0 全编译零 error 才进 L1,L2 寄存器读写全对才进 L3。没闸门约束的团队几乎必然滑向「反正都跑起来了,一起跑吧」,然后回到四百份失败日志的老路上。
整个五层加起来,用例五到十五条、总耗时半小时以内是健康指标。如果冒烟集膨胀到五十条、要跑三小时,它就不再是冒烟,而是又一个没人跑得动的回归——这是第六节的坑之一。
三、失败分诊:五种失败模式各走各的定位路径
冒烟用例失败时,最大的浪费是「打开波形从头看」。不同失败模式的定位路径完全不同,先按日志把失败归类,再上路。

这张分诊图建议贴在团队 wiki 首页。下面把五条路径各自的要点展开。
路径一,编译/elab 失败。这是最好修的一类,因为工具会指行号。要点是按「第一个 error」修,不要被后面几百个级联 error 吓住——第一个未定义的宏会污染后面所有文件。新环境的高发根因:文件列表里 .f 文件路径是相对老仓库的、宏在编译命令行和文件里定义了两次且不一致、DUT 和 testbench 的参数默认值漂移。
路径二,仿真零时刻即挂(UVM_FATAL 在 build/connect 阶段)。九成的根因是 uvm_config_db::get 没拿到东西——virtual interface 的句柄是 null,第一个驱动动作就解引用空指针。定位固定三步:打开 uvm_config_db 的审计打印,核对 set 和 get 的路径字符串逐字符比对(通配符作用域的坑见 uvm_config_db 通配符作用域),确认 set 发生在 get 之前。这类故障和 DUT 毫无关系,纯粹是环境接线,修起来快,但不修会挡住一切。
路径三,超时。仿真在跑,没有 error,但永远不结束。这类没有报错信息的失败最难办,单独放在第四节。
路径四,X 传播。日志或波形里出现 X 顺着总线爬到 scoreboard。新环境里 X 的第一嫌疑人不是 DUT 的 bug,而是「该被复位初始化的东西没被初始化」:复位没打到的寄存器、testbench 自己声明了却没赋初值的变量、2 态与 4 态语义的混用。2 态 4 态与 X/Z 传播 和 RTL 仿真 X 传播语义 是这条路径的参考书。判别口诀:X 出现在复位刚释放的头几十拍,先怀疑复位时序和初始化;X 出现在跑了很久之后,才往 DUT 逻辑上怀疑。
路径五,数据比对 mismatch。scoreboard 报期望与实际不符。新环境里第一嫌疑人依然是环境而不是 DUT:monitor 的采样相位错(在数据变化的同一拍采样)、期望模型用的是老版本 DUT 的行为、字节序或位宽在 packer 里弄反了。scoreboard 乱序匹配 和 monitor 协议检查器 能帮助确认比对链路本身没问题。判别的黄金手段是「拿一条硅前已知正确环境跑过的参考波形对拍」:同一激励下新环境和老环境的接口波形逐拍比,第一处不同的拍就是分叉点。
这五条路径有个共同的世界观:新环境冒烟失败,默认怀疑环境,最后怀疑 DUT。这不是偏袒 DUT,而是贝叶斯——新环境里 testbench 的新代码量通常远大于 DUT 的改动量,先验概率摆在那里。
四、超时定位:heartbeat、超时预算与 objection 审计
超时是冒烟期最常见也最费人的失败模式。它不提供任何报错,仿真器只是安静地跑,直到你把墙钟时间耗尽。对付它要三件套配合:超时预算、heartbeat 心跳、objection 审计。
超时预算的思想是「每一层用例有自己该花的时间」。L2 寄存器读写十万拍内必须完,L4 端到端一笔两百万拍内必须完——超出预算即判失败,立刻 dump 现场。没有预算的超时用例会在回归场里挂八小时,占着 license 和机器,最后被系统管理员杀掉时还什么信息都没留下。预算数值从历史数据定:该用例正常通过耗时的三倍取整。
heartbeat(心跳)解决「仿真还活着但什么都没发生」的黑盒问题。做法是 testbench 里放一个全局监测器:每 N 拍检查一次「自上次检查以来,是否有任何接口出现过有效事务」,连续 M 个窗口静默就报 UVM_ERROR 并打印各接口最后活动时间。这套机制的具体实现见 UVM heartbeat watchdog。心跳把「无限等待」变成「有限窗口内确认死了」,把定位起点从「八小时里某一刻」收窄到「第 K 个窗口之前最后活动的那个接口」。
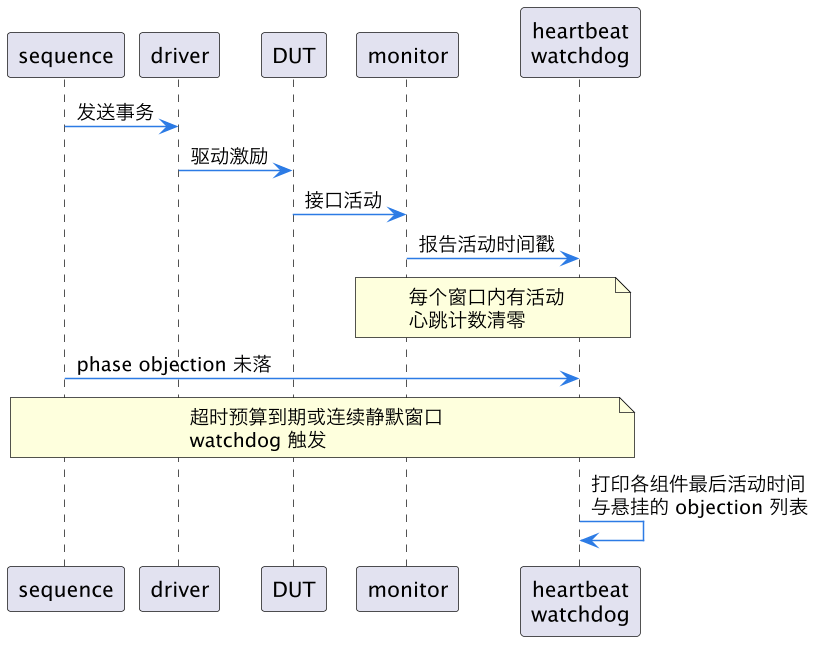
上图画的是心跳与 objection 审计的配合。UVM 的 phase objection 机制(UVM phase objection 结束机制 有完整讲解)决定了仿真何时结束:所有提起的 objection 落下,phase 才收尾。超时的一半根因是「某个 objection 提起来忘了落」——sequence 里异常路径提前返回、scoreboard 的 end-of-test 检查在等一笔永远不来的数据。所以 watchdog 触发时必须顺手 dump 当前悬挂的 objection 列表,哪个组件还举着 objection,锅就在哪个组件附近。另一半根因是「激励真的没发出去」:sequencer 仲裁死锁、driver 在等一个永远不会来的 event,这时心跳报告里「最后活动接口」指到哪儿就查哪儿。
超时定位的目标不是一次修好,而是「每次超时失败都留下足够的现场」。只要现场在,第二次同类超时就是五分钟的事。
五、准出与进回归:把冒烟变成制度的三个动作
冒烟跑通了,事情只做了一半。让 bringup 冒烟长期有效,需要三个制度化动作。
第一个动作,把冒烟集做成回归的前置门禁。回归脚本的第一段固定是:先跑冒烟集,全绿才调度全量用例,任何一条冒烟红了,全量回归不启动,直接告警到负责人。这道门禁把「环境坏了」和「设计坏了」两类故障在源头分开——环境坏时全量回归的输出是噪声,不跑反而省钱。门禁的接线方式和 回归管理与失败分诊 里的分级回归(smoke → nightly → weekly)是同一套机制,本文讲的是分级里最底下那级怎么设计。
第二个动作,给冒烟集定保鲜纪律。冒烟集是活资产,三个事件必须触发维护:环境结构变更(新加 agent、新换 VIP)要补对应层的用例;每次冒烟漏检事故(冒烟全绿但回归一上全挂)要复盘「哪层通路没被任何用例踩到」,把缺口补上;每个季度清点一次冒烟集耗时,超时就砍——把变慢的和价值低的用例降级到 nightly。第三条纪律是防膨胀的关键,冒烟集的宿命敌人就是「这条也有用,加进来吧」的日积月累。
第三个动作,把冒烟结果纳入环境交接。新成员接手环境、环境跨项目复用(垂直复用与水平复用的讨论见 UVM 环境复用)时,冒烟集就是环境的体检报告和使用说明——接手的人先跑一遍冒烟,五层全绿,说明环境在他手里是活的;哪层红了,顺着第三、四节的路径走,比读三天代码更快建立对环境的认识。
这张图把冒烟放进了回归体系的运转闭环里:变更是输入,门禁是阀门,漏检复盘和季度清点是两个反馈回路。没有反馈回路的冒烟集,一年后必然要么腐化(测不到新通路)要么膨胀(跑不完被弃用),两个回路就是防腐和防膨胀的解药。
六、高频坑清单
最后列几条反复见过的坑,算是对前五节的反向补充。
坑一,冒烟用例从回归集里「随手挑跑得快的」。跑得快的用例往往是激励简单的用例,激励简单意味着通路覆盖窄——挑出来的集合可能五条都在测同一个接口,L2 寄存器通路一条没有。冒烟集必须按第二节的五层结构设计,而不是按耗时筛选。
坑二,冒烟集里混随机用例。随机用例的失败不可复现、定位成本高,违背冒烟「失败可解释」的初衷。冒烟集全部用定向用例,随机是 nightly 的事。随机稳定性与种子管理见 随机稳定性与 seeding。
坑三,准出闸门形同虚设。L2 红了,工程师说「先跑着 L3 看看,说不定能过」——然后花两天调一个其实由 L2 故障引发的 L4 mismatch。闸门的意义就是拦住这种侥幸,它省的不是一次仿真,是定位路径被污染后的成倍排查时间。
坑四,工具链升级后不重跑冒烟。仿真器大版本升级、Python 环境变更、回归脚本重构,这些都算「环境变更」,都要过一遍冒烟。事故库里「升级仿真器后回归全挂、查了三天发现是新版对某个 LRM 灰区的解释变了」的案例,每一个都本可以被冒烟集里的 L0 编译加一条定向用例在一小时内拦住。
坑五,冒烟通过就当环境签核。冒烟确认的是「通路是通的」,不是「检查是够的」。环境checker 的密度、覆盖率的完备性,是 功能覆盖率完备指南 和 覆盖率驱动测试分诊 的地界,冒烟只是入场券,别把它当毕业证。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下「环境工程化」线上的一篇方法论,聚焦环境生命周期里最容易被跳过的一段:从「环境搭完」到「回归可信」之间的 bringup 冒烟。向上,它依赖 SystemVerilog testbench 基础 的编译与结构知识,以及 UVM sequence driver scoreboard 的组件分工——冒烟的五层用例正是沿着这条组件链逐层点火的。横向,它与 验证环境调试方法论 互补:那篇讲单个疑难 bug 的深挖,本篇讲新环境的快速分诊;失败分诊的后续动作汇入 回归管理与失败分诊 的分级回归体系。超时定位一节依赖 UVM heartbeat watchdog 与 UVM phase objection 结束机制 的机制细节。向下,冒烟通过之后环境才谈得上覆盖率的积累,接棒的是 功能覆盖率完备指南;而硅前 bringup 冒烟与 硅后 bringup 调试 共享同一套「分层点火、逐层确认」的世界观,是同一思想在两个阶段的投影。
总结
bringup 冒烟的精髓是把新环境的信任拆成五层来挣:L0 编译 elab、L1 时钟复位、L2 寄存器通路、L3 单接口协议、L4 端到端一笔,五到十五条定向用例三十分钟内跑完,层层设准出闸门;失败时先按「编译挂、零时刻挂、超时、X 传播、比对错」五种模式归类再走各自的定位路径,超时靠超时预算、heartbeat 心跳和 objection 审计三件套留现场;最后把冒烟集焊成回归的前置门禁,用漏检复盘和季度清点两个反馈回路防腐防膨胀——环境坏时绝不放行进全量,让每次失败都可解释,就是冒烟的全部价值。