Yosys 存储器推断流程:从数组写法到 $mem_v2 的判定路径
更新时间:2026-11-03。综合是什么 讲过综合的「翻译 → 优化 → 工艺映射」三步走,本篇盯住其中一条支线:你在 Verilog 里写的
reg [7:0] mem [0:15],究竟在哪一步、被哪些 pass 判定成一个存储器单元。这条线在 yosys synth 命令逐段解读 里只露出memory -nomap与memory_map两个名字,本篇把它完整展开,并在 Yosys 0.33 上用三种 RTL 写法真跑对照。第一次跑综合可配合 Yosys 综合流程报告 一起看。
本文要回答的问题
- 一个数组从 RTL 到
$mem_v2单元,中间依次经过哪些memory_*pass? memory -nomap、memory_map、memory_libmap三个名字只差几个字母,各自在哪一段、做什么?- 同样是 16×8 的数组,同步读写、异步读、异步写三种写法,
stat结果为什么完全不同? - 怎样在综合中途确认数组「还活着」,而不是已经被摊成触发器?
先给一张判定路径分区卡,数组在 Yosys 内部的四个形态与一道分流都在上面:
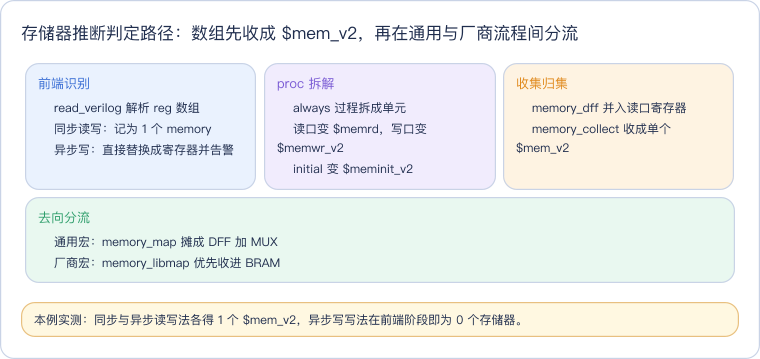
读这张卡抓住一道分水岭:判定不是发生在最后,而是在前端和 memory_collect 两处——前端先淘汰一批(异步写),memory_collect 再把剩下的读口写口收成一个 $mem_v2。之后没有任何「推断」了,只有映射:摊平或进块 RAM。
一、存储器推断在 Yosys 综合中的位置
推断夹在过程拆解与工艺映射之间。它的输入是 proc 吐出的 $memrd/$memwr_v2 单元,输出是一个(或多个)粗粒度 $mem_v2;这个单元既不是触发器也不是某家厂商的 BRAM,而是「一个具有若干读写端口的存储器」的中立描述,后面接哪种流程决定它最终变成什么。通用 synth 在 coarse 段执行 memory -nomap(只收集不展开),到 fine 段才执行 memory_map 把它摊平;synth_ice40 这类厂商宏则在两者之间插入 memory_libmap,拿库里的 BRAM 规则去匹配 $mem_v2 的端口形态。
二、memory 元命令:一串 memory_* pass 的固定顺序
memory 本身不是算法,而是按固定顺序调用一组 memory_* 子 pass 的元命令。容器内执行 yosys -p 'help memory',帮助文本直接列出调用顺序,这是 Yosys 0.33 的真实输出:
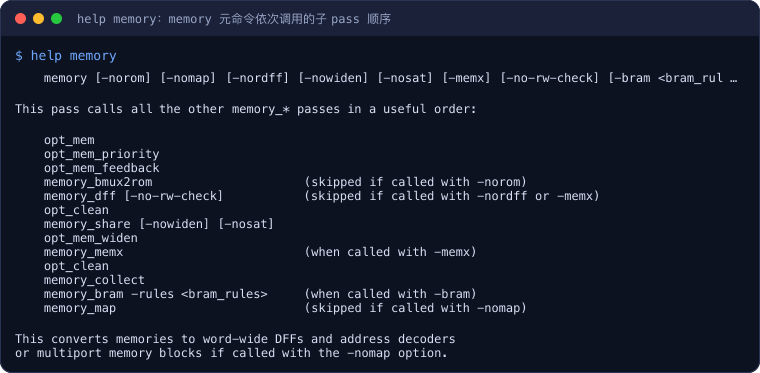
按这张顺序表,与推断最相关的是三段:
| 子 pass | 对存储器做了什么 |
|---|---|
opt_mem / opt_mem_priority / opt_mem_feedback | 化简读写使能、去掉冗余写优先级、识别读写反馈路径,发生在收集之前 |
memory_dff | 把挂在存储器读口上的触发器并进读口——同步读(rdata <= mem[addr])就是在这一步被认作读口寄存器的 |
memory_collect | 把属于同一数组的 $memrd/$memwr_v2/$meminit_v2 收集成一个 $mem_v2,这是「推断」落地的一步 |
memory_map | 逆操作:把 $mem_v2 展开成字宽触发器加地址译码,即「摊平」 |
帮助最后两行写明:加 -nomap 时跳过末尾的 memory_map,只得到多端口存储器块。这就是 synth coarse 段用 memory -nomap 的原因——coarse 段要保留存储器整体,让算术优化、厂商映射有机会把它认作 RAM;摊平留到 fine 段。其他常用开关:-nordff 跳过 memory_dff(排查同步读被误并入时用),-norom 跳过把常量多路器转 ROM 的 memory_bmux2rom,-bram <规则文件> 在收集后立刻按自定义规则试映射 BRAM。
厂商宏在同一位置多插一段。help synth_ice40 的 memory 相关行显示,iCE40 流程是 memory -nomap 之后紧跟 memory_libmap -lib +/ice40/brams.txt -lib +/ice40/spram.txt,再用 techmap -map +/ice40/brams_map.v 把匹配上的 $mem_v2 换成 SB_RAM 原语,只有没被库规则收走的残余才交给最后一行 memory_map:
    -nobram
        memory_dff [-no-rw-check]
        memory -nomap [-no-rw-check]
        memory_libmap -lib +/ice40/brams.txt -lib +/ice40/spram.txt -no-auto-huge [-no-auto-huge] [-no-auto-block]    (-no-auto-huge unless -spram, -no-auto-block if -nobram)
        techmap -map +/ice40/brams_map.v -map +/ice40/spram_map.v
        ice40_braminit
        memory_map
理解了这三层,就能纠正一个常见误解:通用 synth 跑出来永远看不到 BRAM,不是 Yosys 不会推断存储器,而是通用流程的终点本来就是摊平;$mem_v2 在 coarse 段确实存在过。
三、输入 RTL 与每一级产物:$memrd、$memwr_v2、$mem_v2
本节用三种各 16×8 的写法做对照。写法 A 是标准模板:同步写加同步读,另带一个 initial 初值:
reg [7:0] mem [0:15];
initial mem[0] = 8'h5A;
always @(posedge clk) begin
    if (we) mem[waddr] <= wdata;
    rdata  <= mem[raddr];
end
写法 B 只把读改成异步引出:assign rdata = mem[raddr];,写口仍在时钟沿。写法 C 是反模板——在组合块里异步写:always @(*) if (we) mem[addr] = wdata;。三者的分流如下:
读图看颜色:蓝色两种写法进入绿色的收集节点,红色反模板在前端就被分到红色锁存支路,根本到不了 memory_collect;绿色 $mem_v2 再进紫色下游,按通用或厂商流程二选一。对应到每一级单元,前端阶段(hierarchy 之后)数组还记在模块的 memories 统计里,A 另有一个 $meminit_v2 承载初值;proc 之后过程消失,读口写口变成独立单元;memory -nomap 之后它们合并为一个 $mem_v2。
四、推断失败与检查点
| 现象 | 检查 | 纠正 |
|---|---|---|
前端日志出现 Warning: Replacing memory \mem with list of registers | 警告在 read_verilog 阶段就打出,比任何 memory pass 都早 | 数组写法已在前端出局,改 RTL 而不是调 pass 参数;系统排错见 Yosys memory not inferred |
coarse 段已有 $mem_v2,最终却看到成片 DFF 和 MUX | 这是通用 synth 的 memory_map 正常行为,不是推断失败 | 要保留 RAM 就换厂商宏或在摊平前 memory_libmap,区别见 数组展开成寄存器排查 |
| 想映射块 RAM 却匹配不上,日志里没有 BRAM 原语 | 检查读口是否异步:异步读端口多数 BRAM 规则不收 | 改成同步读模板,具体厂商实例见 ECP5 BRAM 推断失败 |
| 不确定数组当前在哪一级 | 在 proc、memory -nomap、memory_map 后各插一个 stat | 看 memories 数、$memrd/$memwr_v2、$mem_v2、$dff 四类指标的此消彼长 |
检查时认准一条递进:Number of memories(前端数组)→ $memrd/$memwr_v2(proc 之后)→ $mem_v2(收集之后)→ $dff(摊平之后)。四者是同一存储实体在不同阶段的壳,前一级消失、后一级出现才是正常,中途哪一级数量对不上就定位到了对应 pass。
五、真跑一遍:三种写法四个断点
实验对每个模块在同一 Yosys 进程内设四个断点:hierarchy 后、proc; opt_clean 后、memory -nomap 后、memory_map; opt_clean 后,每次都执行 stat。写法 A 在后两个断点的输出最能说明推断的完整形态:
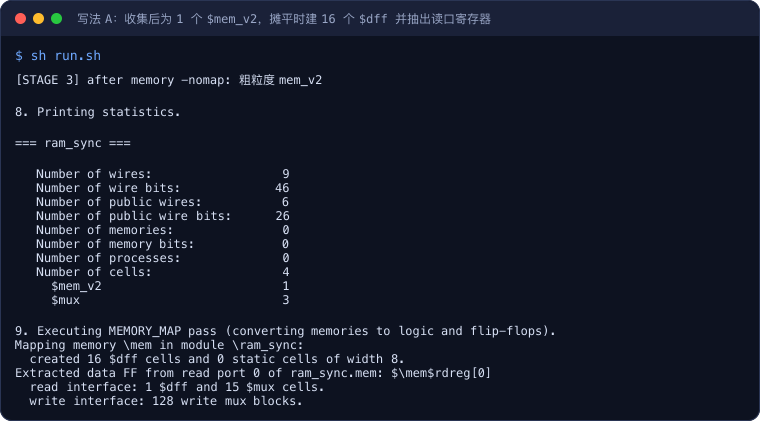
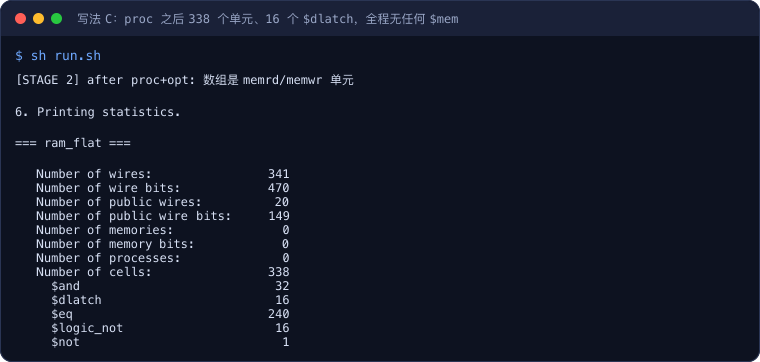
这段日志有三个细节:收集后模块只剩 4 个单元,其中 $mem_v2 一个;memory_map 报告 created 16 $dff cells——16 行各 8 位;Extracted data FF from read port 0 加上 read interface: 1 $dff,说明同步读的输出寄存器被单独认出,写口则搭出 128 个写选择块。写法 C 走的是完全不同的路径,前端告警之后 proc 又连推 16 个锁存器:
三种写法四断点汇总(单元数均取自本次 stat 实测):
| 写法 | hierarchy 后 | proc 后 | memory -nomap 后 | memory_map 后 |
|---|---|---|---|---|
| A 同步写 + 同步读 | 1 个存储器 / 128 bit,process 2,$meminit_v2+$memrd | 7 单元:$memrd、$memwr_v2、$meminit_v2、1 个 $dff | 4 单元:1 个 $mem_v2 | 323 单元:17 $dff、146 $mux |
| B 同步写 + 异步读 | 1 个存储器 / 128 bit,process 1 | 5 单元:$memrd、$memwr_v2 | 4 单元:1 个 $mem_v2 | 322 单元:16 $dff、146 $mux |
| C 组合块异步写 | 存储器 0,process 2 | 338 单元:16 $dlatch、240 $eq | 338,无变化 | 338,无变化 |
A 与 B 的差别只在一个读口寄存器(17 对 16 个 $dff),两者都成功推断;C 在前端即出局,memory 元命令对它「0 transformations」,后面再跑什么 pass 都救不回来。另外 A 的 initial mem[0]=8'h5A 在前端表现为 $meminit_v2,收集时并入 $mem_v2 的初值数据,摊平时写进对应触发器初值,日志中 0 static cells 表明初值没有额外搭出静态逻辑。
实验环境
- 机器/系统:Mac mini / macOS,Docker 容器内运行。
- 工具版本:Yosys 0.33 (git sha1 2584903a060),
geek-eda:0.3-sta镜像(yosys -V实测输出)。 - 日期:2026-11-03。
- 完整命令:
docker run --rm -v "$PWD":/work -w /work geek-eda:0.3-sta yosys -p 'help memory';yosys -p 'help synth_ice40';对ram_sync、ram_async、ram_flat三个顶层分别执行read_verilog rtl.v; hierarchy -top <top>; stat; proc; opt_clean; stat; memory -nomap; stat; memory_map; opt_clean; stat。容器外执行sh run.sh可一次性复现全部输出。
代码获取
完整源码与复现脚本位于公开仓 experiments/flow-yosys-memory-inference。在该目录执行 sh run.sh,即可在 geek-eda:0.3-sta 容器中复现帮助文本与三个模块四个断点的全部 stat。
这一篇在知识体系里的位置
- 想先建立综合整体概念 → 综合是什么;
- 想看
synth宏全部四段的逐段展开 → yosys synth 命令逐段解读; - 推断失败导致面积爆炸的系统排查 → Yosys memory not inferred;
$mem_v2已出现却仍被展开的辨析 → Yosys 数组展开成寄存器。
总结
Yosys 存储器推断流程的结论是:memory 是一串 memory_* pass 的固定编排,memory_dff 先认读口寄存器,memory_collect 再把 $memrd/$memwr_v2/$meminit_v2 收成一个中立的 $mem_v2,通用 synth 在 coarse 段用 memory -nomap 保留它、fine 段用 memory_map 摊平,厂商宏则在中间插 memory_libmap 优先匹配 BRAM;Yosys 0.33 实测三种 16×8 写法,同步读写与同步写异步读都得到 1 个 $mem_v2(摊平后分别为 323、322 个单元、17 与 16 个 $dff),而组合块异步写在前端即被 Replacing memory 告警淘汰,最终是 338 个单元、16 个 $dlatch、全程没有任何存储器单元;判定数组命运时按「memories 计数 → $memrd/$memwr_v2 → $mem_v2 → $dff」四级递进插 stat,即可定位到具体 pass。