存储器验证:前门/后门访问、memory model 与按地址记分板
更新时间:2026-09-25。片上 SRAM、缓存 tag array、FIFO 存储体是芯片里面积占比最大的部件之一。本篇面向 intermediate,讲清楚一个存储器子系统的验证环境怎么搭:两种访问通路、一个行为参考模型、一个按地址对账的记分板。寄存器抽象的前置知识见 UVM 寄存器模型端到端集成,存储体内建自检验证见 MBIST 存储器内建自测。
本文要回答的问题
- 前门访问和后门访问分别是什么,存储器验证里为什么两种都要?
- memory model 要建哪些行为,scoreboard 怎么按地址比对才不会误报?
- 同址读写竞争、字节使能、上电初值与 X 态这些边角怎么覆盖?
一、前门与后门:两条访问通路
前门(front-door)访问就是激励走 DUT 的真实接口:sequence 发出总线事务,经过 decoder、仲裁、时序控制,最终在时钟沿写入存储阵列或读出数据。它验证的是完整的数据通路与时序,是签核依据,但慢——填一块 64KB SRAM 要逐拍发上万次事务。
后门(back-door)访问绕过一切协议,用 SystemVerilog 层次引用直接碰 RTL 里的存储变量:
// 后门写:零时间、不占总线
function void mem_backdoor_write(bit [31:0] addr, bit [31:0] data);
  tb.dut.u_sram.mem[addr[15:2]] = data;
endfunction
// 后门读
function bit [31:0] mem_backdoor_read(bit [31:0] addr);
  return tb.dut.u_sram.mem[addr[15:2]];
endfunctionpeek(读)和 poke(写)在仿真时刻立即生效,不产生任何总线活动。它的用途是初始化与加速:测试开始时一键灌入已知图案,省去几千拍的前置写;结束时一键回读整片,做全空间内容检查。代价是它不验证任何真实硬件通路,所以功能检查必须以前门为准,后门只负责「布景」和「抄底」。
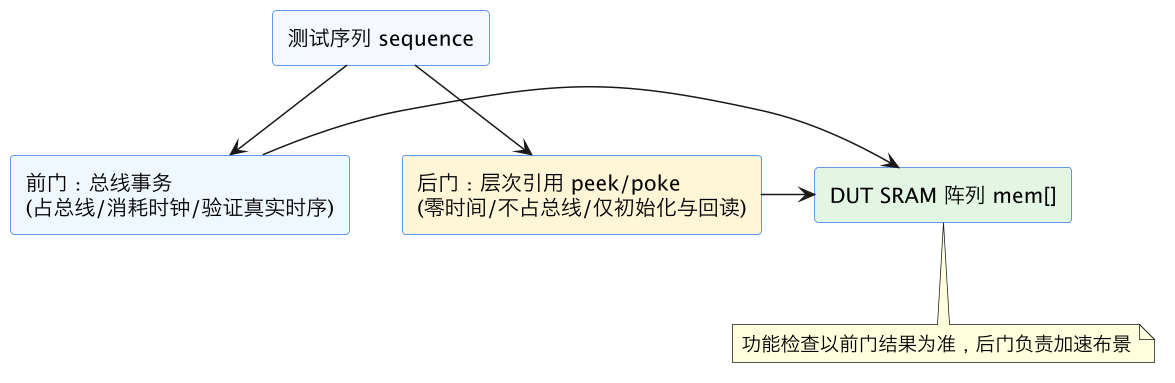
上图的两条通路在环境里并存:前门流量做功能验证,后门在测试边界做快速预置和全空间抄底。两条通路写同一个阵列,这正是竞争问题的来源,第四节展开。
二、memory model:建行为,不建晶体管
参考模型不需要(也不应该)复刻 SRAM 电路,只需要建模对功能验证有意义的行为:
| 建模项 | 说明 | 不建模的原因 |
|---|---|---|
| 地址译码 | 字地址、行选择、越界/保留地址响应 | 译码由真实 RTL 验证 |
| 读写语义 | 同步读的延迟拍数、写穿透还是写回 | —— |
| 字节使能 | 按 byte lane 做部分写合并 | —— |
| 初值/X 传播 | 上电未初始化位读出 X 的策略 | 物理初值在门级 X-prop 验证 |
| ECC/奇偶 | 编码、可纠正/不可纠正错误注入 | 纠错码本身算法可单测 |
模型通常就是一个关联数组 bit [31:0] ref_mem[bit [15:0]],外加一个与 RTL 一致的读写任务。用关联数组而不是定宽数组,是因为很多设计的存储容量远超仿真要访问的范围,关联数组只为被碰过的地址分配存储,仿真内存占用小,还能天然区分「没写过」和「写过 0」:地址在数组里不存在,就意味着这一格从未被初始化。关键纪律:模型只响应总线上真实发生的前门操作,后门 poke 改变硬件时要同步喂给模型(或干脆让后门任务同时写两边),否则模型和 DUT 的初始集合不一致,后面全是误报。
模型还要显式记录每个地址的「最后写入时间/事务号」。同址竞争排查时,日志里只打期望值和实际值不够,把期望来自哪一笔写、实际读发生在哪一拍一起打出来,才能快速判断是 RTL 转发逻辑错了,还是模型采样拍点错了——存储器误报里有一半最后查出来是环境自己的拍点问题。
三、scoreboard:按地址对账,不是按事务流水
存储器记分板和普通协议记分板的差别在于对账粒度。普通记分板拿「期望事务」对「实际事务」逐条比;存储器存在同址多次写、读不改变状态,正确的做法是以地址为 key 的内容对账:
- monitor 抓到前门写事务,按真实的字节使能更新
ref_mem[addr]; - 抓到读事务,在数据真正返回的那一拍(不是请求拍)取
ref_mem[addr]与返回数据比对; - 测试结束时,后门回读整片 DUT 阵列,与
ref_mem全量比对一次,覆盖「从没被读过的脏地址」。
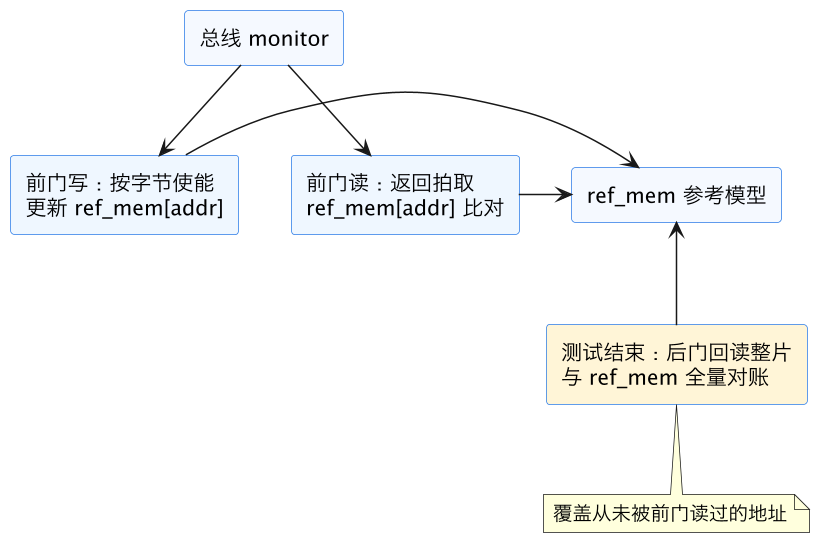
读比对的拍点是高频翻车点:请求当拍模型还不知道这次读会不会被 stall、retry,必须在 monitor 观测到实际返回数据时采样期望,否则流水线深一点就满屏误报。
四、边角:竞争、字节使能、初值与 X
同址读写竞争。 同一拍(或流水线重叠窗口内)对同一地址又读又写,RTL 的行为取决于设计定义:读旧值(read-before-write)还是读新值(write forwarding)。先从微架构规范确认预期,把规则固化进模型的读采样点;再用受约束随机把同址访问的时间间隔压到 0/1 拍,专门打这个窗口。另外后门 poke 与前门写若在同一仿真时刻交错,也会产生竞争——约定后门只在无总线活动的相位使用。
字节使能。 部分写必须按 lane 合并:ref_mem[addr] = (old & ~wstrb_mask) | (wdata & wstrb_mask)。漏掉这条,凡是 byte/halfword 写之后的 word 读全部误报。还要确认 wstrb 与 wdata 的字节序约定(大小端)在模型和 RTL 之间一致,跨 IP 复用模型时这是隐蔽的错配源。建议直接收集 wstrb 的功能覆盖:全 1、全 0、walking 1、相邻 lane 组合,并和「访问粒度 × 地址低两位对齐」交叉,确保非对齐访问的每一种落点都被打过。
初始化与 X 检查。 SRAM 上电内容是未知的,读出 X 在 RTL 仿真里本身合法。两种工程策略:一是设计上有 init/clear 机制,测试先做初始化再读写;二是模型对「从未写过的地址」标记 unknown,读到时允许 X 而一旦写过就必须是确定值。测试结束阶段还要做反向检查:该是 X 的地方不许被意外写成确定值,写过的地方不许残留 X,这能逮住复位接线遗漏和位宽截断。门级阶段配合 X-prop 开关,让 X 真正通过逻辑传播,避免 RTL 乐观仿真把问题藏掉。
五、UVM register model 的后门挂钩
存储器映射的配置寄存器区可以直接复用 UVM 寄存器模型端到端集成 的机制给存储器访问挂后门:在 uvm_reg_block 里用 add_hdl_path 声明阵列的层次路径,uvm_mem 描述存储器块的地址范围与组织。之后 mem.peek()/poke() 走 HDL 路径,mem.read()/write() 经 adapter 走总线,两种路径还能用寄存器内建序列交叉验证一致性。HDL 路径在不同仿真层级(block 级与 SoC 级层次前缀不同)要用 config 分层覆盖,写死路径是集成阶段最常见的失败。大规模存储阵列还可以经 DPI 从 C 侧或文件直接灌图案,思路与后门一致:加速布景,签核仍以前门为准。
这一篇在知识体系里的位置
存储器验证处在 block 级验证与 DFT 的交界:功能侧的前门/前门对账与 UVM 记分板与参考模型事务对齐 同源;制造缺陷侧的阵列冗余、行列冗余修理由 MBIST 存储器内建自测 覆盖;X 态处理与门级仿真的 X-prop 设置见 门级仿真、SDF 与 X 传播。
总结
存储器验证用前门总线事务验证真实时序、用后门 peek/poke 零时间初始化和全空间回读加速;memory model 只建译码、读写语义、字节使能与 X 策略等功能行为;scoreboard 以地址为 key,写按 lane 合并、读在返回拍比对、结束时全量对账,再用同址竞争、字节使能组合和初值/X 检查补齐边角。