推理请求抢占调度:优先级、KV cache 换出与饿死防护的完整机制
更新时间:2026-10-04。前面 continuous batching 调度器 讲过请求怎么拼成动态批次、每轮迭代怎么插入新请求;KV cache 推理显存 讲过 KV cache 怎么吃显存、怎么按页管理。但这两篇都回避了一个尴尬场景:批次越拼越大,KV cache 页终于分配不出来时,调度器拿谁开刀? 答案就是推理请求抢占调度(preemption)——把某个正在跑的请求踢出 GPU,腾出显存给别人。本篇把抢占的触发时机、被踢请求的两种处置路径(换出与重算)、优先级怎么排、以及低优先级请求如何不被饿死讲清楚。
本文要回答的问题
- 抢占在什么时刻被触发,调度器按什么顺序挑牺牲品?
- 被抢占的请求走「换出(swap)」和「重算(recompute)」两条路,代价各是什么?
- 多租户场景下请求优先级怎么参与调度,高优先级能不能直接插队?
- 抢占会不会让低优先级请求永远轮不上,饿死防护怎么做?
- 工程上怎么配置和观测抢占行为,抢占频率多少算异常?
一、抢占为什么存在:continuous batching 的显存缺口
抢占不是功能,是事故预案。continuous batching 下,调度器每轮迭代都允许新请求进批、老请求出批,batch 大小随流量波动。每个在批请求都占着一份 KV cache 页,请求越多、上下文越长,显存水位越高。decode 阶段每轮每个请求还要再追加一页或几分之一页的 K/V。当某轮迭代调度器想给请求分配新 KV 页、而块池里已经没有空闲块时,只有三条路:拒绝新请求(排队等)、缩减 batch、或者把已在跑的某个请求踢出去。
第三条路就是抢占。为什么不用前两路?新请求排队是常规手段,但已在跑的请求如果全都还很长寿,水位就永远降不下来;缩减 batch 本质是停掉部分请求,和抢占一样伤人,还没有「以后还能恢复」的退路。抢占的设计目标是:踢出去不是终止,是挂起——把请求状态保存下来,等显存缓过来再恢复执行,对上层表现为 TTFT(首 token 时延,time to first token)或 TPOT(每 token 时延,time per output token)的一次毛刺,而不是请求失败。
上图是 vLLM 一脉调度器的标准决策流。注意两个细节:一是抢占只在分配失败时发生,不是周期性的;二是牺牲品的选择顺序——vLLM 默认按「最后到达的先被踢」(后进先出),直觉上是因为晚来的请求积累的 KV 少、已投入算力少,踢它的浪费最小。引入请求优先级后,顺序变成「优先级最低的先踢,同优先级里晚到的先踢」。
二、swap 与 recompute:被踢之后走哪条路
被抢占的请求,它的 KV cache 是一笔不小的资产——一个 8K 上下文的请求在 7B 模型上可能占几百 MB。怎么处理这笔资产,决定恢复时要付多少钱。
换出(swap-out):把这份请求的 KV 页从 GPU 显存整体拷贝到 CPU 内存钉住区(pinned memory),请求进换出队列。恢复时再做一次反向拷贝,KV 原样回来,decode 从断点继续,不需要任何重算。代价是两趟 PCIe/NVLink 传输和一块常驻 CPU 内存预算。
重算(recompute):KV 页直接释放,请求只保留 prompt 和已生成的 token 文本。恢复时把「prompt + 已生成部分」当作一个全新的 prefill 重新跑一遍,KV 从零重建。代价是一整个 prefill 的算力——对长上下文来说这可能是几千 token 的 prefill,比它这辈子 decode 花的算力还多。
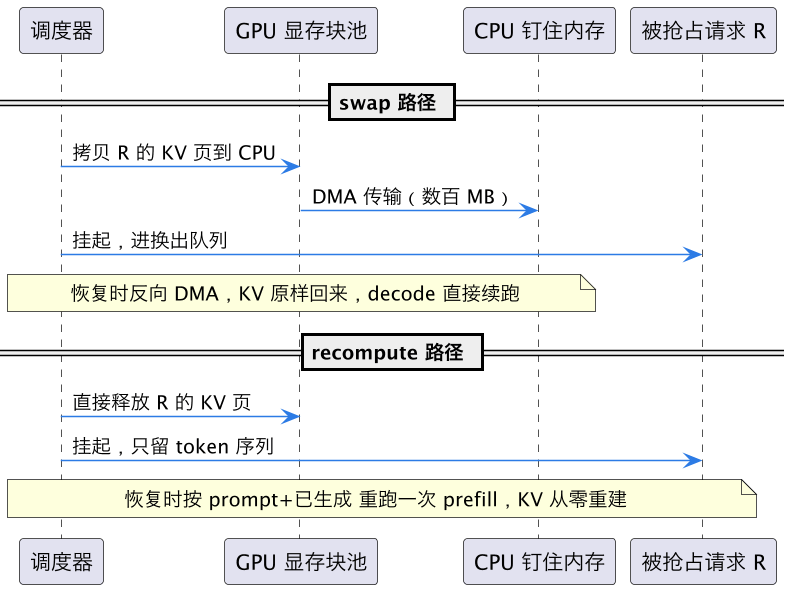
时序上的差异一目了然:swap 的恢复开销是「两次传输」,recompute 的恢复开销是「一次完整 prefill」。vLLM 早期版本同时实现了两条路,实测下来 recompute 几乎总是更划算,原因有三。其一,H100 上 prefill 吞吐动辄上万 token/s,重算一个 4K 上下文的 KV 只要几百毫秒,而几百 MB 的 KV 走 PCIe 3.0 往返也要同量级时间,还占着 CPU 内存;其二,NVLink 直连 GPU 间传 KV 很快,但 swap 走的是 GPU-CPU 通道,带宽低一个数量级;其三,swap 要求预留 CPU 内存池,这对本就紧张的 serving 节点是额外容量规划负担。于是 vLLM V1 干脆砍掉了 swap,只保留 recompute——这也是 vLLM V1 调度器设计 里简化状态机的重要一环。
| 维度 | swap(换出) | recompute(重算) |
|---|---|---|
| 恢复时做什么 | KV 从 CPU 拷回 GPU | 全序列重跑一次 prefill |
| 主要开销 | 两趟 DMA 传输 | 一次 prefill 算力 |
| 额外资源 | 常驻 CPU 钉住内存池 | 无 |
| 长上下文表现 | 传输时间随 KV 线性涨 | prefill 算力同样线性涨,但 GPU 算得比 PCIe 搬得快 |
| 实现复杂度 | 两套内存管理、传输流水线 | 只需保留 token 序列 |
| 代表实现 | vLLM V0、早期 Orca | vLLM V1 唯一路径 |
三、优先级怎么进来:多租户与 SLO 分层
默认的「后进先出」抢占对单租户够用,多租户 serving 就不行了:付费客户的交互请求和内部批量评测请求跑在同一集群,显存紧张时踢谁显而易见。引入优先级后,抢占选择变成两级排序:先按优先级,低优先级先被踢;同优先级内部仍按到达时间,晚到的先被踢。
优先级还影响另一面——准入。等待队列里的请求按优先级出队进批,高优先级可以插到低优先级前面(但不能打断已在跑的高优先级请求之外的人,除非触发抢占)。这与 SLO 感知调度 的思路衔接:优先级本质是 SLO 分层的静态近似,更精细的做法是按「剩余 SLO 余量」动态计算调度分,谁快违约谁先跑。
上图里最容易被误读的一点是:高优先级不等于免死金牌。如果整个批次全是高优先级请求、显存还是不够,照样有人要被踢,只是轮到同级里最晚到的那个。优先级解决的是「谁先牺牲」,不解决「显存不够」本身——那是 serving 容量规划 要回答的问题。
四、饿死防护:被踢三次的请求不能踢第四次
抢占引入了一个隐蔽的公平性问题。低优先级请求的命运可能是:进批跑了两轮,显存紧张被踢;恢复进批又跑两轮,又来一波高优先级流量,再被踢。每次重算都要白付一次 prefill,进度却几乎为零——这就是饿死(starvation)。对 recompute 路径它尤其贵:踢一次烧一次 prefill 的算力,集群在「反复重算同一批低优先级请求」上空转。
工程上的防护手段有几种,可以叠加使用。第一种是抢占计数加龄:记录每个请求被抢占的次数,抢占选择时对「被踢过 N 次」的请求给予保护(等效于动态提升其优先级,即 aging 机制,操作系统调度的经典手法)。第二种是准入控制兜底:当块池水位低于阈值时直接暂停低优先级请求的准入,让在批的先把活干完,从源头减少抢占发生。第三种是分离部署:离线批量流量走独立实例或独立优先级队列,配合 分离式 serving 集群 的弹性扩缩,物理上避免两类流量抢显存。
观测上,「每千次迭代发生多少次抢占」和「单请求平均被抢占次数」是两个必须进仪表盘的指标。健康状态下抢占应该是偶发事件;如果抢占率持续为正且集中在低优先级请求上,说明容量欠配,靠调度技巧是救不回来的。这一点和 LLM 推理可观测体系 里的水位告警一脉相承。
这一篇在知识体系里的位置
本篇是 serving 调度子系列里讲「显存兜底」的一篇:上游是 continuous batching 调度器(抢占发生的舞台)和 KV cache 推理显存(被争夺的资源本身);同层对照 vLLM V1 调度器设计(为什么 V1 只留 recompute)、SLO 感知调度(优先级的动态化版本)、chunked prefill 与 PD 分离(另一种减少显存尖峰的思路);下游是 serving 容量规划(让抢占根本不发生)。
对读者的落地建议:单租户小规模部署用默认「后进先出 + recompute」即可;多租户必须显式配置优先级并加抢占计数防护;抢占率进监控,持续异常就扩容,别指望调度算法变魔术。
总结
推理请求抢占调度是 continuous batching 在 KV cache 显存耗尽时的兜底机制:调度器按「优先级最低、同级最晚到达」挑牺牲品踢出 GPU,被踢请求走 swap(KV 搬到 CPU,恢复时拷回)或 recompute(丢弃 KV,恢复时重跑 prefill)——实测重算几乎总是更划算,vLLM V1 已只保留它;多租户下优先级既管准入排序也管牺牲顺序,但防不了同优先级内部的反复牺牲,需要抢占计数 aging、低水位准入控制或流量分离来防饿死;抢占率本身是最诚实的容量告警,持续非零就该扩容而不是调参。