DDR 训练验证:write leveling 与 read DQS gating 的 PHY 训练序列检查点全解
更新时间:2026-10-02。DDR 训练验证是内存子系统验证里最不像「功能验证」的一块:它验的不是数据对不对,而是「PHY 能不能自己把时序练出来」。DDR3 引入 fly-by 拓扑之后,每个 DRAM 颗粒看到的时钟相位都不同,PHY 必须在上电后自动完成 write leveling(写均衡)、read DQS gating(读 DQS 门控)、read/write eye training(读写眼图训练)一整套训练流程,任何一步失败,表现都不是一个干净的协议错误,而是「偶发数据翻转、压力测试下才出错、换一批颗粒就复发」这种最折磨人的硅后症状。站内的 SDRAM 初始化与刷新验证 讲了 MR 寄存器配置与刷新时序怎么验,硅后 bringup 调试 讲了上电失败的分诊思路,本文聚焦两者之间那块常被粗略带过的区域:DDR PHY 训练序列本身怎么在硅前验透。核心立场一句话:训练序列是一个有严格先后依赖、每步都有明确可观测检查点的状态机,验证的任务不是「跑通一次训练」,而是给每个训练步的入口条件、成功判据、失败后果各钉一条可执行的检查。
本文要回答的问题
- 为什么 DDR3 之后必须有 write leveling,fly-by 拓扑到底把什么问题推给了 PHY?
- read DQS gating 的本质是什么,为什么它是训练序列里最容易失败的一步?
- 完整训练序列(write leveling → gate training → read/write eye training)各步的入口条件与成功判据是什么?
- 验证环境里用什么手段观测训练结果:DFI 接口信号、PHY 寄存器、scoreboard 各自能抓到什么?
- 训练类 bug 的典型失败模式有哪些,怎么用断言和定向用例在硅前把它们逼出来?
一、为什么需要训练:fly-by 拓扑把时序问题推给了 PHY
先理解训练存在的理由。DDR2 时代地址/命令/时钟走线用 T 型拓扑,时钟到每个颗粒的飞行时间(flight time)尽量做得相等,板级靠等长布线解决对齐。DDR3 起地址/命令/时钟改用 fly-by 拓扑:一条链串过所有颗粒,信号像班车一样一站一站到,第 0 个颗粒和第 7 个颗粒看到的时钟沿差可能超过一个时钟周期。好处是走线简单、信号完整性好;代价是时钟与 DQS(数据选通,写方向由控制器发出、读方向由 DRAM 发出的源同步选通信号)在每个颗粒处的相位关系各不相同,等长布线再也救不回来。
write leveling 解决的就是写方向的这个问题:控制器需要知道「DQS 相对时钟该延迟多少」,才能让写数据在 DRAM 端满足建立/保持时间。做法很巧:训练时控制器把 DQS 从 0 开始一格一格扫延迟,DRAM 在 CK 上升沿采样 DQS 并通过 DQ 线把采样结果回传;当回传值从 0 跳到 1,说明 DQS 沿刚刚越过 CK 沿,这个边界就是目标延迟。read DQS gating 解决读方向的对偶问题:读数据是 DRAM 随 DQS 一起送回控制器的,但 DQS 平时是三态的(不驱动),PHY 必须开一个「门控窗口」只在校验突发到达时让 DQS 进采样逻辑——窗开早了抓到三态噪声,开晚了砍掉前导(preamble),所以训练要找到这个窗口的正确位置。理解这两步的物理动机,是后面写检查点的前提:SVA 断言实践 里反复强调的「断言要锚在设计的真实不变量上」,在训练验证里的具体含义就是——每条训练检查都必须能翻译成一句物理上可解释的话。
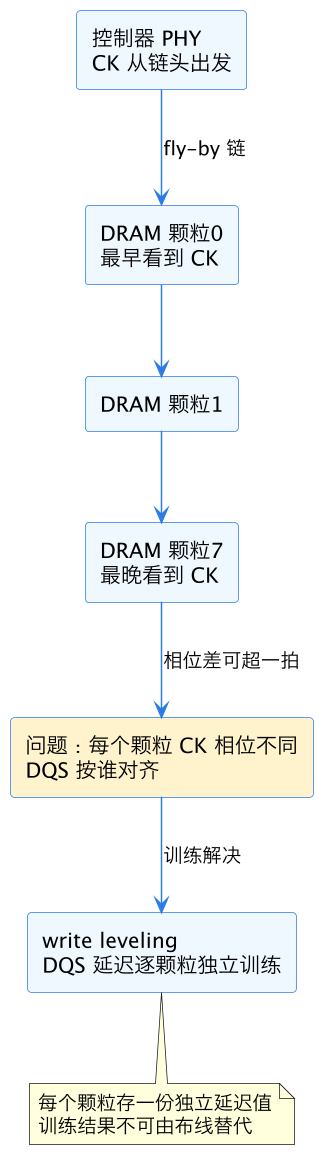
上图把 fly-by 的后果画清楚了:延迟是逐颗粒、逐字节通道的,这意味着训练结果是一组几十个参数(每字节通道一份),验证不能只验「训练完成了」,还要验「每一份参数都落在了物理上合理的区间」。一个颗粒的 write leveling 值和相邻颗粒差出半个时钟,十有八九是训练算法踩到了边界——这类缺陷单看任何一步都「成功」了,只有把全部训练值拉出来做横向一致性检查才看得见。
二、训练序列全景:严格先后依赖的状态机
一次完整的 DDR PHY 上电训练大致是这条链:初始化与模式寄存器配置(这步的验证要点见 SDRAM 初始化与刷新验证,本文不重复)→ write leveling → read DQS gating(常叫 gate training)→ read eye training(用已知 pattern 扫读延迟找窗口中心)→ write eye training(写方向 Vref 与延迟二维扫描)。注意这个顺序是硬依赖,不是建议:gate training 依赖写方向已经能可靠写进 DRAM(要先能写,才能构造读回校验的场景);read eye training 依赖 gate 已经把窗口框在了正确拍内,眼图扫描只是在拍内找最佳相位。验证环境的第一步是把这个依赖图显式建模——训练状态机本身往往就是 DUT 的一部分(PHY 训练固件或 RTL 状态机),它的每个状态都有「进入条件」和「退出判据」。
每步的入口条件与成功判据值得逐一钉死。write leveling 入口:MR1 已写使能 write leveling 模式、ODT 配置正确(回传路径靠 DQ,阻抗不对回传值全错);判据:每字节通道找到一个 0→1 边界,且边界位置与相邻通道的差值在工艺允许范围内。gate training 入口:write leveling 完成且写路径已用简单 pattern 验证可写;判据:对已知 pattern 的读回,DQS 门控位置能稳定框住前导加全部 burst 拍,扫延迟时通过/失败分界清晰(分界模糊说明窗口骑在噪声上)。read/write eye training 入口:gate 完成;判据:二维(延迟 × Vref)扫描得到的通过区域连续、面积超过规格书给出的最小眼,训练算法选定的中心点离通过区边缘有足够 margin。
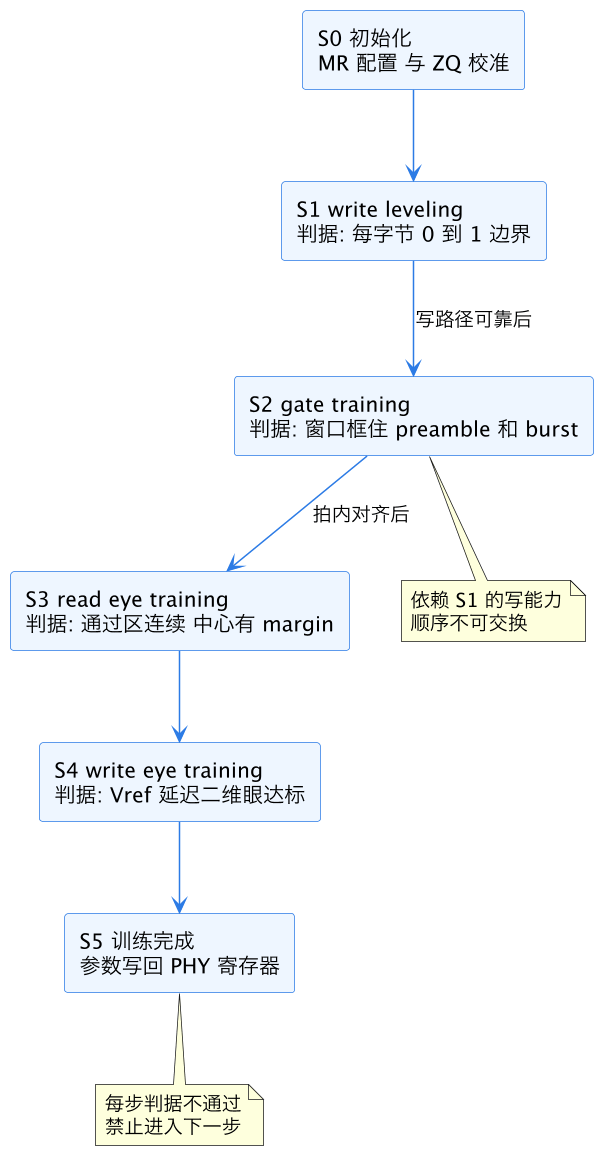
上图是训练状态机的骨架,也是验证计划的一级目录:每个状态配一组定向用例,每条转移配一条「前置状态判据不通过则不允许转移」的断言。很多训练 bug 的本质就是状态机在异常条件下提前转移——write leveling 某字节通道没找到边界,算法却超时后带着默认值进了 gate training,后面所有步都在错误地基上盖楼。这类 bug 用随机测试几乎打不到,因为随机激励不会专门去构造「某个通道边界找不到」的场景;必须靠定向故障注入(在参考模型里把某字节通道的回传强制钳位)配转移断言来验。
三、观测手段:DFI 信号、PHY 寄存器、scoreboard 三线合流
训练过程大部分发生在 PHY 内部,验证的难点首先是「看得见」。三条观测线各有分工。第一条线:DFI(DDR PHY Interface,MC 与 PHY 之间的标准接口)信号。DFI 上能看到训练期间 MC 侧发起的读写、以及 PHY 侧的状态反馈(如 dfi_init_complete、训练相关握手)。在训练各步的窗口内对 DFI 做协议断言,可以确认「训练状态下没有正常流量漏进来」「训练完成后 init_complete 才拉起」。第二条线:PHY 训练结果寄存器。训练完成后每个字节通道的 write leveling 延迟、gate 位置、read/write 眼中心都落在 CSR 里,验证环境读回这组值做两类检查——范围检查(每份参数在物理合理区间)和一致性检查(相邻通道、相邻颗粒的参数差在阈值内)。第三条线:数据通路 scoreboard。训练完成后跑一段带压力的正常流量,用 存储后门 scoreboard 的方法做端到端数据比对——训练参数哪怕只差一格,在电压温度角的仿真模型下就会表现为数据通路偶发比对失败。
断言落在哪条线上有讲究。时序性的检查(窗口、握手、状态转移)用 SVA 写在 DFI 和训练状态机接口上;数值性的检查(参数范围、通道间一致性)不适合断言,放在 scoreboard 或 UVM check 阶段用软件逻辑做——UVM sequence driver scoreboard 里的组件分工在这里直接适用:断言管「行为形状」,scoreboard 管「数值合理性」。两类检查混用是最常见的环境缺陷:把范围检查硬写成 SVA 会导致断言里塞满魔法数字,模型一换工艺参数全要重写;把状态转移检查放进 scoreboard 又会丢掉精确的拍级时序语义。
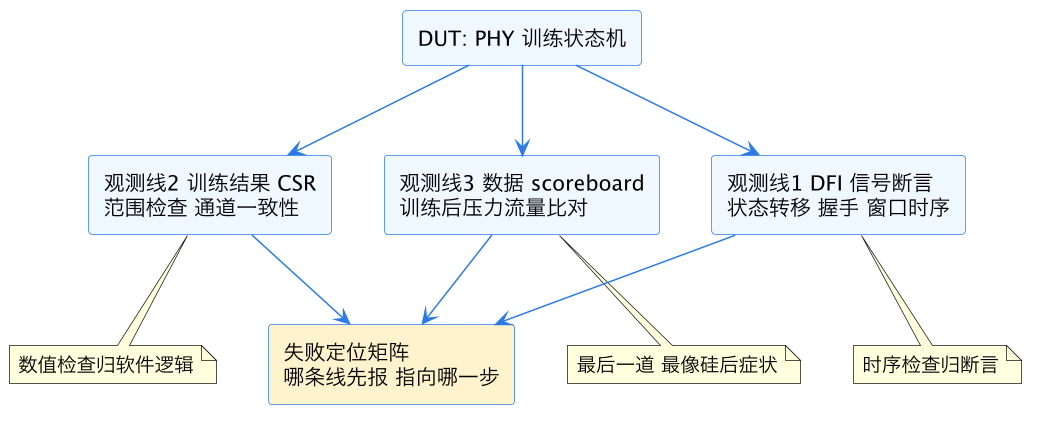
上图三条线的报障顺序本身就是定位工具:DFI 断言先响,问题在状态机控制;CSR 检查先响,训练算法或模型有问题;只有 scoreboard 响而前两条静默,多半是参数 margin 不足——训练「成功」了但成功得很勉强。这个分诊逻辑和 覆盖率驱动测试分诊 的思想一致:观测点的布设要服务于失败时的归因路径,而不只是通过时的确认。
四、典型失败模式与定向逼错用例
把训练类 bug 按根源归四类,每类给出硅前逼出它的方法。第一类:状态机提前转移。前面已讲,靠故障注入加转移断言。第二类:边界条件遗漏。训练算法对「找不到边界」的通道处理不一致——有的实现钳到最大延迟,有的保持默认值,有的报错,而规格根本没写清楚。逼错方法:构造极端拓扑的板级模型(颗粒数最少和最多、走线最短和最长),让训练在参数空间四角各跑一遍,四角是最容易踩到「找不到边界」分支的位置。第三类:训练与正常流量的交接缝隙。init_complete 拉起前后是否有命令被丢、自刷新进入期间训练参数是否被保存、频率切换(DDR4 的 gear-down、LPDDR 的 FSP 切换)后参数要不要重训——这类缝隙 bug 在单步训练验证里完全看不到,必须把训练放进 性能验证 那种带真实流量模式的长回归里才暴露。第四类:模型与环境错位。训练验证高度依赖 DRAM 行为模型(VIP 或厂商模型),模型本身的 write leveling 回传时序如果不符合 JEDEC 规范,训出来的结果是「模型和 PHY 一起错但互相匹配」,硅后换真颗粒立刻翻车。对策是模型侧也要验证:用独立的 JEDEC 协议检查器(参考 SVA checker 库复用 的组织方式)挂到模型接口上,确认模型的回传行为本身合规。
定向用例清单上,每个训练步至少要有:正常路径一条(参数落在标称区间)、每个故障注入点一条(回传钳位、边界缺失、超时)、交接场景若干(训练完成后立即高频读写、训练中插入复位——这条最容易翻车,很多实现对「训练中途复位」没有定义好的恢复路径)。回归组织上把训练用例标记为独立桶,训练参数的 CSR 快照作为用例产出存档,跨回归对比参数漂移——同一份 RTL 同一模型,训练参数不该跑一天变一次,变了就是非确定性来源混进来了(X 传播、异步采样),要立刻查。
五、硅前验证的边界:哪些注定留给硅后
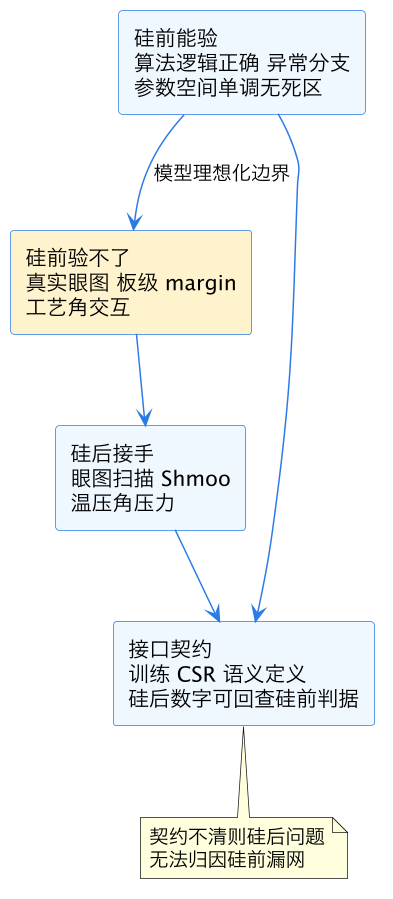
诚实地说,训练验证有硅前够不着的部分。真实的眼图形状由封装、走线、过孔、颗粒工艺共同决定,硅前的 DRAM 模型和 PHY 延迟模型都是理想化的——你能验「训练算法在合理信道下找到合理解」,验不了「在某块具体板子上眼图 margin 够不够」。所以硅前的正确目标是两件事:算法逻辑正确(每个状态转移、每个判据、每个异常分支都验过),以及参数空间覆盖(训练值扫遍合理范围时算法行为单调、无死区)。板级 margin 验证交给 硅后 bringup 调试 的眼图扫描与 Shmoo 测试。硅前硅后的分工想清楚了,验证计划才不会两头都半吊子:硅前别去拟合具体信道(那是在给模型镀金),硅后别去追状态机逻辑 bug(那是硅前漏网)。两边唯一的接口是训练参数 CSR 的语义定义——硅后调试拿到的每一个数字,都要能回查到硅前验证里对应的范围判据。
这一篇在知识体系里的位置
本篇属于 chip-design/verification 目录下「接口与存储协议验证」线,与 SDRAM 初始化与刷新验证 构成 DDR 验证的上下半场:那篇管「配置对不对」,本篇管「时序练不练得出来」。方法基础上,断言写法承接 SVA 断言实践 与 SVA checker 库复用,环境组件分工复用 UVM sequence driver scoreboard,数据比对策略沿用 存储后门 scoreboard。横向,训练完成后的流量压力验证衔接 性能验证;向后,硅前够不着的眼图与板级问题交棒给 硅后 bringup 调试。
总结
DDR 训练验证的要点是把 PHY 上电训练当成一个带严格先后依赖的状态机来验:write leveling 用 DQS 扫延迟找 CK 边界解决 fly-by 拓扑的逐颗粒相位差,read DQS gating 为三态的读选通找正确的门控窗口,read/write eye training 在拍内找眼图中心——每步都有明确的入口条件与成功判据,验证环境用 DFI 断言看状态转移、用 CSR 检查看参数合理性与通道一致性、用 scoreboard 做训练后压力比对,三线报障顺序即是定位路径;状态机提前转移、边界遗漏、训练与流量交接缝隙、模型与规范错位是四大失败模式,靠故障注入加定向用例硅前逼出,而真实眼图 margin 诚实留给硅后,两边用训练 CSR 的语义契约衔接。