扫描压缩物理感知:EDT channel 分配、链长均衡与绕线拥塞的协同设计
更新时间:2026-10-03。DFT(可测试性设计)圈子里有个公开的秘密:压缩率报 100 倍的设计,物理实现时被绕线拥塞打回 30 倍的比比皆是。压缩逻辑在 RTL 阶段插进去时干干净净,一进布局布线就现出原形——几百条 scan channel 横穿芯片,decompressor 扇出如蛛网,把本已紧张的布线资源再吃掉一层。本站 DFT 扫描 ATPG 与 Tessent 讲了压缩的 ATPG 侧(pattern 怎么生成、覆盖率怎么算),扫描链重排与时序 讲了链序侧(链内触发器顺序怎么调),这一篇补上中间的空白:压缩逻辑的物理侧——channel 怎么分、链长怎么均衡、压缩率和拥塞怎么权衡。这是 synthesis 和 place 交接处最容易翻车的一段,也是「扫描压缩物理感知」(placement-aware scan compression)这个题目要解决的问题。
本文要回答的问题
- EDT 压缩架构里 decompressor、channel、compressor 各自是什么,为什么 channel 数是压缩率的物理上限?
- channel 分配不当为什么会在版图上制造绕线拥塞,物理感知的 channel 规划怎么做?
- chain 内部长度不均衡会怎样拖累测试时间和移位功耗,均衡的判据是什么?
- 压缩率、拥塞、测试时间、功耗四个目标怎么权衡,实战中用什么流程落地?
一、EDT 压缩架构回顾:channel 是连接 DFT 与物理的桥
先花一节把压缩架构讲清楚,因为后面所有的物理问题都挂在架构的某个部件上。以 Mentor(现 Siemens EDA)Tessent 的 EDT(Embedded Deterministic Test)为例,架构分三层。最外层是少量的 scan channel——从芯片引脚(或 JTAG 控制器)进来的测试数据通路,典型设计只有 8 到 64 条。中间层是 decompressor(解压器):一个由 XOR 网络或环形发生器(ring generator)构成的组合逻辑,把 channel 上的稀疏激励「膨胀」成几百条内部 scan chain 的输入。最内层是成百上千条短小的内部 scan chain——原来一条长链几千级触发器,现在被切成每链几十到上百级的短链,条数翻了几十倍。输出侧对称:各条短链的输出进 compactor(压紧器,XOR 树加可选的 masking 逻辑),再压回少量 channel 送出去和期望值比较。
压缩率就是这么来的:channel 数不变(测试机台的通道资源贵),内部链数暴涨,于是移位周期数从「最长链的级数」降下来。内部 500 条链、每条 100 级,移位只要 100 拍;不压缩时一条 5 万级的链要 5 万拍。理论压缩比 ≈ 内部链数 / channel 数。
关键认知:channel 数是一个三方共享的预算。ATPG 侧希望 channel 多一点——channel 太少,decompressor 的解空间受限,有些故障的激励向量编不出来,覆盖率掉、pattern 数涨(详见 DFT 扫描 ATPG 与 Tessent)。测试成本侧希望 channel 少——ATE(自动测试机台)按通道收费,scan I/O 引脚也占 pad。物理侧的态度最微妙:channel 本身不多,但每条 channel 要喂几十条短链,decompressor 的扇出网络在版图上是一张「一对几百」的星形网,链切得越碎、分布越散,这张网越难布。
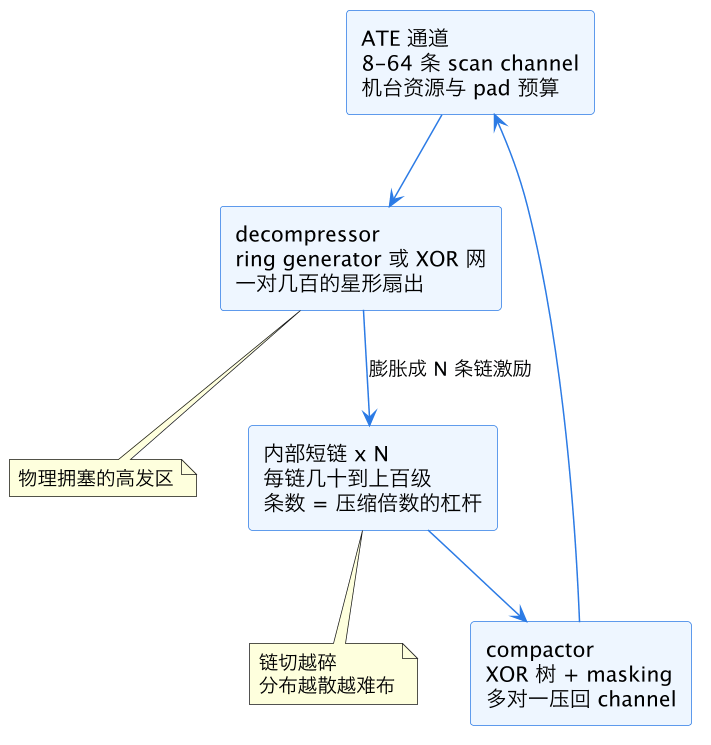
上图是压缩架构的数据通路。读图时盯住 decompressor 到 chains 的那条边:逻辑上它是一条「扇出 N」的边,物理上它是 N 条真实的走线,而且这 N 条短链在版图上往往散布全芯片——这就是为什么压缩逻辑的绕线代价不出现在 channel 上,而出现在 decompressor 的扇出侧。
二、channel 分配与物理布局:压缩率的隐形天花板
插入压缩逻辑时,工具让你填两个数:channel 数和内部链数。新手常见的填法是「压缩率拉满」——比如 8 channel 对 800 链,标称 100 倍压缩。网表阶段一切安好,到了布局布线阶段问题连环爆。
第一爆:decompressor 位置悖论。decompressor 是一个集中式逻辑块,按 数据流 S3 之 floorplan 与 place 的常规划法它会有一个落点;但它要喂的 800 条短链遍布全芯片,从中心一点向全芯片拉 800 条线,中心区域立刻形成布线热点——这正是 布线拥塞 DRC 与串扰 里讲的热点形成机制在 DFT 场景的重演。第二爆:短链碎片化。链切得越短,链与链之间的缝合(stitching)连线越碎,这些线不参与功能逻辑,纯占用布线轨道,密度高的区块直接被挤到 overflow。第三爆:时序夹缝。scan 路径虽然频率要求低,但几百条链的 shift 时钟也是一张大网,和功能时钟抢资源,CTS 阶段的缓冲器插入量明显上升。
物理感知的 channel 规划就是针对这三爆的工程解法,核心手法四个。其一,分区分配:把芯片按物理区块(macro 围出的区域、电压域、层次模块)切成若干分区,每个分区绑定一组专用 channel 和局部 decompressor,链只在分区内缝合——decompressor 的扇出半径从「全芯片」缩到「一个分区」,星形网变成若干张局部小网。Tessent 的 hierarchical EDT 和现代物理感知插链流程都是这个思路。其二,channel 走线借道 scan I/O 布局:channel 的 pad 位置要和分区位置对齐,不要让一个分区的 channel 从对角的 pad 进来横穿整个 die。其三,链数按分区密度配额:密度已经很高的区块少分几条链(链少链长, stitching 线少),稀疏区块多分——压缩率在全芯片范围内加权平均达标即可,不必每个分区都顶着上限。其四,decompressor 离散化:高级流程允许把单一 decompressor 拆成多个分布式子解压器,跟着分区走,进一步缩短扇出半径。
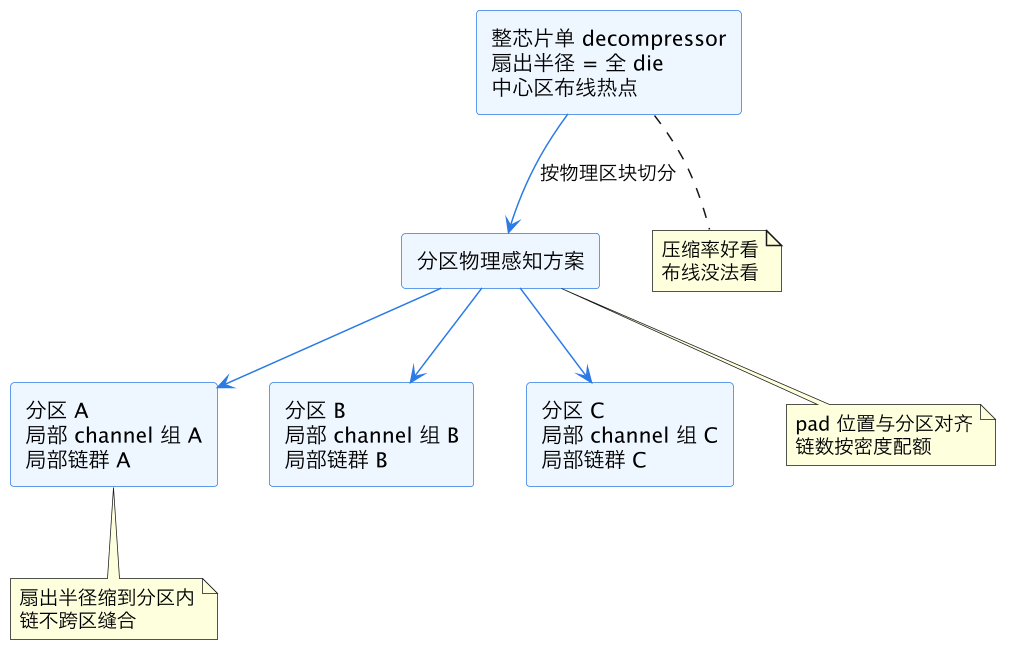
这张图对比了两种 channel 组织方式。要点是:压缩率的「标称值」在整芯片口径算,但拥塞是局部的、物理的——把全局指标拆成分区级配额,是保住压缩率又不引爆布线的标准姿势。
| 规划决策 | 压向高压缩 | 压向低拥塞 | 经验起点 |
|---|---|---|---|
| channel 数 | 少则压缩率高 | 多则扇出网小 | 16-64,按机台通道预算 |
| 每分区链数 | 多则移位短 | 少则缝合线少 | 分区触发器数 / (80-150 级每链) |
| decompressor 形态 | 集中式逻辑省 | 分布式布线省 | 大面积设计优先分布式 |
| 链跨分区缝合 | 允许则链数灵活 | 禁止则布线局部化 | 默认禁止,例外审批 |
上表是插链前评审时该过的四个决策点。总原则和 布局拥塞与 cell padding 里密度治理的精神一致:指标全局达标即可,局部必须留裕量。
三、chain 长度均衡:测试时间与移位功耗的隐形杀手
分区配额定了链数,下一个问题是每条链多少级。理想情况所有链等长:移位周期数 = 最长链级数,链不齐时,短链在空转——移位时钟照打、功耗照烧,但数据早已到位,纯属浪费。测试时间直接由最长链决定,不均衡的链长分布等于给测试成本加税。
不均衡从哪来?三个源头。第一,触发器分布本身不均:有的分区触发器密集(数据通路模块),有的稀疏(控制逻辑),按统一链数切,密区分区的链自然长。第二,时钟域约束:同一条链上串不同时钟域的触发器会引入 skew 和 hold 风险,工程上倾向按域分链,各域触发器数不齐直接导致链长不齐。第三,物理约束:分区方案里链不跨区,分区之间触发器数量差距直接变成链长差距。这和 扫描链重排与时序 讲的链序问题不同层面——重排解决链内顺序,这里解决链间配额。
均衡的工程手法分三级。链内级:工具自动做 chain balancing,把触发器在链间腾挪,目标是最长链与平均链长的差距压到 5% 以内;现代物理感知流程在腾挪时会看触发器的物理坐标,避免为了均衡把链缝成横跨全区的长线。分区级:调整分区之间的 channel 和链数配额,触发器多的分区多分 channel——压缩率配额跟着数据走。架构级:引入 chain 长度分组 + 分时移位,不同长度的链组用不同的 shift 脉冲计数(配合 masking),短链组提前封掉不再吃移位功耗,这是高端机台流程里的省电手法。
还有一个常被忽略的耦合:链长均衡和 capture 功耗。链越长,capture 时翻转的触发器越集中在少数链上,diagonal 上的峰值电流越尖;均衡的链长把翻转摊平,配合 数据流之 VCD/SAIF 活动率 的活动率分析可以定量评估移位翻转率——AT 速度移位时全芯片触发器同步翻转,是测试模式下 IR drop 的主要来源。
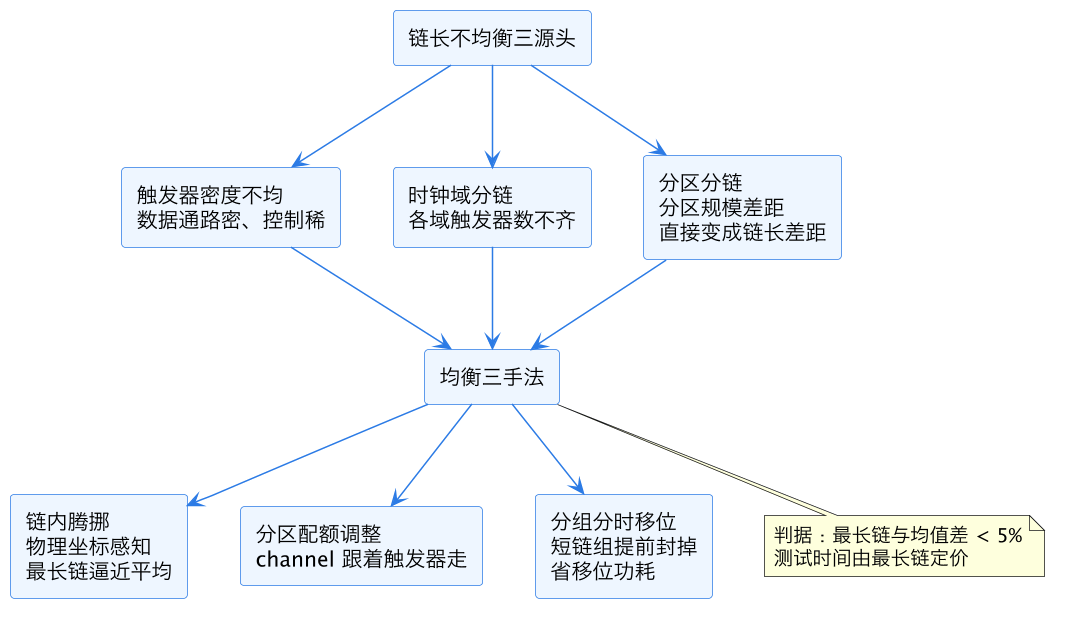
这张图把「病根」与「药方」分列两侧。读图注意:三个源头里有两个(时钟域、分区)是架构决策留下的硬约束,链内腾挪只能在约束内部榨空间——所以均衡要趁早,插链流程的 floorplan 评审阶段就该把分区触发器预算摆到桌面上,而不是等 ATPG 报移位周期数超了再回头改。
四、压缩率 vs 绕线拥塞:权衡的定量读法
现在把两条线合起来:压缩率和拥塞到底怎么换?一个可用的定量框架是这样。压缩侧的收益:移位周期数 ≈ 最长链级数 ≈ 总触发器数 / 内部链数,链数翻倍测试时间近似减半(capture 周期数不变,所以大 pattern 集里占比越高的 shift 越受益)。物理侧的代价:压缩逻辑的额外连线数大致正比于 内部链数 × 平均缝合距离 + channel 数 × channel 走线长度。链数翻倍,缝合连线数近似翻倍;如果同时链的物理分布更碎(跨区分链),平均缝合距离也在涨,代价是超线性的。
所以权衡曲线有个甜点区:从零压缩起步,加链的收益极大(5 万级链变 100 级,测试时间掉到 1/500),代价还小;链数继续涨,测试时间的边际改善进入对数区,而拥塞的边际代价进入陡升区——拐点就是甜点。经验上,这个甜点落在标称压缩率 30 到 100 倍之间,具体位置取决于设计的布线资源紧张程度:先进工艺低层金属资源紧、功能逻辑本身就吃着 70% 利用率的设计,甜点靠左(宁要 40 倍稳稳布通);资源宽松的设计可以推到 100 倍以上。
实战流程上,物理感知压缩的正确落地顺序是「先物理后压缩」:floorplan 定稿后,先跑一次功能逻辑的 trial placement + global route 拿到拥塞基线(数据流 S3 的标准动作);然后把压缩逻辑的 channel/分区/链数方案叠加进去再跑一次 trial route,对比 overflow 增量;overflow 恶化超过预算(常见红线是热点格数翻倍)就降分区链数或重划分区,迭代两三轮定稿,再交给 ATPG 生成 pattern。反过来的顺序(先定压缩架构再硬塞物理)是翻车的标准剧本——ATPG 侧 pattern 都生成完了,物理说布不通要改链数,pattern 全废,重生成一晚。
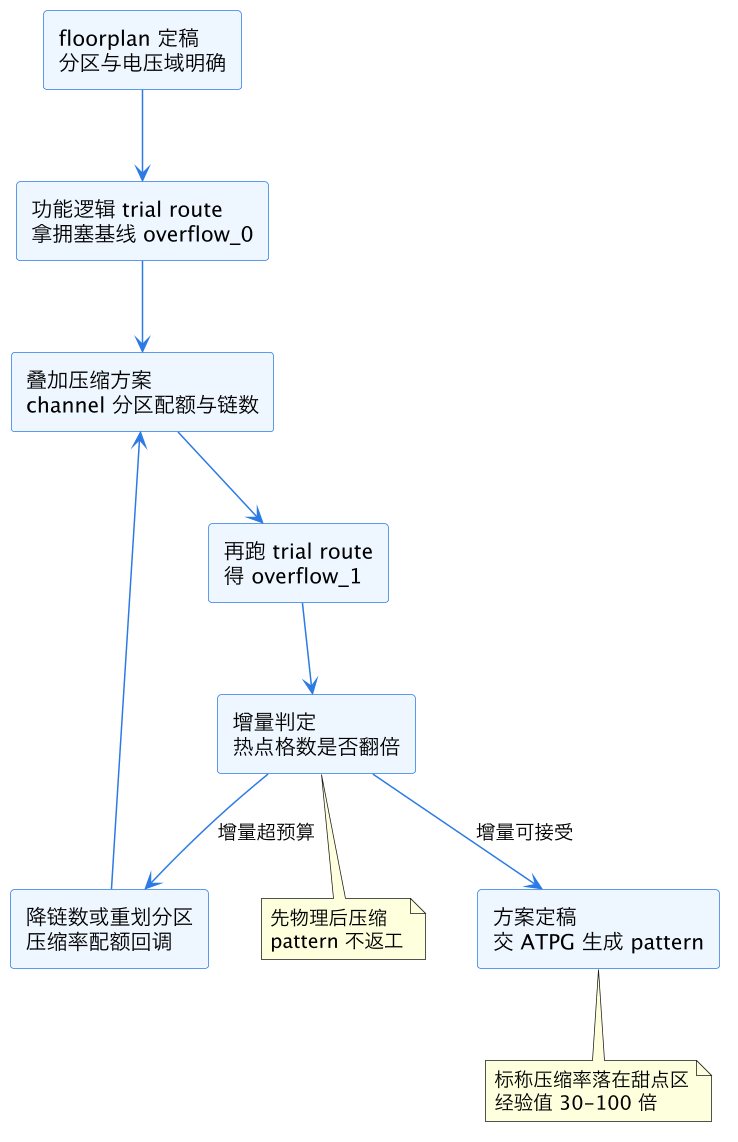
这张闭环流程图是全文方法论的总装。盯住 retry 回 dft 的那条回边:它只允许发生在 ATPG 之前,这就是「先物理后压缩」省下的那一晚。
五、实战检查清单与常见翻车
把上面的机制收成一张可执行的检查清单,按流程顺序过。
插链前(floorplan 评审):分区触发器预算有没有统计?各分区链数配额和最长链预估有没有算?channel 的 pad 位置和分区位置对不对得上?decompressor 是集中式还是分布式,落点在哪?插链后(trial route):overflow 增量多少?decompressor 扇出区有没有热点?scan 时钟网络的 CTS 缓冲器增量多少?ATPG 后:移位周期数和预估差多少(链不均衡会在这里现形)?pattern 数和压缩率收益是否兑现(物理妥协降了链数,ATPG 侧要重算账)?
| 翻车症状 | 病根 | 对策 |
|---|---|---|
| 中心区布线热点爆 | 单 decompressor 全局扇出 | 分区化或分布式解压器 |
| 测试时间超预估 30% | 链长严重不均 | 分区配额按触发器数重分 |
| 布通后 pattern 全废 | 先定压缩后做物理 | 流程反转,trial route 前置 |
| 移位 IR drop 超标 | 链不均加全速移位 | 链均衡加分组分时移位 |
| 标称 100 倍实得 40 倍 | channel 被机台预算砍 | 插链前对齐 ATE 通道预算 |
这一篇在知识体系里的位置
本篇是 eda/ 目录 DFT 线的物理侧枢纽文,横向连接同线的 DFT 扫描 ATPG 与 Tessent(ATPG 与 pattern 侧)和 扫描链重排与时序(链序侧),向上承接 数据流 S3 之 floorplan 与 place 的物理实现入口,向下借用 布局拥塞与 cell padding 的密度治理手法与 布线拥塞 DRC 与串扰 的热点分析框架,测试数据格式侧见 数据流之测试 pattern 格式。读完本篇,插链方案评审会上你该能听懂每一句关于 channel 配额的争论。
总结
扫描压缩物理感知的核心是把 EDT 压缩架构当物理对象而非纯逻辑对象来规划:channel 数是 ATPG、机台成本、布线三方共享的预算,decompressor「一对几百」的扇出才是拥塞的真正来源;工程解法是按物理分区绑定 channel 组和局部链群、链数按分区触发器密度配额、链长均衡以「最长链逼近平均 5% 以内」为判据、压缩率甜点落在 30 到 100 倍之间并按布线资源紧张度左右微调;落地流程必须「先物理后压缩」——floorplan 后先跑功能 trial route 拿拥塞基线,叠加压缩方案再验 overflow 增量,定稿后才交 ATPG,反过来做就是 pattern 全废的标准翻车剧本。