UVM report server 自定义:日志分文件输出、severity 改写与 verbosity 精细管控
更新时间:2026-10-01。UVM 环境跑久了,最影响调试体验的不是功能对错,而是日志:几千个用例的回归,每个用例几十万行日志,全部糊在一个文件里,warning 和 error 混在一起,想单独看某个 agent 的输出得靠人眼捞针。基础的分级打印在 UVM report 与 verbosity 控制 里讲过,改写第三方 VIP 消息的 catch/demote 套路见 UVM report catcher 与 demote。这一篇往前再走一步,讲 UVM report server 本身的三类自定义:把日志按 ID 拆到独立文件、在 server 层面改写 severity、以及除了
+UVM_NO_RELNOTES这种全局开关之外的 verbosity 精细管控手段。三件都不难,但组合起来能把回归日志从「信息垃圾场」变成「可检索数据库」。
本文要回答的问题
- UVM report server 的默认行为是什么,消息从
uvm_info到屏幕/文件经过哪几站? - 怎么用
set_id_file/set_severity_file把不同组件或不同级别的日志分流到独立文件? - severity 改写(override 与 catcher)各自的适用场景和副作用是什么?
- 除了
+UVM_NO_RELNOTES,还有哪些维度(ID、组件路径、时间窗)可以精细管控 verbosity? - 怎么把这套自定义固化成环境基类能力,而不是每个用例手写一遍?
一、先看清管道:消息从 uvm_info 到日志文件的路径
自定义之前先要知道自定义的对象在哪。一条 uvm_info 消息的旅程是:组件调用宏 → 构造 uvm_report_message → 先过本组件的 verbosity 过滤和 action 设置 → 交给全局唯一的 uvm_report_server → server 按 severity/ID 查文件描述符表 → 格式化后写出到屏幕或文件。最后两站之间还可以插进 report catcher,在消息真正落盘前改写它。
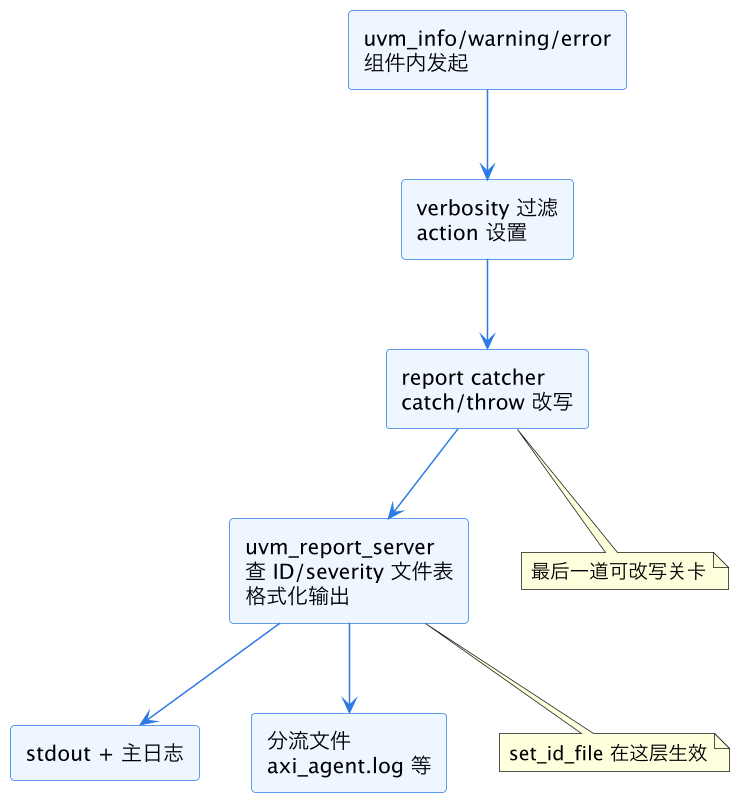
上图有两个关键点。第一,verbosity 过滤在最前——被 verbosity 挡掉的消息根本到不了 server,所以「想把某组件的 DEBUG 消息单独存文件」这条路走不通,得先放行再分流。第二,catcher 在 server 之前,意味着 catcher 改写的 severity 会影响 server 查哪张文件表:一条 UVM_ERROR 被 catcher 降级成 UVM_WARNING 后,会去 warning 的文件,而不是 error 的文件。这个顺序决定了后面所有技巧的边界。
二、分文件输出:set_id_file 把日志拆开
report server 维护两张「消息 → 文件」的路由表:一张按 message ID,一张按 severity。API 很直接:
uvm_report_server svr = uvm_report_server::get_server();
// 按 severity:所有 WARNING 及以上进 errors.log
svr.set_severity_file(UVM_WARNING, warn_fd);
// 按 ID:某 agent 的消息进独立文件
svr.set_id_file("AXI_MASTER", axi_fd);
实际项目里最常用的组织方式是「按组件 ID 分流」。约定每个 agent 发消息时用统一 ID 前缀(比如 AXI agent 全用 "AXI_MSTR" / "AXI_SLV"),环境基类的 build_phase 里统一注册文件句柄,每个用例跑完得到一摞小文件:axi_mstr.log、scoreboard.log、reg_access.log。triage 时先看主日志找报错时间戳,再开对应分文件看上下文,不用在几十万行里 grep。
两个容易踩的坑。第一,set_id_file 匹配的是完整 ID 字符串,不是通配符也不是前缀——想让一组 ID 都进一个文件,要么逐个注册,要么在组件里统一用一个聚合 ID。第二,文件句柄的管理责任在自己:$fopen 忘了 $fclose,仿真结束时缓冲区最后一段可能丢失;多个用例复用同一个 server 对象(UVM 的 server 是全局单例),上一个用例注册的路由表会带到下一个用例,记得在基类里做「注册/注销」配对,或者用例开头先 svr.set_id_file(id, 0) 清掉旧映射。
还有一个更省事的折中:不改 server,直接在组件里用 set_report_id_action(id, UVM_LOG | UVM_DISPLAY) 配合自定义文件句柄——不,这不对,action 里的 UVM_LOG 写的还是 server 的默认文件。真要分文件就必须动 server 的路由表,没有第三条路。
三、severity 改写:override 与 catcher 的分工
改写消息级别有两条路,机制完全不同。
| 维度 | set_severity_override | report catcher |
|---|---|---|
| 作用层 | report server(落盘前) | server 之前(消息途中) |
| 匹配粒度 | (severity, ID) 精确对 | 任意条件,可用正则/回调 |
| 影响动作 | 只改级别,action 按原级别算 | 级别、文本、action 都能改 |
| 副作用 | 全局生效,影响所有组件 | 按 catcher 注册范围生效 |
| 典型用途 | 某 ID 的 ERROR 降级为 WARNING | VIP 噪音消息按需压制/改写 |
set_severity_override 适合「确定性的、一对一的」改写。典型场景:某个已确认的 DUT bug 修复前,相关 checker 每天报 200 条 ERROR 把 triage 淹没,用 svr.set_severity_override(UVM_ERROR, "MY_CHECKER", UVM_WARNING) 把它降级,主日志干净,错误统计里这类消息也不再计入 fail 判定(取决于环境用哪个级别统计)。
catcher 适合「条件式的」改写。比如「只在某时间窗内把某 VIP 的 WARNING 压成 INFO」「包含某正则文本的消息才改写」——这些带条件的逻辑 override 做不了,得写 uvm_report_catcher 的子类,在 catch() 里判断后返回 CAUGHT(改写后放行)或 THROW(吞掉)。写法和完整案例见 UVM report catcher 与 demote,这里只强调一个配合关系:因为 catcher 在 server 之前,catcher 改完的级别会参与 server 的 override 匹配——如果两条链都配了,想清楚最终是谁说了算,最好环境里只保留一种改写机制为主,另一种只做特例。
severity 改写的纪律只有一条:改写必须带理由和期限。在环境基类里留一张「降级登记表」,每条 override 注明对应 bug 单号和预期撤销日期,triage 会议过一遍——没有登记的降级,本质上是在给 bug 打掩护。
四、verbosity 精细管控:UVM_NO_RELNOTES 之外的维度
很多人管控日志量只靠两个全局开关:+UVM_VERBOSITY=UVM_LOW 和 +UVM_NO_RELNOTES(去掉版权头)。这对小环境够用,对大回归就是灾难——要么渴死要么淹死。精细管控的维度有三个。
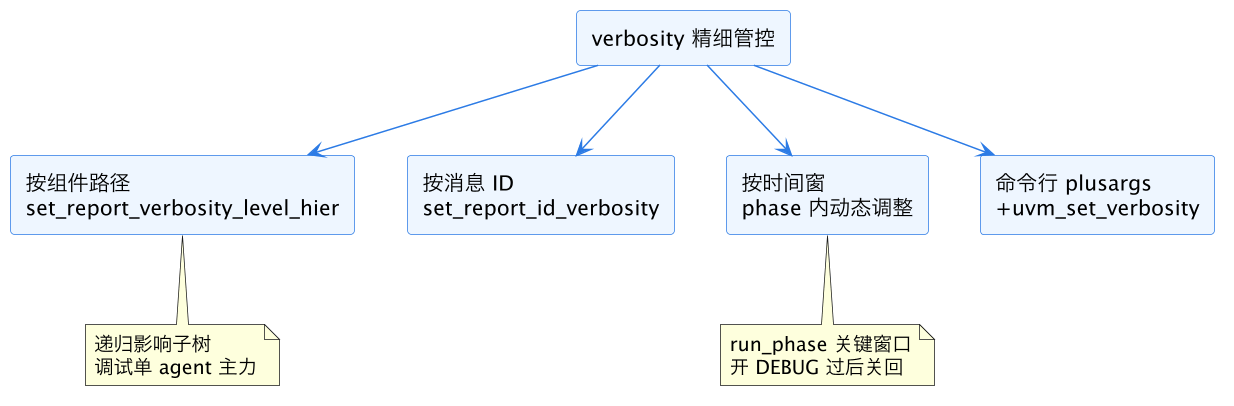
按组件路径是最常用的:env.axi_agt.set_report_verbosity_level_hier(UVM_DEBUG) 只把这个 agent 整棵子树的 verbosity 提上去,其余组件保持 UVM_MEDIUM,日志量可控。按消息 ID 适合「只想看某类事件」:比如所有组件里 ID 为 "CFG_UPDATE" 的消息提到 UVM_NONE(必打),其他维持原级。命令行侧的 +uvm_set_verbosity=uvm_test_top.env.apb_agt,_ALL_,UVM_HIGH,time,0 则把这套能力做成不改代码的调试开关——语义与自定义 plusargs 一脉相承,机制见 SV plusargs 配置化 和 UVM 命令行 plusargs。
按时间窗是高手向但收益最大的一招:在 sequence 或 phase 回调里,关键操作前把相关组件 verbosity 拉满,操作结束马上调回。比如寄存器初始化阶段全程 UVM_HIGH,进入功能激励后降回 MEDIUM——初始化那段的详细日志对「配置没生效」类问题价值极高,又只占整段日志的零头。配合第四节说的分流文件,初始化日志单独落一份,比任何波形都先暴露配置路径错误。
五、固化进基类:让每个用例自动继承这套能力
三件套要发挥威力,必须下沉到环境基类,做成约定而非手艺。推荐的基类动作清单:build_phase 里统一注册 ID 文件表和降级表(从配置文件或 plusargs 读,不写死);end_of_elaboration 打印当前路由表和 verbosity 覆盖清单,让「这个用例的日志策略长什么样」一眼可查;final_phase 里统一 $fclose 所有句柄并按约定命名归档。回归脚本侧,把失败用例的「主日志 + 报错 ID 对应的分文件」自动打包成复现包,triage 的同事拿到手就是完整现场——这与 回归管理与 triage 的分诊节奏正好咬合。
最后一个提醒:server 是全局单例,所有注册都有「上一个用例残留」的风险。基类里务必在 build 开头做一次干净化(清 ID 文件表、清 override 表),否则并行回归里用例间互相污染,会出现「A 用例的分流文件里混进 B 用例消息」的灵异现象,排查起来比功能 bug 还磨人。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下「日志治理」线的进阶篇:基础分级打印与 verbosity 概念在 UVM report 与 verbosity 控制,消息改写与第三方 VIP 降噪的完整写法在 UVM report catcher 与 demote,命令行配置化机制接 SV plusargs 配置化 与 UVM 命令行 plusargs,环境骨架概念回到 UVM 组件与 phase,批量失败的分诊流程看 回归管理与 triage。
总结
UVM report server 自定义就三招:用 set_id_file/set_severity_file 按 ID 或级别把日志分流到独立文件,用 set_severity_override(确定性改写)和 report catcher(条件式改写)在落盘前调整消息级别,再用组件路径、消息 ID、时间窗三个维度替代 +UVM_NO_RELNOTES 式的全局开关做 verbosity 精细管控——全部固化进环境基类并配好清理动作,回归日志才能既看得下去又 grep 得动。