树注意力投机解码:tree attention mask kernel 与多候选并行 accept 的实现细节
更新时间:2026-10-03。前面 投机解码推理加速 讲过投机解码的总框架:小模型先猜 k 个 token,大模型一次前向并行验证,平均每个 decode 步能多吃下 1.5~2.5 个 token。Medusa 与 EAGLE 投机头 则讲了草稿从哪来——Medusa 给大模型加多个解码头、EAGLE 在特征层自回归外推。但这两篇都停在「一条链式草稿」的层面:候选只有一串,验证是线性的。真正的生产实现(vLLM、TensorRT-LLM、SGLang 里的 Medusa/EAGLE 路径)用的是树状草稿:同一步提出几十到上百个候选 token,组织成一棵前缀共享的树,靠一个特殊的 tree attention mask 让大模型一次前向把所有分支都算对,再按规则并行 accept。本文就把这层 kernel 与数据结构的实现细节拆开讲。
本文要回答的问题
- 链式草稿改成树状草稿,收益从哪来?树的大小和形状怎么定?
- tree attention mask 的语义是什么,为什么不能用现成的 causal mask?
- mask 在 kernel 里怎么表示和加载,几百字节的位图怎么喂给注意力?
- 一次前向之后,多候选 accept 的判定顺序和概率规则是什么?
- accept 之后 KV cache 怎么「留下命中分支、回收废分支」,和分页 KV 怎么配合?
一、从链到树:为什么一条草稿链不够
先回顾链式验证的数学事实。设每个位置的接受率为 α(草稿 token 被大模型认可的概率),链长 k 的期望接受 token 数是 (1−α^(k+1))/(1−α),α 典型值 0.6~0.8 时,链长 5 期望接受约 2.5 个。想再往上走有两条路:把 α 推高(更好的草稿模型,见 草稿模型训练),或者在同样的大模型前向成本里塞进更多候选。
树状草稿走的是第二条路。观察链式验证的成本结构:大模型前向验证 k 个 token,瓶颈在把模型权重从 HBM 搬一遍(decode 是典型的带宽受限场景,背景见 注意力 decode 的 split-K 切分),序列维从 1 个 token 涨到 64 个 token,kernel 耗时几乎不变——因为 GEMV 变成了小 GEMM,带宽没变、算力空转被填上一点而已。既然「验证 5 个」和「验证 50 个」成本差不多,那就把候选铺开:Medusa 的 5 个头各给 top-2~top-4 的候选,按笛卡尔积展开再剪枝成一棵 60~100 个节点的树;EAGLE 则是自回归展开 2~3 层、每层保留 top-k,同样收成一棵树。
树的关键性质是前缀共享:多条候选路径共享前面的节点,一个节点只算一次、只占一份 KV。共享前缀让树的「候选路径总数」远大于「节点总数」——一棵 64 节点的树可以包含 20 多条从根到叶的路径,每条都是潜在的接受序列。这就是为什么树比「并列 k 条独立链」省得多:独立链没有共享,64 个节点只能表示 8 条长度为 8 的链;树形结构同样 64 个节点能覆盖的深度和宽度都大得多。
| 草稿形态 | 一次前向验证的节点 | 可表示的候选路径 | 期望接受 token(α=0.7 量级) | 代表方案 |
|---|---|---|---|---|
| 单链(k=5) | 5 | 1 | ~2.5 | 原始投机解码 |
| 并列多链 | 多 × 链长 | 链数 | 略升,浪费节点 | 朴素 batch 草稿 |
| 树(前缀共享) | 60~100 | 20+ 条 | 3~5 | Medusa、EAGLE、Hydra |
二、tree attention mask 的语义:树里的「因果」是什么
标准 decode 的因果 mask 是一条下三角:第 i 个 token 能看 0..i。树状草稿里,「能看」的定义变了——每个节点只能看它到根的那条祖先路径上的节点,加上全部已确认的前缀上下文,不能看兄弟、堂兄弟分支上的任何节点。理由很直接:分支之间是互斥的「平行宇宙」,叶子 A 的 logits 是用来判定「如果走了 A 这条路径,下一个 token 是什么」,它绝不能混入走 B 路径才会产生的中间状态。
于是注意力 mask 从「下三角矩阵」变成「按树的父子关系生成的祖先可达矩阵」。设树有 n 个节点(不含已确认上下文),mask 是一个 n×(ctx+n) 的布尔矩阵:前 ctx 列(已确认上下文)全为 1;后 n 列里第 i 行只在「j 是 i 的祖先或 j==i」的列上为 1。这个矩阵不再是三角形,而是按树的结构稀疏——一行里祖先链上的列亮着,其余全黑。

上图把一行 mask 的构成画清了:左段是恒全 1 的上下文区,右段是按祖先链点亮的稀疏区。一个具体的数值例子更直观——树有 4 个节点:节点 1 是根(草稿第一层),节点 2、3 是根的两个孩子,节点 4 是节点 2 的孩子。那么树内 4×4 的 mask 是:
| query\key | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 1 | 1 | 0 | 0 | 0 |
| 2 | 1 | 1 | 0 | 0 |
| 3 | 1 | 0 | 1 | 0 |
| 4 | 1 | 1 | 0 | 1 |
注意第 4 行:节点 4 看不见节点 3(叔伯分支),看得见节点 2 和节点 1(祖先)。这不再是任何「下三角 + 固定 pattern」能表达的形状,所以现成的 FlashAttention causal 模式用不了,必须显式传 mask 或者改 kernel 逻辑。这就是 tree attention kernel 存在的原因。
三、kernel 实现:位图进寄存器,mask 判定内联进注意力主循环
工程上 mask 的表示是每行一个位图(bitmask)。树节点数通常 ≤128,所以每行的树内部分用一个或两个 64 位整数就能装下;整个 mask 只有 n×16 字节,几 KB 都不到,放在 shared memory 或常量显存里随取随用。相比「n×n 的 float mask 矩阵」(128×128×4 字节 = 64 KB),位图省了三个数量级的存储和带宽——这个选择不复杂,但它是让 tree attention 能贴着 FlashAttention 骨架改的前提。
kernel 的改法有两条主流路线。第一条是显式 mask 加法路线:沿用普通 FlashAttention 的分块主循环(分块与在线 softmax 的背景见 FlashAttention 显存分块 tiling),在算出 QK^T 分数块之后、softmax 之前,把 mask 为 0 的位置加上 −inf(或一个大负数)。这条路线的优点是改动小、对任意 mask 通用;缺点是要把位图展开成和分数块同形状的加性掩码,多一份中间计算,且被 mask 掉的块照样算了 GEMM,算力是浪费的——好在 decode 场景算力本来就在空转,浪费得起。
第二条是按块跳过路线:先对 mask 位图做预处理,算出每个 query 块的「key 块级可见性」——一个 key tile 若对某个 query tile 全零,整个块的 QK^T 直接跳过,连 GEMM 都不发。树 mask 的稀疏度很高(64 节点、平均深度 5 的树,树内部分密度只有 8%~10%),按块跳过能省掉大部分小 GEMM。TensorRT-LLM 和 EAGLE 的参考实现走的都是这条路或它的变体。

上图是跳过路线的 kernel 数据流:位图先离线(kernel 开头的预处理阶段)压成块级可见表,主循环按表分流。还有一个细节值得点名:位置编码。树里每个节点的 RoPE 位置不能用它在展开数组里的下标,必须用它在树里的深度(祖先链长度)——否则节点 4(深度 2)和节点 3(深度 1)会在相对位置上错位,注意力分数就全乱了。所以 kernel 的 QK^T 部分还要读一张「节点深度表」来做逐节点位置偏置,这张表和位图一样是几 KB 的小数组。EAGLE 的实现里这张表是在草稿展开时就生成好、随 mask 一起传给 kernel 的。
另外,树节点是「一个 batch 条目内部」的结构,真实 serving 里每个请求各有一棵树,batch 内各树节点数不同,kernel 要按变长处理——沿用的还是 cu_seqlens 打包思路(见 FlashAttention-3 的 varlen 支持),把所有请求的树节点拼成一条长序列,mask 位图按请求分段索引。
四、并行 accept:一次前向后怎么判定「吃下哪条路径」
前向跑完,手里有了 n 个树节点各自的 logits(即大模型在「假设走到该节点」时对下一个 token 的预测分布)。accept 阶段要做的事:从根开始沿树往下走,每一步在「大模型的选择」和「该节点的孩子集合」之间做判定,走出一条尽可能长的被认可路径。
贪心(temperature=0)下规则最简单:在节点 i,取大模型 argmax 的 token t;如果 t 在 i 的孩子里(草稿提出过这个候选),就 accept,走到那个孩子节点继续;否则 reject,把 t 本身当作本步的「bonus token」收下,整条路径到此为止。采样(temperature>0)下用的是投机解码标准的拒绝采样判定(数学保证输出分布与大模型直接采样一致,推导见 投机解码推理加速):对孩子 token 计算接受概率 min(1, p_target/p_draft),随机数判定,被拒了就从修正分布 residual = norm(max(0, p_target − p_draft)) 里重采一个收尾。
树和链在 accept 上的差别有两点。其一,选择面更宽:链式被拒一步就结束,树式在当前节点有多个孩子,大模型 argmax 命中其中任何一个都能续命——这正是树提高期望接受长度的直接机制。其二,判定有顺序:实现上 accept 是「树的深度优先遍历加提前剪枝」,每步只查当前节点的孩子列表(孩子指针表,几 KB),整条 accept 逻辑几十个节点、纯标量运算,在 CPU 或一个很轻的 GPU kernel 里做都可以,相比前向的成本可以忽略。
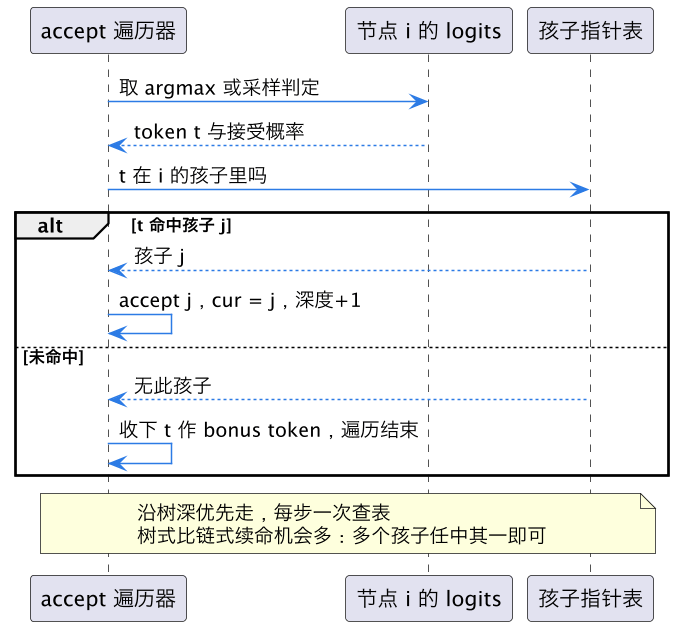
上面这张判定流程图对应一次 accept 的微观循环。宏观效果是:64 节点的树、贪心设定下通常 accept 出 3~5 个 token,加 bonus 一次 decode 步最多推进 6 个位置——对比链式的 2~3 个,同样一次大模型前向,吞吐接近翻倍,而延迟几乎不变(前向多算了 60 个节点的开销在带宽受限下只有几个百分点)。这就是树状草稿的全部收益来源:用免费的前向容量换每步推进长度。
五、KV cache:命中分支留下,废分支回收
accept 决定了走哪条路径,剩下 n−accepted 个节点的 KV 全是废品,必须回收,否则 KV cache 会被草稿垃圾淹没(KV cache 的基础管理见 KV cache 推理显存)。
实现上的标准做法是追加写加指针回滚。验证前向时,树节点的 KV 按展开顺序追加写入 KV cache 的尾部空闲区——这块区域是预先按「最大树大小 × KV 每 token 字节数」预留的;accept 结束后,把命中路径上的节点的 KV 保留(它们本来就是正确的上下文 KV),把废节点的 KV 释放。由于追加区是尾部连续的,释放就是「把尾指针回滚到命中路径的最后一个节点之后」,O(1) 完成。更省事的变体甚至不搬运:命中节点的 KV 已经在正确位置,只是逻辑上把序列长度更新为 ctx+accepted,下一轮 prefill/decode 从新的长度继续写——废节点 KV 被后续写入自然覆盖。
和 PagedAttention 分页 KV 配合时,做法是给草稿区单独分配一小组「临时页」:验证前向把树节点 KV 写进临时页,accept 后命中节点的临时页被「转正」挂进该请求的页表,其余临时页整批还回空闲页池。这样草稿的分配和回收都不触碰主 KV 区的页管理,碎片可控。一个工程坑值得提:多请求 batch 下各请求 accept 长度不同,KV 回收后各请求的序列长度变得参差不齐,下一轮组 batch 时调度器要按新长度重新对齐——这和 continuous batching 调度器 里处理请求提前结束的逻辑是同一套基础设施,所以投机解码基本只在已经做了 continuous batching 的引擎里落地。
六、落地清单:什么场景值得上树,什么场景不值得
把整篇收拢成工程决策:
- 树大小不是越大越好。节点数涨,前向成本缓涨但 accept 收益递减(候选之间互相抢概率质量)。Medusa 官方配置的甜点在 60~100 节点;EAGLE 常用 60 上下。实测曲线通常是 32→64 节点收益明显,128 再往上基本打平。
- 带宽受限才有效。树状验证的全部前提是「前向成本对 token 数不敏感」。batch 已经很大、decode 已经变成算力受限(大 batch 下 GEMM 被打满)时,塞 60 个节点的前向是真金白银的额外成本,投机解码整体可能负收益。经验线:decode batch 较小、TPOT 由 KV 带宽决定时上树;batch 挤满算力时关掉。这条线的量化分析可对照 batch 大小与延迟吞吐曲线。
- mask kernel 选型。快速接入用显式 mask 加法(vLLM 早期 Medusa 路径);追性能用块级跳过(TensorRT-LLM);自研 kernel 时记得 RoPE 深度表和 varlen 打包两个细节,漏了任何一个都是「loss 对不上」级别的错。
- 和采样参数的耦合。temperature 高时接受率整体下降,树的收益缩水但相对链式仍有优势;很多引擎在 temperature>1 时干脆退回普通 decode。
- 调试抓手。线上开投机解码后第一件事是打点「每步平均 accept 长度」和「树节点数/accept 比」,前者掉出预期区间多半是草稿分布漂了,后者异常高说明树剪枝配置要调。
| 决策点 | 推荐 | 理由 |
|---|---|---|
| 树节点数 | 60~100 | 收益甜点,再大前向成本追上来 |
| mask 表示 | 每行 64/128 位位图 | 几 KB,SMEM 常驻 |
| kernel 路线 | 块级跳过 | 树 mask 稀疏度 90% 左右,跳过省大半 GEMM |
| RoPE 位置 | 按树深度,不按展开下标 | 否则位置编码全错位 |
| KV 回收 | 临时页加转正/回滚 | O(1) 回收,不污染主区页表 |
| 适用 batch | 小中 batch、带宽受限 decode | 大 batch 算力受限时负收益 |
这一篇在知识体系里的位置
本篇是「投机解码」线索的 kernel 层一环:上游是 投机解码推理加速(链式验证的概率框架)和 Medusa 与 EAGLE 投机头(树状草稿的生成来源);同层可对照 FlashAttention 显存分块 tiling(tree attention kernel 借用的分块骨架)、PagedAttention 分页 KV(草稿 KV 临时页挂靠的页管理)与 continuous batching 调度器(变长 accept 之后的 batch 重组);下游延伸是 EAGLE-2/EAGLE-3 的动态树形调整与多步投机(投机模型自己也用小模型再投机)的多层结构。
总结
树注意力投机解码把「验证一条草稿链」升级成「一次前向验证一棵前缀共享的候选树」:树内每个节点只看祖先链的特殊 mask 用每行一个 64/128 位位图表示,kernel 在 FlashAttention 骨架上按块跳过全零 key tile(配合按树深度而非展开下标的 RoPE 位置表),前向跑完沿树深优先做多候选 accept——大模型 argmax 命中任一孩子即可续命——再用「临时页转正加尾指针回滚」把命中分支的 KV 留下、废分支 O(1) 回收;在小中 batch 带宽受限的 decode 场景,这套机制用几乎免费的前向容量把每步推进长度从 2~3 个 token 抬到 3~6 个,是 Medusa、EAGLE 在生产引擎里兑现加速比的最后一层实现细节。