UVM pack 字节序:pack_bytes 字段序、大小端与协议线序一致性
更新时间:2026-09-29。UVM field automation 与 packer:do_pack 手写与宏展开 讲了字段自动化宏怎么展开成
pack调用、uvm_packer的三种风格;这一篇只回答一个更具体的工程问题:打出来的字节流,字节顺序到底对不对?很多验证环境 scoreboard 比对「偶尔全错」,根因不是 RTL,而是 UVM pack 字节序和协议线序差了半个字。
本文要回答的问题
pack_bytes输出的字节数组,第 0 个字节是字段的「高位」还是「低位」?- 多个字段打包时,谁先谁后?位宽不是 8 的倍数怎么办?
- 协议规定「先传低字节」(小端线序)时,UVM 默认行为会发生什么?
- 如何写一个同时给 driver 和参考模型复用的字节序适配层?
一、字段顺序:pack 只看声明序,不看物理意义
UVM 的 pack_bytes 没有「字节序」概念上的歧义处理——它做的事情非常机械:按字段注册的顺序,把每个字段的位流依次拼进一个位向量,再按 8 位一切,输出字节数组。规则要点三条:
- 字段先后:
uvm_field_*宏(或do_pack里的调用)的声明顺序就是拼接顺序,先声明的字段占整个位流的高位。 - 字段内部:每个字段是一个
bit[N-1:0],它的最高位(N-1)排在前面,即字段内部是「大端位序」。 - 末尾补齐:总位宽不是 8 的倍数时,
pack_bytes在低位补零凑整到字节边界。
看一个具体例子,一个简化的报文头事务:
class my_hdr extends uvm_sequence_item;
  rand bit [15:0] length;   // 先注册,占字节流前 2 字节
  rand bit [3:0]  type_id;
  rand bit [11:0] seq_no;
  `uvm_object_utils_begin(my_hdr)
    `uvm_field_int(length,  UVM_ALL_ON)
    `uvm_field_int(type_id, UVM_ALL_ON)
    `uvm_field_int(seq_no,  UVM_ALL_ON)
  `uvm_object_utils_end
endclass
设 length=16'h1234、type_id=4'hA、seq_no=12'hBCD。拼接后位流为 32 位 32'h1234_ABCD,pack_bytes 输出 4 个字节:byte[0]=8'h12、byte[1]=8'h34、byte[2]=8'hAB、byte[3]=8'hCD。也就是说 UVM 默认输出是大端字节序(big-endian):字段的高位字节在数组下标小的位置,先被 driver 发出去。
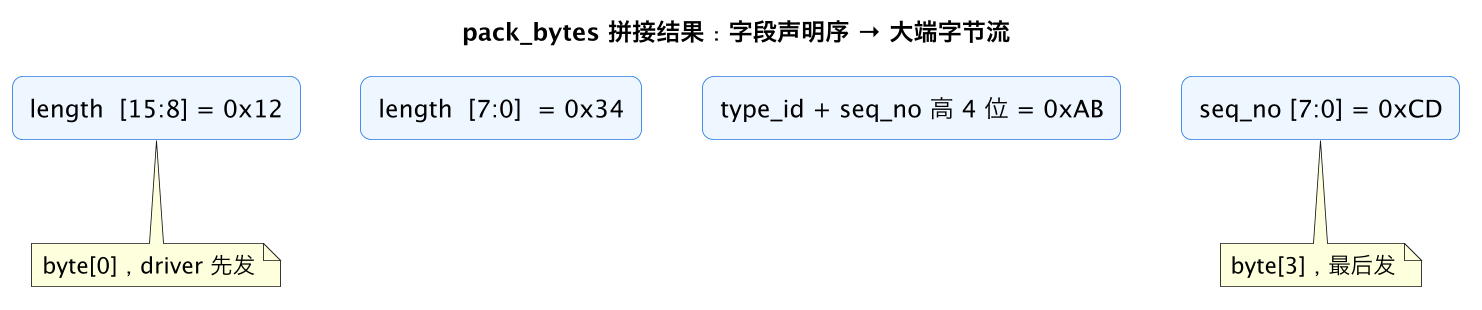
这张图要盯住两点:一是「先发哪个字节」完全由字段声明顺序决定,length 声明在最前,它的高字节就是 byte[0];二是跨字段的字节(0xAB)由 type_id 的 4 位和 seq_no 的高 4 位拼成——位宽不对齐时字节边界会切开字段,这正是很多调试里「这个字节怎么是两个字段拼的」的来源。
这里还有一个容易忽略的细节:上面用的是 uvm_field_int 宏,它注册的是无符号整数语义,拼接时按声明的位宽精确截取。如果字段声明位宽和宏推断不一致(比如字段是 bit [15:0] 却误用了带 UVM_NOCOMPARE 之外的打包策略自定义写法),拼出来的位流会悄悄移位,所有下游字节整体错半拍。所以报文类字段的位宽定义要和协议规格书逐位核对,这是字节序讨论之前的前置体检。
二、大小端:协议线序和 UVM 默认不一致时
UVM 的默认大端输出和协议线序是否一致,取决于协议本身。三种典型情况:
| 协议/场景 | 线序约定 | 与 pack_bytes 默认的关系 |
|---|---|---|
| 以太网、多数网络报文 | 高位字节先发(网络字节序,大端) | 一致,直接发 |
| PCIe TLP 报头 | 低字节先出现在总线低位 lane | 不一致,需翻转或调整 |
| AXI/AHB 窄带传输 | 字节位置由地址决定,硬件拼接 | 看 driver 怎么驱动 wdata,不能盲发数组 |
最容易出事故的是第二类:协议文档画的是「内存布局」或「总线 lane 布局」,而验证同学直接拿 pack_bytes 的数组顺序当发送顺序。UVM 默认 byte[0] 是字段高位,但 PCIe 这类总线上 byte[0] 该放字段低位——整个报文头在 driver 眼里就是反的。
修正手段有两种,效果等价但可维护性差很远:
// 做法 A:发送前整体翻转(每 4 字节一组,协议按 word 对齐时)
function void pack_le(ref byte bytes[]);
  pack_bytes(bytes);
  foreach (bytes[i]) ; // 按协议粒度 reverse
  for (int w = 0; w < bytes.size()/4; w++)
    for (int k = 0; k < 2; k++) begin
      byte t = bytes[w*4+k];
      bytes[w*4+k]   = bytes[w*4+3-k];
      bytes[w*4+3-k] = t;
    end
endfunction// 做法 B:在 do_pack 里按字节粒度显式注册(推荐)
function void do_pack(uvm_packer packer);
packer.pack_field_int(length[7:0], 8);
packer.pack_field_int(length[15:8], 8);
packer.pack_field_int(seq_no, 12);
packer.pack_field_int(type_id, 4);
endfunction做法 A 是「打完再翻」,反转粒度(按字节?按 word?)写死在函数里,换个协议粒度就得改;做法 B 放弃 field automation 宏、手写 do_pack,把线序显式写进字段注册顺序,代码即文档,scoreboard 的参考模型和 driver 都能直接复用同一个对象。团队里有多种协议混用时,强烈建议做法 B。
还要提醒一个混合场景:同一个报文类里可能既有小端字段又有大端字段(例如某些协议头部小端、载荷里嵌套的网络报文大端)。做法 A 的整体翻转对此无能为力——它只能翻整个数组;做法 B 天然支持逐字段定序,哪个字段按什么顺序排字节,在 do_pack 里一目了然。这也是「字节序是字段级属性,不是报文级属性」这条认知的工程落点。
三、对齐与补齐:位宽不是 8 的倍数的两个坑
第一个坑是补齐方向。pack_bytes 在低位补零,而 pack(输出 bit[] 动态数组)的语义是每一位一个元素、下标 0 是最高位——同一个对象用两个 API 得到的「顺序观感」不同。混用 pack 和 pack_bytes 做 golden 比对时,一定要先把参考侧统一换算成字节,再做数组比较,不要拿位数组和字节数组「凭感觉」对齐。
第二个坑是反向 unpack。unpack_bytes 按完全对称的规则解析:byte[0] 进第一个注册字段的高位。如果 monitor 从总线上采到的字节序本来就是小端(先采到低字节),直接 unpack_bytes 会把报文头解析得面目全非,而且 unpack 不会报错——它只按位宽切,切出来的字段值是「合法但错误」的,scoreboard 才开始报 mismatch。这是字节序问题最难查的形态:错误点在 monitor 解析处,症状却暴露在比对器。
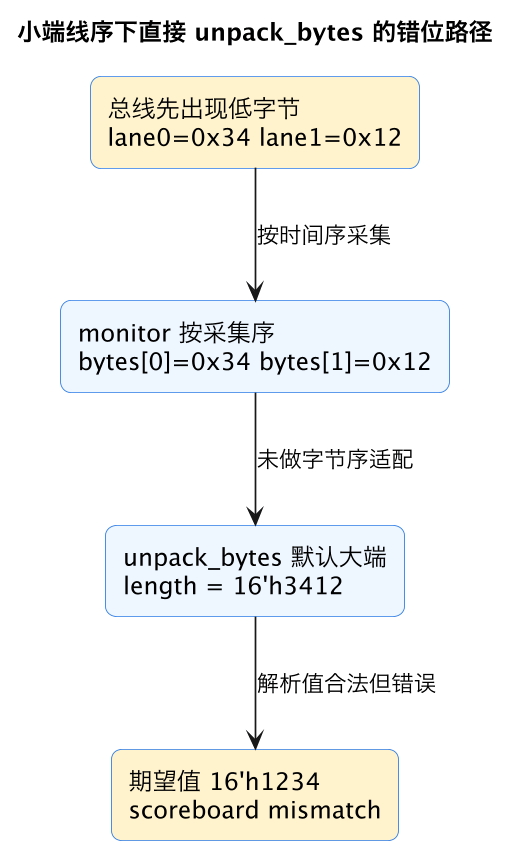
这张图的错误链路是字节序问题的标准样本:总线行为本身没错,monitor 采集也没错,错在「采集序 = 数组序」这个隐含假设和 unpack_bytes 的大端假设撞车。修复点只有一个——monitor 交付事务前做字节序归一化(翻转数组或按小端注册 do_unpack),让「对象内部的字段值」永远与协议语义一致,至于字节怎么排列是打包层的事。
四、工程纪律:一条规则管住所有组件
字节序问题之所以反复出现,是因为 driver、monitor、参考模型三处各自做了自己的假设。一条纪律可以根治:事务对象内部永远只存「协议语义值」,字节序转换全部收口在 pack/unpack 层(做法 B 的显式 do_pack/do_unpack),driver 和 monitor 只面对字节数组,绝不手动拼字段。这样字节序知识只有一份,改协议时改一处,scoreboard 永远比对语义值,天然免疫字节序错位。
回归里再加一条廉价的保险:给每个报文类写一个单元级序列,发固定魔术值(如 length=16'h1234),在 monitor 侧断言采回对象字段相等。字节序错位 100% 会触发这条测试,成本是十分钟,收益是省掉每次「scoreboard 全错」的半天排查。
这一篇在知识体系里的位置
- 上游:UVM field automation 与 packer:do_pack 手写与宏展开 讲
uvm_packer的宏展开与三种打包风格,本篇的字节序规则建立在它的字段注册机制之上。 - 数据类型地基:SystemVerilog 数据类型:packed 与 unpacked 的边界 解释 packed 数组的位序语义,是理解 pack 输出位流的先修。
- 环境集成:UVM driver、sequence 与 scoreboard 的协作 给出 driver/monitor/scoreboard 的数据通路,本篇的字节序适配点就在这条通路上。
总结
UVM pack 字节序的默认行为是「按字段注册顺序拼接、字段高位在前、低位补零凑整」,即大端输出;协议线序是小端时,要么发送前按协议粒度翻转,要么(推荐)手写 do_pack 按字节粒度显式注册;unpack 错位不产生报错只产生「合法但错误」的字段值,是最难查的形态;根治靠一条纪律——字节序知识全部收口在 pack/unpack 层,对象内部只存协议语义值。