FPGA 进阶 08:BRAM/URAM 存储设计——单双口 RAM、ROM、乒乓缓存与推断
本文是
fpga/进阶层第 12 篇。上一篇讲了算术靠 DSP48,这篇讲数据通路另一大硬核——存储:FPGA 里大块数据缓冲不用触发器堆,而用专用 Block RAM(Xilinx 18/36Kb BRAM,UltraScale+ 还有 288Kb URAM;Intel 称 M10K/M20K)。FIFO 设计篇 的异步 FIFO 底层正是 BRAM 双口 RAM。
本文要回答的问题
- 分布式 RAM、BRAM、URAM 怎么选?
- 单口 / 简单双口 / 真双口 RAM 区别和选型?
- Verilog 怎么写才推断成 BRAM,什么写法掉成一堆 FF?
- ROM 怎么初始化?BRAM 读写模式和打拍提频?
- 乒乓缓存、行缓存怎么做、用在哪?
一、三种存储资源
| 资源 | 构成 | 容量量级 | 特点 | 适用 |
|---|---|---|---|---|
| 分布式 RAM | LUT 拼 | 小(几十~几百字节/块) | 快、可布在使用点旁、可异步读 | 浅 FIFO、寄存器堆、局部小缓冲 |
| Block RAM | 专用硬核 | 18/36Kb | 同步读、双口、可级联,主力 | FIFO、帧/行缓冲、ROM、数据缓存 |
| URAM | 超大硬核 | 288Kb | 超大容量、省 BRAM | 深缓冲、大矩阵/帧缓存(UltraScale+) |
用错代价:小数组占整块 BRAM 浪费且可能引入延迟;超大数组用 FF/LUT 直接爆资源。综合可用 (* ram_style = "block" | "distributed" | "ultra" *) 引导。
二、RAM 的三种端口结构
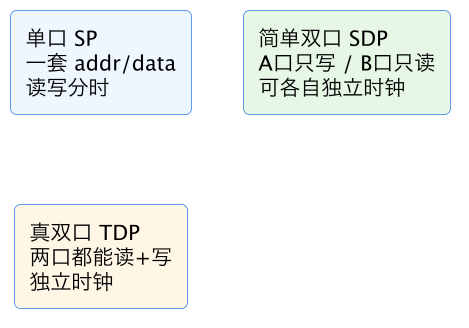
- 单口(SP):一套地址/数据,读写分时复用。一个模块自存取,最简单。
- 简单双口(SDP):一口只读、一口只写,地址/时钟可独立。异步 FIFO、写读分离缓冲最常用。
- 真双口(TDP):两口都能读能写、各自独立时钟。两边都要随机访问(双主设备、乒乓切换)时用;同地址同时写要处理冲突。
三、怎么写才推断成 BRAM
推断 BRAM 的 checklist:
- 同步访问:读写放在
always @(posedge clk)里。异步读(assign dout = mem[addr])综合成分布式 RAM/FF。 - 读地址寄存:地址先进寄存器再读,符合 BRAM 时序。
- 不要给存储内容加复位:BRAM 内容不支持复位,给
mem[]加复位会把它弹成一堆 FF。 - 需要输出寄存器就明确打拍:BRAM 输出可再寄存一级(
DOA_REG)提频率。 - 容量超过分布式阈值、索引规则(数组下标)。
简单双口 RAM 骨架(最常用,异步 FIFO 底层):
module sdp_ram #(parameter DW=16, AW=10)(
    input  wire wclk, we,
    input  wire [AW-1:0] waddr,
    input  wire [DW-1:0] wdata,
    input  wire rclk, re,
    input  wire [AW-1:0] raddr,
    output reg  [DW-1:0] rdata
);
    (* ram_style = "block" *) reg [DW-1:0] mem [0:2**AW-1];

    always @(posedge wclk)           // 写口
        if (we) mem[waddr] <= wdata;

    always @(posedge rclk)           // 读口(同步读→BRAM)
        if (re) rdata <= mem[raddr]; // 再打一拍可加输出寄存器提频
endmodule
四、读写模式、ROM 与初始化
BRAM 写时读行为三种模式(写同一地址):
WRITE_FIRST:写的同时输出新写入的数据(透传);READ_FIRST:输出该地址旧数据,再写入;NO_CHANGE:写时读口保持不变(省电、常用)。
IP 里可选;手写行为模型时要和选定模式一致。
ROM:内容不变,用数组 + 初始化。
(* rom_style = "block" *) reg [15:0] coeff_rom [0:1023];
initial $readmemh("coeff.hex", coeff_rom);   // 或用 case 给初值
always @(posedge clk) rom_out <= coeff_rom[addr];
小 ROM 可 case 常量初始化(综合成 LUT/BRAM),大 ROM 用 $readmemh 读 .mem/.hex(Vivado 用 .coe),适合滤波器系数、查找表、码字表。
五、乒乓缓存与行缓存
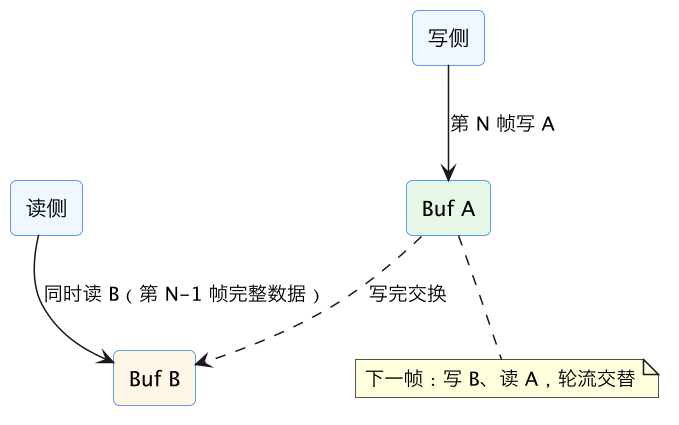
乒乓(ping-pong):写一块、读另一块,写完一整块交换——读写并行、读侧永远拿到完整块,代价双倍存储 + 切换握手。视频帧/行、DMA 双缓冲、AXI 缓冲都用它。
六、位宽、带宽与配置
- 宽×深折算:BRAM 可配置多种宽深组合(如 36Kb 可配 36bit×1024、72bit×512),位宽超过原生会级联多块;按带宽选位宽、按容量选深度。
- 带宽:BRAM 双口每周期每口最多一次读/写(带输出寄存器后吞吐 1 个/周期),超带宽要拆多块并行(交错 bank)。
- 跨时钟:SDP/TDP 两口可接不同时钟,就是双口 RAM 跨时钟用法(配合 异步 FIFO 或握手)。
- 输出寄存器:BRAM 输出再打一拍(内部 DOA_REG)几乎免费地把读频率拉到最高,时序收敛 里大存储务必打拍。
七、资源核对与典型现象
| 现象 | 可能原因 | 排查/做法 |
|---|---|---|
| 数组变成海量 LUT/FF | 异步读/加了复位/太小 | 同步读、不加复位、ram_style="block" |
| RAM 能跑但频率低 | 没用输出寄存器 | 输出再打一拍(DOA_REG) |
| 读到半成品数据 | 读写同块未隔离 | 用乒乓/双缓冲,读完再交换 |
| 大缓冲耗尽 BRAM | 没用 URAM/位宽过宽 | 上 URAM、降位宽、bank 交错 |
| ROM 值不对 | 初始化文件路径/格式错 | 核对 .hex/.coe、$readmemh |
| 双口同址写冲突 | TDP 两端口写同地址 | 逻辑上避免或定义优先级 |
写完查 Report Utilization 的 Block RAM/URAM 计数;若 RAM 全落在 LUT/FF 上,按第三节 checklist 改代码强制 block。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 异步读数组 | 分布式 RAM/FF,占逻辑 | always @(posedge clk) 同步读 |
| 给 mem 加复位 | 弹成一堆 FF | 存储内容不复位,靠初始化 |
| 大数组用 FF | LUT/FF 爆、时序差 | ram_style=block/ultra |
| 输出不打拍 | BRAM 读频率上不去 | 开输出寄存器打一拍 |
| 读写同一块缓冲 | 读到半完成数据 | 乒乓/双缓冲 + 交换握手 |
| 小 ROM 也用 BRAM | 浪费、占块 | 小用 case/LUT,大用 ROM+mem |
相关与延伸
前置:FIFO 设计(FIFO 底层即双口 BRAM)、DSP48 与算术(数据通路两硬核)、时序收敛。 后续:视频/图像流水线的行缓存/帧缓存见规划 #32;IP 总览见 常用 IP 核。
一句话总结
FPGA 大存储靠专用硬核:小而快的局部缓冲用分布式 RAM(LUT)、中大块主力用 Block RAM(18/36Kb 双口)、超大数组用 URAM(288Kb);端口按「谁读写/几时钟域」选——单口 SP 自用、简单双口 SDP(一写一读、可异步时钟)是异步 FIFO 和写读分离缓冲的底层、真双口 TDP 两边都随机读写;要让数组推断成 BRAM,必须同步读(always @(posedge clk))、读地址寄存、存储内容不加复位(加了会弹成一堆 FF),再用输出寄存器打一拍免费提频,必要时 (* ram_style="block" *) 强制;ROM 用 case(小)或 $readmemh/.coe(大)初始化,注意 WRITE_FIRST/READ_FIRST/NO_CHANGE 写时读行为;数据生产消费并行用乒乓缓存(写 A 读 B、写完交换,读侧永远拿完整块)、图像卷积用行缓存省整帧存储——核心心法和 DSP 篇对称:把算术喂给 DSP、把存储喂给 BRAM/URAM、能打拍就打拍,写完查 Utilization 确认存储真的落进硬核而不是 LUT/FF。