时序驱动布局:全局布局的 net weighting、虚拟 RC 与迭代收敛机制深讲
更新时间:2026-10-02。布局是物理实现里「一步错、步步错」的环节:单元摆歪了,后面 CTS、布线、ECO 花十倍力气也救不回来。本站 数据流 S3 之 floorplan 与 place 讲了布局在数据流里的位置,布局拥塞与 cell padding 讲了密度侧的手艺,CTS 时钟树综合 讲了布局完成后的下一步。这一篇聚焦全局布局(global placement)引擎内部最核心的一条机制——时序驱动:布局器明明只看得见单元和网络,它怎么知道哪条路径「紧」?它既没有真正布线,怎么估计延迟?它又怎么在「线长最短」和「时序最优」两个互相打架的目标之间收敛?答案就是 net weighting、虚拟 RC 和迭代收敛这三件套。看懂它们,你才能读懂布局日志里的 WNS 曲线,才知道时序差的时候该调权重、调约束还是回头修 floorplan。
本文要回答的问题
- 时序驱动布局解决的根本矛盾是什么,纯线长驱动的布局会把设计坑成什么样?
- net weighting 怎么把 slack 翻译成权重,关键网和普通网的待遇差在哪?
- 全局布局阶段没有真实布线,虚拟 RC 用什么模型估计延迟,误差有多大?
- 布局器为什么要跑多轮「布局-时序分析-更新权重」迭代,收敛判据是什么?
- 时序驱动和拥塞、密度、功耗目标怎么调和,实战中怎么读日志和调参数?
一、为什么布局必须时序驱动:线长最优不等于时序最优
先看没有时序驱动会发生什么。全局布局的原始目标函数很简单:把所有标准单元摆进 row 里、彼此不重叠,同时让总半周长线长(HPWL,Half-Perimeter Wirelength)最小。HPWL 最小化是个漂亮的数学问题,现代布局器(无论是力导向、解析式还是近年流行的 GPU 加速梯度法)都能解得又快又好。问题出在物理事实上:线长最短 ≠ 延迟最小 ≠ 时序收敛。
原因有三层。第一,HPWL 是对所有网络一视同仁的——一条扇出 2 的控制信号和一条在关键路径上的数据总线,权重完全相同。布局器为了全局线长最优,可能把关键路径上的几个单元摊得很开,只因为它「顺手」填补了密度空隙。第二,时序是路径级概念而线长是网络级概念:一条路径经过十几个网络,每个网络单独看都不长,串起来就是 500 微米的绕线,setup 直接崩。第三,全局布局阶段还不知道时钟树长什么样(CTS 在布局之后才做),setup 的悲观度里还埋着 clock latency 的不确定项,布局必须在信息不全的情况下做决策。
时序驱动布局(timing-driven placement)做的事,用一句话说:把静态时序分析(STA)的 slack 信息注入布局目标函数,让布局器在摆单元的时候就知道「这条网慢不得」。注入的方式有三代:最早是 net delay constraint(给关键网直接设线长上限,超了算违规),工程上太脆,已经基本淘汰;主流是 net weighting(把 slack 映射成权重乘进目标函数);更精细的是 path-based 方法(在目标函数里直接对关键路径的延迟建模)。现代商用工具是 net weighting 为骨干、局部叠加 path-based 精化的混合架构。本篇的主线就是把这条机制链拆开讲。
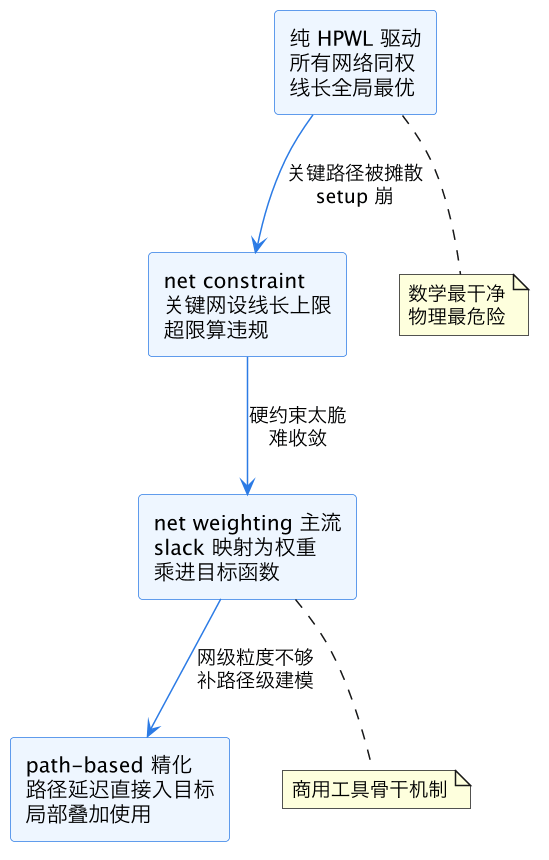
上图是三代机制的演进。要读的重点不是「新的推翻旧的」,而是分层共存:今天的布局器里 HPWL 依然是目标函数的底座,net weighting 是调制项,path-based 是关键区域的放大器。理解这个分层,后面看目标函数公式时就不会迷惑。
二、net weighting:把 slack 翻译成布局器听得懂的语言
net weighting 的原理一句话:每条网络 i 在目标函数里的贡献是 w_i × L_i(权重乘线长),slack 越负(或越接近零)的网络权重越大,布局器在优化时就会优先压缩这些网络的线长。整个机制的关键在「slack 到权重」的映射函数,各家工具细节不公开,但形状大同小异。
映射的设计直觉是这样:给所有网络先跑一次增量时序分析,拿到每条网络的 worst slack(经过它的所有路径中最差的那条)。然后定一个目标 slack(通常取 WNS 的某个分位数或一个略悲观的固定值),权重按 slack 与目标的差距增长——常见的是分段函数:slack 比目标宽松很多的网络权重保持 1(不特殊照顾);进入「警戒带」的网络权重线性或二次上升;最差的一批网络权重封顶(比如 5 到 20 倍),封顶是为了防止少量关键网彻底支配布局、把密度和可布性搞崩。
这个设计里藏着三个工程权衡。第一,权重必须是「软」的:如果某个网络权重无穷大,布局器会为了它把周围单元挤成密度热点,换来的时序收益被拥塞惩罚吃回去,这就是 布局拥塞与 cell padding 那篇讲的密度-时序拉锯。第二,映射要用 worst slack 而不是路径数加权——一条网络上挂着一百条 -0.01ns 的路径不可怕,挂一条 -0.3ns 的才致命,worst-case 语义和签核一致。第三,权重更新有滞后:布局变了 slack 就变了,用旧 slack 算的新权重只是近似,这正是第三节要讲的迭代结构存在的原因。
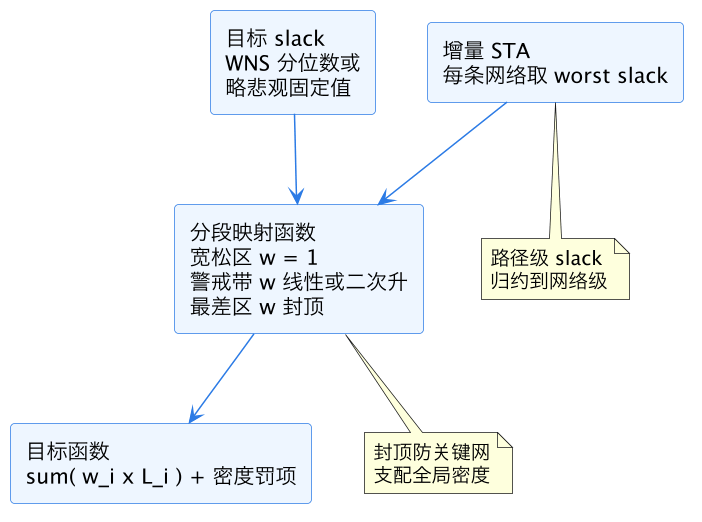
这张图是 net weighting 的数据流。注意映射函数的三个分段对应三种治理策略:宽松区「不打扰」,警戒带「倾斜资源」,最差区「重点照顾但有上限」。实战里调布局时序,很大一部分就是在调这个函数的目标值和封顶值——目标设太松,布局器不作为;设太紧,全网都「关键」,等于没有优先级。
| 映射参数 | 设松了的后果 | 设紧了的后果 | 经验起点 |
|---|---|---|---|
| 目标 slack | 布局时序收益小,靠 ECO 硬补 | 全网权重膨胀,密度热点 | 取布局前预估 WNS 的 70%-80% |
| 权重封顶值 | 最差路径救不动 | 少量网络撕裂全局线长 | 5-20 倍,随设计规模调 |
| 警戒带宽度 | 中等风险路径无人管 | 权重分布扁平失去区分度 | 覆盖 WNS 到 0 之间的网络 |
上表是调参时的方向感。记住一个总原则:net weighting 是资源分配机制,它不能创造裕量,只能把全局线长预算向关键网络倾斜——倾斜过头,非关键网络的总代价会超过关键网络的收益。
三、虚拟 RC:没有布线,延迟从哪来
net weighting 的前提是「能算出 slack」,而 slack 需要延迟,延迟需要寄生参数——可全局布局阶段连一根线都还没布。这个鸡生蛋问题靠虚拟 RC(virtual RC / placement-stage parasitic estimation)解决:根据单元位置和扇出,预测每条网络的等效电阻电容。
预测的输入是布局器确切知道的东西:驱动单元和目标单元的曼哈顿距离(或 HPWL 估算的走线长度)、扇出数、所在区域的布线层资源密度。预测的模型分三档精度。最粗的是 WLM(wireload model,线负载模型):综合时代传下来的按扇出查表的长度-RC 曲线,全局布局早期用它快速起步,本站 数据流 S3 里提过它从综合到布局的交接角色。中档是 Steiner 树或 FLUTE 类快速拓扑估计:对每条网络构造一棵近似布线树,按树的长度和分支分布估 RC 和 Elmore 延迟,这是全局布局中后期的主力,精度和真实全局布线的相关性已经相当高。最精的一档是直接调全局布线器(global route)做 trial route,拿真实走线层分配和近似过孔数回注寄生——这已经摸到下一阶段的边界,只有迭代后期或时序特别紧的设计才用得起。
虚拟 RC 的系统性误差要心里有数。它通常低估实际 RC:真实布线要绕开拥塞、要换层、要留串扰间距,布线拥塞 DRC 与串扰 讲的那些效应在虚拟阶段都不存在。所以成熟流程会给虚拟 RC 乘一个不确定性因子(10% 到 30%,拥塞预期高的设计取大值),这等价于给布局阶段的时序预算留一笔「布线税」。这个因子设多大,直接决定布局和布线两个阶段谁来扛时序压力。
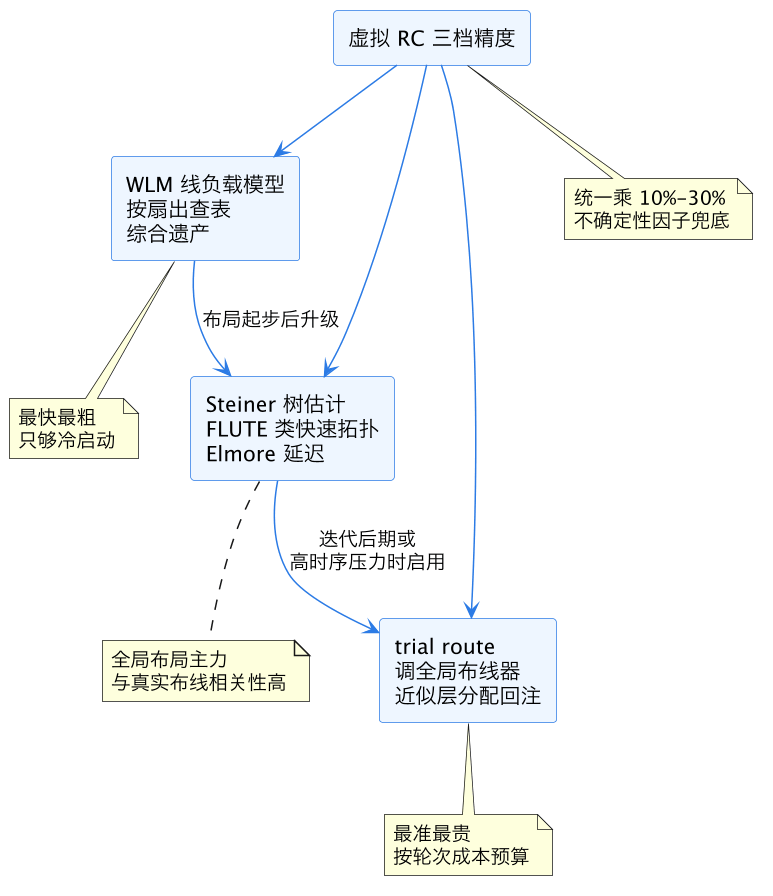
这张图的读法是「精度换速度」的阶梯:布局早期的几万次移动只配得起 WLM,中期几十轮迭代用 Steiner 树,临门一脚才上 trial route。阶梯爬错位置是常见的性能事故——全程 trial route 的布局器一晚跑不完一轮,全程 WLM 的布局器时序方向感是歪的。
四、迭代收敛:布局与时序分析的握手协议
有了权重机制和延迟估计,布局器的主循环长这样:摆一轮 → 用虚拟 RC 跑增量 STA → 按新 slack 更新 net weight → 把新权重喂回目标函数再摆一轮。这个循环通常跑 3 到 10 轮,直到收敛。
为什么必须迭代?因为这是个不动点问题:权重依赖 slack,slack 依赖布局,布局依赖权重。一轮到位是不可能的——第一轮的 slack 基于一个很粗糙的初始布局(甚至随机或纯 HPWL 布局),用它算出的权重只能指出大致方向;摆第二轮之后关键路径的成员都变了(原来不紧的路径因为邻居变挤而变紧,原来紧的被压下去了),必须重算。这和 ECO 阶段的 what-if 迭代是同构的,PR 时序收敛 ECO 里的「改-算-再改」循环在布局内部提前上演了一遍。
收敛判据看什么?三个信号。其一,WNS(最差负裕量)和 TNS(总负裕量)曲线进入平台期——连续两轮改善小于某个阈值(比如 TNS 改善 < 2%),说明权重调制已经榨干。其二,关键路径集合稳定:连续两轮 top 100 违例路径的交集超过八九成,说明时序图景不再剧烈变化,继续摆只会原地抖动。其三,密度罚项和线长罚项不再恶化——时序收益若以密度持续恶化为代价,收敛就是假收敛,布线阶段会还回来。现代布局器(特别是解析式 + 梯度的那一类)还常把时序项直接做成可微的软约束揉进梯度下降里,让「时序-线长-密度」在一个连续的优化空间里同时求解,这比外层离散迭代更平滑,但计算预算和调参难度都更高。
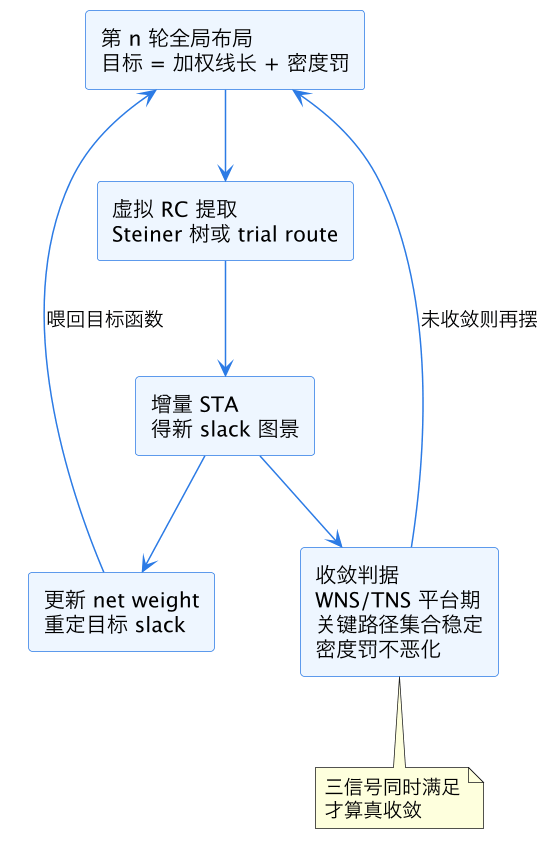
这张闭环图是时序驱动布局的「引擎剖面」。读图时盯住两条回边:weight 回 place 是机制回路(每轮必走),conv 回 place 是控制回路(收敛才退出)。两轮之间关键路径成员会换血,这就是为什么「第一轮就把权重函数调得极凶」是反模式——你在为一个即将过时的时序图景倾尽资源。
还有一个经常踩的坑:布局阶段的时序图景和签核图景之间隔着 CTS。布局时时钟是理想化的(ideal clock 或预估 latency),setup 悲观度和真实有系统性差异。所以成熟流程在布局的收敛判据里还会留一个「CTS 预算」:布局出来的 WNS 不能贴着零收敛,要预留几十到上百皮秒给时钟树的不确定性,useful skew 与 CTS 优化 讲的有用偏差也要在这笔预算里打主意。
五、多目标调和与实战调参
时序不是布局的唯一目标。真实的目标函数里至少还有:密度罚项(防局部过热,可布性的前提)、线长底座(功耗和可布性都靠它)、以及可选的功耗项(高翻转网络压线长,借 数据流之 VCD/SAIF 活动率 的活动率数据加权)。这些目标互相打架:压时序要挤单元,挤单元伤密度;压密度要摊单元,摊单元涨线长;线长涨,时序又坏。布局器本质上是在解一个带权多目标优化,权重配比就是工程师的手艺所在。
实战读日志,看四条曲线就够了:WNS、TNS、加权 HPWL、密度热点数(overflow)。健康的收敛形态是 WNS 快速改善后进入平台,TNS 持续缓慢下降,HPWL 前两三轮回升(为时序让路)随后稳定,overflow 单调下降。病态形态也好认:WNS 改善但 TNS 恶化——权重只照顾了最差路径,中腰部路径集体牺牲,该拉宽警戒带;HPWL 持续猛涨——权重封顶太高或目标太紧,时序在透支全局;overflow 不降反升——密度罚项权重不够,时序项在硬挤。
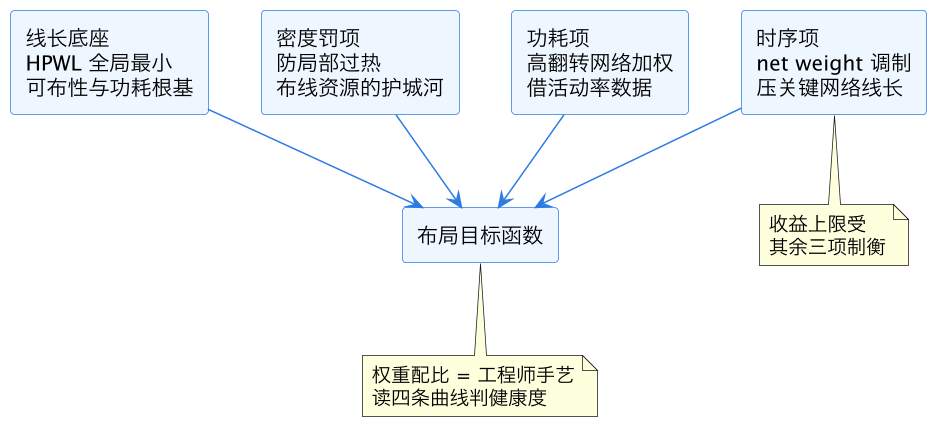
这张图把目标函数拆成四个成分。要点是制衡关系:时序项的上限从来不是自己定的,而是其余三项愿意让出多少。所以「布局时序差」的排查顺序应该是:先看权重映射是不是没生效(日志里关键网权重是否拉满),再看虚拟 RC 因子是不是太乐观(和全局布线后的寄生对拍),再看密度罚项是不是在和时序项打架(热点区和关键路径区域是否重叠),最后才回头怀疑 floorplan——宏单元摆位、电压域形状这些上游决策对时序的影响是结构性的,布局器调权重救不回来,该回 floorplan 与 powerplan 层面修就果断回去。
| 症状 | 首选检查 | 典型对策 |
|---|---|---|
| WNS 好 TNS 差 | 警戒带宽度 | 拉宽警戒带,中腰部加权 |
| HPWL 暴涨 | 权重封顶与目标 slack | 降封顶,目标回调到分位数 |
| 关键区密度热点 | 密度罚权重 | 提密度罚,或关键路径用 cell padding |
| 布局后布线时序崩 | 虚拟 RC 因子 | 加大不确定性因子,留布线税 |
| 时钟相关违例成片 | CTS 预算 | 布局收敛线预留 latency 余量 |
上表是布局时序问题的速查表,五种症状对应五种不同的病根,混用对策(不管什么症状都加大权重)是最常见的翻车方式。
六、和上下游的接口:时序驱动布局在流程里的位置
最后把视野拉回全流程。时序驱动布局的输入质量决定它的天花板:上游综合给的网表如果时序结构本身就差(逻辑级数太深、复用度不合理),布局再怎么倾斜线长预算也只是把烂时序摆得更整齐;约束质量同样关键,SDC 里一个漏写的 false path 会让布局器给一条根本不存在的「关键路径」倾注资源,约束生命周期见 数据流之 SDC 生命周期。下游侧,布局交付的 DEF 带着密度分布和时序余量进入 CTS 和布线,数据流 S4 之 CTS 与 route 接棒;签核侧的布局后时序虽然还只是虚拟 RC 口径,但它是第一个有物理真实性的时序检查点,Signoff STA 与 PrimeTime 那套报告读法从这里就开始用了。
一句话概括上下游契约:综合给布局一个「可摆」的时序结构,布局给 CTS 和布线一个「可收」的物理起点。时序驱动机制(net weighting 倾斜资源、虚拟 RC 提供方向感、迭代收敛榨干收益)就是让这份契约可兑现的引擎。
这一篇在知识体系里的位置
本篇是 eda/ 目录物理实现线的布局枢纽文,向上承接 数据流 S3 之 floorplan 与 place 的流程定位与 floorplan 与 powerplan 的上游结构决策,横向连接密度侧手艺(布局拥塞与 cell padding)、约束侧(数据流之 SDC 生命周期)、活动率数据(数据流之 VCD/SAIF 活动率);向下接时钟与布线(CTS 时钟树综合、useful skew 与 CTS 优化、数据流 S4 之 CTS 与 route、布线拥塞 DRC 与串扰),以及收敛与签核落地(PR 时序收敛 ECO、Signoff STA 与 PrimeTime)。读完本篇再去看布局器日志里的权重和 slack 曲线,每一根线都知道它在说什么。
总结
时序驱动布局让全局布局器在摆单元时即为关键路径让路:net weighting 把每条网络的 worst slack 经分段映射翻译成线长权重(宽松不打扰、警戒带倾斜、最差区封顶),虚拟 RC 用「WLM-Steiner 树-trial route」三档估计在未布线时给出延迟方向感并乘不确定性因子预留布线税,布局-提参-增量 STA-更新权重的迭代循环以 WNS/TNS 平台期、关键路径集合稳定、密度罚不恶化为收敛判据;实战中时序项与线长、密度、功耗四项目标互相制衡,读 WNS/TNS/HPWL/overflow 四条曲线判健康度,权重映射失效、RC 因子过乐观、密度热点、CTS 预算不足各有对应病根,上游网表与约束质量决定这套机制的天花板。