多 Die / SSI FPGA:SLR 分区与跨 die 互连
更新时间:2026-10-01。当单片 FPGA 容量逼近制造极限,厂商把多个 die 封在同一器件里。对用户它呈现为一颗芯片,物理上却是几颗 die 并排躺在硅中介层上。用得好,容量、带宽和 I/O 数量都上一个台阶;忽视 SLR 边界,时序和拥塞会双双恶化,而且这种恶化用常规的打拍优化很难救回来。本篇把多 Die SSI FPGA 从制造动机、物理结构讲到 floorplanning 与时序收敛的完整工程方法;单 die 的基本结构可先回看 FPGA 芯片结构详解——从 LUT/FF 到 CLB、互联、时钟与 I/O。
本文要回答的问题
- 为什么厂商不把 FPGA 继续做成一颗大 die,而要封多个 die?良率账是怎么算的?
- 一个器件里的多个 SLR 在物理上怎么排列、怎么连起来?SLL 到底是什么走线?
- 跨 SLR 路径慢在哪里、带宽为什么有限,时钟跨边界又有什么讲究?
- 怎么做 SLR assignment 和 pblock 约束,才能让工具稳定收敛而不是和它博弈?
- 多 die 和同等工艺的单 die 器件,选型时该怎么取舍?大设计怎么拆分才不吃亏?
一、为什么 FPGA 要做成多 die:良率、容量与功耗
先算一笔制造账。芯片良率随面积近似指数下降:假设单位面积缺陷率固定,一颗 die 面积翻倍,撞上随机缺陷的概率远不止翻倍。FPGA 又是所有芯片里 die 面积最大的一类——旗舰器件要塞进数百万逻辑单元、数千个 DSP、数十 MB BRAM 和几十条高速收发器,单 die 面积直逼光刻工艺的极限(reticle limit,光罩尺寸上限),继续做大不是设计不出来,而是造出来的好片不够摊成本。
多 die 的思路是把同一颗器件拆成 N 个面积可控的小 die:每个小 die 良率高,封装前可以先测试筛选,只把好 die 拼进器件;坏 die 直接淘汰,不会让一整颗大芯片报废。再配合硅中介层(silicon interposer)把 die 间互连密度做到接近片内水平,用户看到的仍是一颗容量翻倍的 FPGA。
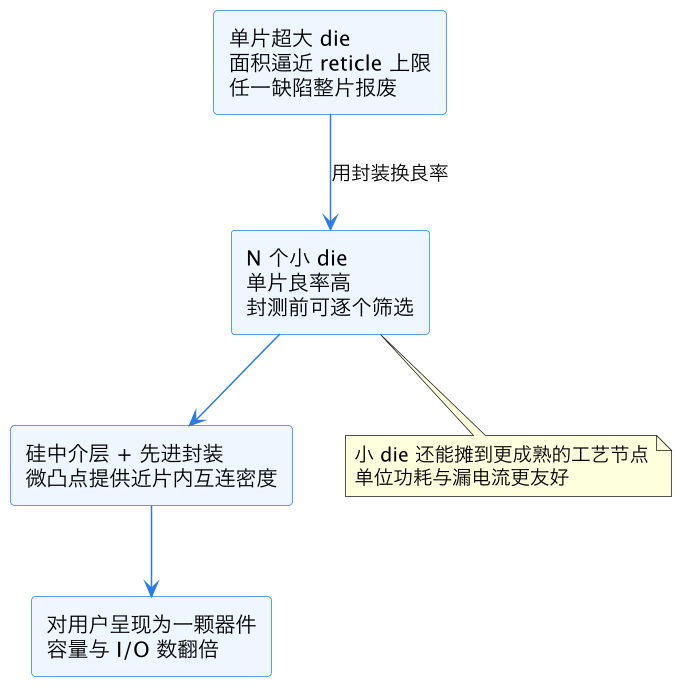
这张图概括了多 die 的经济逻辑:制造问题被转移到了封装环节。代价也写在图里——die 间再近也不是片内,于是有了中介层成本、有了跨 die 互连这一类新资源,后面所有工程约束都从这里派生。功耗上也有账:小 die 的供电压降和热密度更均匀,旗舰器件可以在不把单点开尔文温度推到极限的前提下继续堆容量,多 Die SSI FPGA 的功耗与热协同需要结合功耗签核与热设计一起看。
| 维度 | 单片大 die | 多 die / SSI |
|---|---|---|
| 良率模型 | 面积越大指数级恶化 | 小 die 良率高,封测前筛选 |
| 容量上限 | 受 reticle 尺寸死锁 | 靠 die 数量横向扩展 |
| die 间通信 | 不存在该问题 | 走中介层,延迟/带宽有界 |
| 供电与热 | 单 die 热点集中 | 多 die 摊薄,但可能分布不均 |
| 用户视角 | 一颗均匀芯片 | 一颗芯片,但内部非均匀 |
二、SSI 物理结构:中介层、微凸点与 SLR
以典型的三 SLR 器件为例,三个 FPGA die 并排贴在一片硅中介层上,die 与中介层之间通过微凸点(microbump)连接,中介层内部用重布线层实现 die 间走线,整体再经凸点落到封装基板上。每个 die 在工具里被称为一个 SLR(super logic region,超逻辑区域),它拥有完整的 FPGA 资源:可配置逻辑块、BRAM、DSP、时钟区域、I/O 列,die 内还挂着一部分高速收发器。
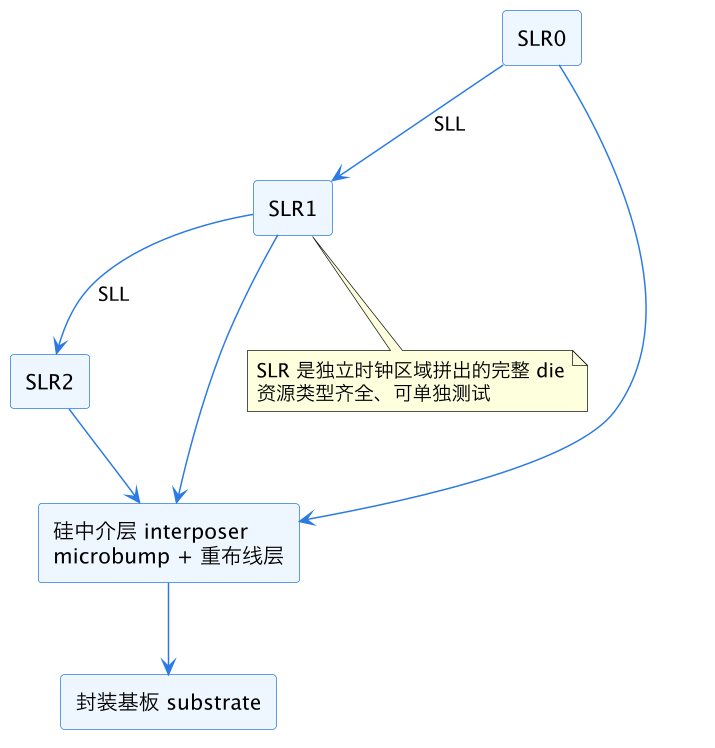
这张截面图要读出两个重点。第一,相邻 SLR 之间的跨 die 连线在工具里叫 SLL(super long line,超长线),它不是 FPGA 常规布线轨,而是数量有限、位置固定的专用通道;不相邻的 SLR 要通信,路径必须穿过中间 SLR,占用中间 SLR 边界两侧的 SLL 和内部走线。第二,SLR 边界对用户工具是可见的:Vivado 器件视图里明确画出三条 die,布线报告里单独统计跨 SLR 信号数——物理结构没有被抽象掉,这正是多 die 设计要求人显式介入的根本原因。
三、SLR 间互连:SLL 的延迟、带宽与时钟
跨 SLR 的代价可以拆成三笔。延迟上,信号要经过微凸点上下中介层,加上 SLL 本身的长线延迟,一次跨 SLR 的线延迟显著大于 die 内最长走线;跨两个边界(SLR0 到 SLR2)近似翻倍。带宽上,SLL 总数有硬上限,一条几百 bit 的数据总线跨过去就要占几百条,边界信号数一旦逼近上限,工具要么绕远(延迟进一步恶化),要么直接报不可布线。时钟上,每个 SLR 是独立的时钟区域拼片,全局时钟跨 SLR 需要靠专用时钟缓冲和分布资源驱动,不能假设时钟树像单 die 那样天然均衡。
| 特征 | die 内互连 | 跨 SLR(SLL) |
|---|---|---|
| 走线介质 | 片内布线轨 | 经微凸点走中介层 |
| 线延迟 | 短,可被常规布局优化吸收 | 长,量级显著更大 |
| 资源数量 | 丰富 | 固定且有限,有硬上限 |
| 非相邻 SLR | 不适用 | 必须穿过中间 SLR |
| 时钟传播 | 同一时钟树内 | 需跨 die 时钟规划 |
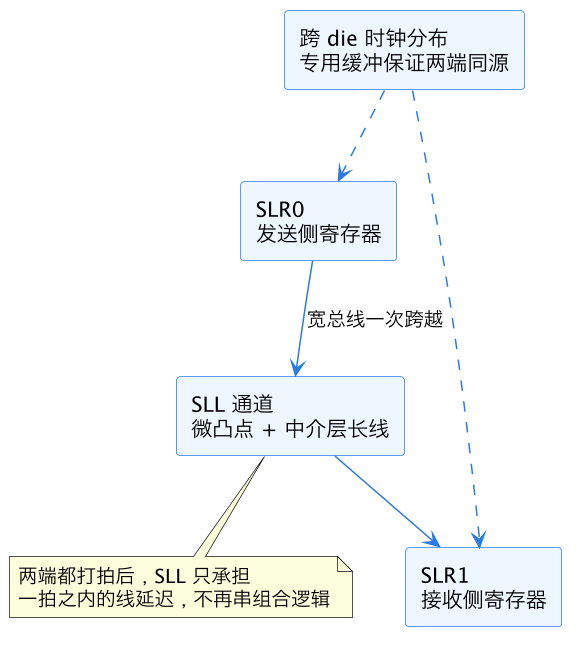
图里给出了跨 SLR 接口的标准形态:边界两侧各放一级寄存器,中间的 SLL 只承担纯走线。这样 SLL 的固定延迟被关在一个时钟周期里,不再和两侧的组合逻辑相加。反过来看最糟的形态:组合逻辑从 SLR0 发起、跨 SLL、在 SLR1 继续做 LUT 判决再到终点寄存器,一条路径上同时吃到函数延迟加两次线延迟,约束再松也很难收敛。时钟方面,同一时钟跨 SLR 时要确认工具把它布在全局时钟资源上;如果两端本来就属于不同时钟域,则应直接按 CDC 处理,方法见 跨时钟域 CDC——亚稳态、MTBF 与单 bit 两级同步器。
四、跨 SLR floorplanning:SLR assignment 与 pblock
多 die 设计的核心动作不是事后修时序,而是在分区阶段就把数据流和物理 die 对齐。通用原则是高内聚、宽接口:强耦合、来回握手多的模块必须落在同一 SLR;必须跨边界的,整理成少量、方向明确、寄存器切片化的宽总线。典型的处理流水线型设计天然好分——SLR0 放采集与网络入口,SLR1 放主计算阵列,SLR2 放 DDR 与主机出口,数据单向流过两个边界,控制面单独收敛到一个 SLR。
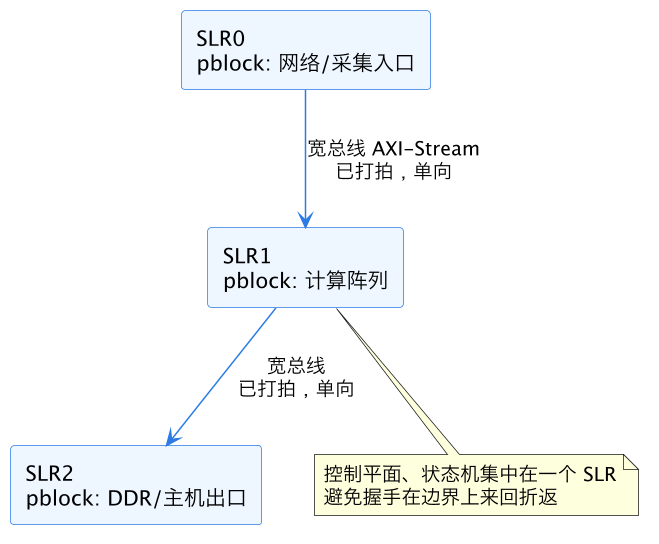
这张 floorplan 图里每个功能块都应该用 pblock 显式约束到对应 SLR,而不是指望工具自己悟。实操要点有四个:其一,pblock 范围按 SLR 边界画整,模块占片率留出裕量(经验上不超过 SLR 容量的 80% 左右),给工具留布局自由度;其二,跨 SLR 总线用接口级约束统一定义,在 HDL 里就把信号打包成 interface,避免几十个散信号各走各的;其三,为每个边界设跨 die 信号预算,例如单边界不超过 SLL 容量的六七成,布局后用报告核对;其四,IP 核例化前查手册,大容量 IP(如大位宽 FIFO、交织存储器)本身可能强制占多 SLR,分区时要把它的跨界算进预算,而不是当成黑盒。
五、跨 SLR 时序收敛:打拍、异步化与拥塞治理
就算分区合理,接口形态不对仍会翻车。对每一条必须跨 SLR 的信号,按下面对号入座:
| 信号类型 | 推荐处理 | 不推荐 |
|---|---|---|
| 同源宽数据总线 | 边界两侧寄存器切片,单向传输 | 跨边界做 valid/ready 组合折返 |
| 单 bit 控制/状态 | 电平同步器或脉冲同步器 | 直接跨边界当本级信号用 |
| 两端不同时钟域 | 异步 FIFO / 异步握手,按 CDC 签核 | 虚假路径一禁了之 |
| 高频扇出广播 | 在每个 SLR 内复制寄存器,就近分发 | 单点驱动横跨三 die |
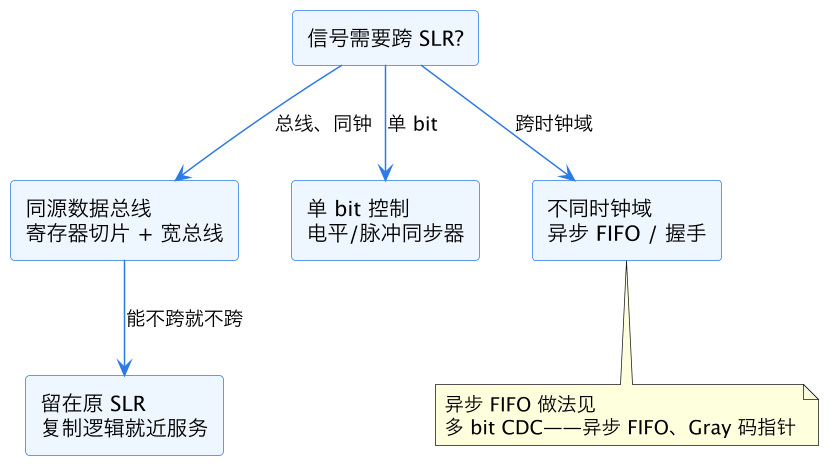
这张判定流程覆盖了收敛阶段 90% 的决策。值得单独强调的是反直觉的一条:跨 SLR 的 ready/valid 握手不要做成组合环。很多 RTL 在 die 内工作多年,ready 由下游组合算出反向传回,延迟一拍后吞吐不变;跨了 SLL,这个反向回跳和正向数据拼成跨 die 往返路径,时序直接爆掉。标准做法是边界处转成 skid buffer 或事务信用(credit)协议,让每个方向都是寄存输出、单向流动。
拥塞治理看两个报告:跨 die 信号计数和边界处布线拥塞热图。超 SLL 预算时优先减少跨 die 信号——把控制逻辑搬回数据源所在 SLR、把零散状态聚成总线、在边界 SLR 复制小 ROM/配置表,都比放松约束有效。多 die 场景下的多角点签核(快角慢角、不同电压)一个都不能少,完整流程见 FPGA 时序签核——多角点、跨角点 hold、OCV 与收敛治理流程;如果跨边界后两端干脆用独立时钟、只交换数据块,那本质上是把 SSI 器件当成三颗协同 die 用,异步设计纪律见 多 bit CDC——异步 FIFO、Gray 码指针与空满判断。
六、单 die 还是多 die:选型与大设计拆分策略
多 die 不是免费容量,选型时要回答两个问题:资源是否真的装不下,以及数据流是否切得开。如果设计在同工艺单 die 器件里放得下,优先单 die——没有 SLL 预算、没有跨 die 时钟、工具优化自由度最大,签核风险低一档。只有单 die 容量、I/O 数量或收发器数量确实不够时,多 die 才值得引入,而一旦引入,架构阶段就要按 die 切分,而不是 RTL 冻结后再 floorplan 补救。
| 判据 | 倾向单 die | 倾向多 die / SSI |
|---|---|---|
| 逻辑占用 | 单 die 可容纳 | 超出最大单 die |
| 高速收发器 / I/O | 数量需求低 | 需要数十条以上 |
| 数据流形态 | 全局耦合、共享存储多 | 流水线清晰、可单向切块 |
| 时序裕量 | 已紧张 | 打拍后接口仍有余量 |
| 团队 floorplan 经验 | 弱 | 有 pblock/分区签核经验 |
大设计拆分有三条实用策略。第一,按数据流纵向切,而不是按功能平均切:让每个 SLR 承担流水线上一段,边界天然是宽而浅的流接口。第二,控制面集中:寄存器配置、中断聚合、时钟/复位管理放一个 SLR,再以树形扇出,避免每个模块都跨 die 取配置。第三,重资源就近原则:BRAM/DDR 控制器挂在使用它的模块所在 SLR 一侧,大容量缓冲的跨 die 读写本身就是带宽杀手。另外多 die 器件的配置比特流更大、启动分 die 加载,配置与调试的差异在 部分可重配置 PR 深水区——分区设计、ICAP、动态比特流与在线升级 的分区管理思路同样适用;热在各 SLR 分布不均时还要结合 FPGA 热设计:结温、热阻、散热与降额可靠性 评估降额。
七、常见坑
- 不做 SLR 规划直接跑实现:工具随机放置,关键路径恰好跨 die,时序报告一片红且无从下手。
- 让窄而时序敏感的控制信号跨 SLR:一条往返握手的线毁掉整个时钟周期预算。
- 跨 die 接口不打拍:长组合路径叠加 SLL 线延迟,任何优化等级都救不动。
- 跨 die 信号数超出 SLL 带宽:边界拥塞,工具绕远后延迟恶化连锁出现。
- 把多 die 当成完全均匀的单 die:忽视跨 die 时钟分布、分 die 配置和热分布差异。
- 平均主义切分:每块功能各占一点,每个边界都有大量双向流量,不如按流水线纵向切。
- 用 false path 掩盖跨 die 问题:禁掉的约束会在硅片上以 CDC 故障的形式还回来。
这一篇在知识体系里的位置
- 向上承接:FPGA 芯片结构详解——从 LUT/FF 到 CLB、互联、时钟与 I/O 给出单 die 内的资源与布线模型,本篇把模型扩展到多 die 封装。
- 方法支撑:时序收敛方法——打拍/retiming、综合实现策略、物理优化 Pblocks 与拥塞治理 与 高阶时序收敛——物理约束、Pblock、多角点与保持时间治理 是 pblock 和收敛手段的通用基础。
- 横向相关:时钟与 CDC 问题见 时钟网络与约束——多时钟、时钟组 set_clock_groups 与时钟规划;功耗、热与配置分别参照 FPGA 功耗签核——XPE 估算、矢量分析、热设计与动态功耗抑制、FPGA 热设计:结温、热阻、散热与降额可靠性 和 PR 分区管理。
总结
多 Die SSI FPGA 用硅中介层把多个良率可控的 SLR 拼成一颗容量翻倍的器件,代价是跨 SLR 的 SLL 延迟长、带宽有硬上限、时钟要跨 die 规划;取胜关键在架构阶段就按数据流纵向分区,用 pblock 把强耦合逻辑钉进同一 SLR,跨 die 只留寄存器切片化的单向宽总线、控制信号走同步器、跨时钟域走异步 FIFO,并以跨 die 信号预算和多角点签核守住边界——选型时单 die 放得下就不上多 die,上了多 die 就必须显式管理 die,而不是假装它还是一颗均匀的芯片。