SystemVerilog readmemh 激励加载:三种文件喂数模式怎么选
更新时间:2026-09-28。在验证平台里,「数据从文件进来」几乎是每个 testbench 都要做的事:给存储器灌初始值、喂测试向量、读 golden 期望结果做比对。SystemVerilog 字符串处理与文件 IO 那篇讲了通用的文件打开、逐行读、plusarg 切场景,本篇聚焦一个更具体的场景——readmemh 与激励加载模式:什么时候一行
$readmemh就够了,什么时候必须自己$fopen+$fscanf逐行解析。
本文要回答的问题
$readmemh和$readmemb的语法、文件格式、地址写法分别是什么?- 三种喂数模式(readmemh 直灌、$fopen 逐行解析、$fscanf 顺序读)各自适合什么场景?
- 怎么把文件数据加载进 DUT 内部存储器,前门和后门有什么区别?
- 读进来的期望结果怎么和 DUT 输出做 golden 比对?
- 用 readmemh 有哪些格式上的坑,X/Z、注释、越界怎么处理?
一、三种模式全景:先看选型,再看细节
文件激励加载说到底就三条路径,选错了后面全是返工:
| 模式 | 典型写法 | 数据落点 | 适合场景 | 不适合场景 |
|---|---|---|---|---|
$readmemh 直灌 | $readmemh("init.hex", mem); | 整个数组一次灌满 | ROM/RAM 初始化、golden 表 | 带控制字段的向量 |
$fopen + $fgets + $sscanf | 逐行读、按字段拆 | 事务对象/队列 | 每行含 地址+数据+控制 多字段 | 纯数据大文件(慢) |
$fopen + $fscanf | $fscanf(fd, "%h\n", v) | 逐个数值 | 规整的纯数值流、采样序列 | 含注释/变格式文件 |
一句话记忆:纯数据整块灌用 readmemh,多字段向量用 fgets+sscanf,纯数值流用 fscanf。三种模式的代码量、灵活度差别很大,先想清楚文件长什么样再动手。
二、$readmemh / $readmemb:一行搞定存储器初始化
$readmemh 是 SystemVerilog 里加载激励最省事的入口,一行调用就把文件内容灌进一个 unpacked 数组:
logic [31:0] rom [0:255];            // 目标存储器
logic [15:0] golden [0:1023];

initial begin
  $readmemh("rom_init.hex",  rom);   // 十六进制
  $readmemb("flags.bin",     flags); // 二进制
  // 可选:指定起止地址,只灌一段
  $readmemh("patch.hex", rom, 8'h10, 8'h1F);
end
文件格式规则
rom_init.hex 一个典型样子:
// 每行一个数据,空格/换行都是分隔符
DEADBEEF
0000_0001   @10   5A5A5A5A
@20
FFFF0000- 默认按数组下标顺序填充,从数组起始地址(或指定的 start 地址)开始,每读到一个数填一项。
@hh是地址跳转:下一个数直接写到地址 0xhh。例子里@10把5A5A5A5A填到 rom[0x10],@20把FFFF0000填到 rom[0x20],中间没填的项保持原值(未初始化就是 X)。//和/* */注释都支持;下划线_可用作可读性分隔符。- 数据宽度不足时高位补零,超宽时截断并给 warning;写
x、z也合法,会灌进对应的 4 态值。
常见用法对比
| 写法 | 效果 | 何时用 |
|---|---|---|
$readmemh(f, mem) | 从头灌到数组尾 | 完整镜像 |
$readmemh(f, mem, start) | 从 start 灌到尾 | 基址偏移的镜像 |
$readmemh(f, mem, start, end) | 只灌 [start,end] | 局部 patch |
文件里 @addr | 文件内自定位 | 稀疏初始化、多个片段合一文件 |
坑点:如果文件里 @addr 超出数组范围,多数仿真器给 warning 后丢弃该数据,不会报错;数据个数多于数组容量同理。回归时务必将 warning 计入检查项,别让它静默漏数。
三、把数据灌进 DUT 内部存储器:前门与后门
$readmemh 的第一个参数是路径,第二个是数组引用——它可以指向 testbench 自己的数组,也可以用层次路径直指 DUT 内部的存储器。这就是所谓「后门加载」:
initial begin
  // 后门:绕过总线,直接写 DUT 内部 mem 数组
  $readmemh("prog.hex", tb_top.dut.u_imem.mem);
end| 方式 | 路径 | 速度 | 真实度 | 适合 |
|---|---|---|---|---|
| 后门 readmemh | 层次路径直灌 | 极快(零仿真时间) | 不经过接口 | 指令 ROM、初始化 RAM |
| 前门总线写 | 通过 driver 走协议写 | 慢(每拍一个数) | 真实,顺带验证写路径 | 验证写通道本身 |
| bind/force | 结合 force/release 后门注入 | 快 | 可中途改写 | 故障注入、补丁 |
实战里的标准做法:初始化用后门,功能验证用前门。比如验证一块 DMA,固件镜像用 $readmemh 后门灌进指令存储器,几秒钟搞定;而 DMA 搬运数据的激励则走 AXI driver 前门打进去,因为你要验的就是这条路径。后门还有个隐性收益:reset 后不用等总线把几 KB 初始化数据逐笔写完,仿真启动快很多。更多后门验证技巧见 存储器后门访问与 Scoreboard。
四、$fopen + $fscanf / $fgets:向量文件的逐条驱动
当文件里每行不只是数据、还带有「什么时候发、发到哪、发什么」这类控制信息时,readmemh 就不够用了,要自己开文件解析。两种主流写法:
// 写法 A:$fscanf 顺序读数值,适合纯数值流
int fd;
int sample;
fd = $fopen("adc_samples.hex", "r");
if (fd == 0) $fatal(1, "open fail");
while (!$feof(fd)) begin
  if ($fscanf(fd, "%h\n", sample) == 1)
    sample_q.push_back(sample);
end
$fclose(fd);

// 写法 B:$fgets 读整行 + $sscanf 拆字段,适合多字段向量
string line;
int    addr, data, we;
while (!$feof(fd)) begin
  void'($fgets(line, fd));
  if (line.len() == 0 || line[0] == "/" ) continue;  // 跳过注释空行
  if ($sscanf(line, "%h %h %b", addr, data, we) == 3)
    drive_one(addr, data, we);
end
两种写法的分工:
$fscanf按格式串跨过空白顺序消费文件,遇到格式不符立即停;适合机器生成的规整文件(比如 MATLAB 导出的采样序列)。$fgets + $sscanf先把一行拿到手里再解析,容错与可调试性更好:可以跳过注释、打印出错行号、对$sscanf返回值做字段数检查。人手工维护的向量表强烈建议用这种。
逐条驱动的完整骨架通常是「文件 → 队列 → driver」,事务一层层抽象的细节见 事务抽象与 Driver。
五、golden 比对:把期望结果也装进存储器
激励加载的另一半是期望结果加载。把 golden 文件 $readmemh 进一个数组,DUT 输出按地址比对,是最经典的自检结构:
logic [31:0] golden [0:1023];
logic [31:0] actual [0:1023];
int errors = 0;

initial $readmemh("golden_out.hex", golden);

final begin
  // 后门把 DUT 结果存储器整体拷出来,或直接层次比对
  foreach (golden[i]) begin
    if (golden[i] !== tb_top.dut.u_mem.mem[i]) begin
      $display("MISMATCH @%0d exp=%h act=%h", i,
               golden[i], tb_top.dut.u_mem.mem[i]);
      errors++;
    end
  end
  if (errors) $error("total %0d mismatches", errors);
  else        $display("TEST PASSED");
end
几个细节值得注意:
- 用
!==做 4 态精确比较,X 也不会被当成 0 蒙混过关——这一点和 2 态/4 态与 X 传播 里讲的语义一致。 - 比对放
final块或check_phase里,确保所有输出都稳定了再查。 - golden 文件和激励文件成对管理:
vec_001_in.hex/vec_001_out.hex,用 plusarg 传用例名拼路径,一套代码跑整批向量(plusarg 的用法见 UVM 命令行参数)。
六、激励加载数据流:一张图串起来
把前面几节合起来,完整的激励加载与比对流程是这样的:
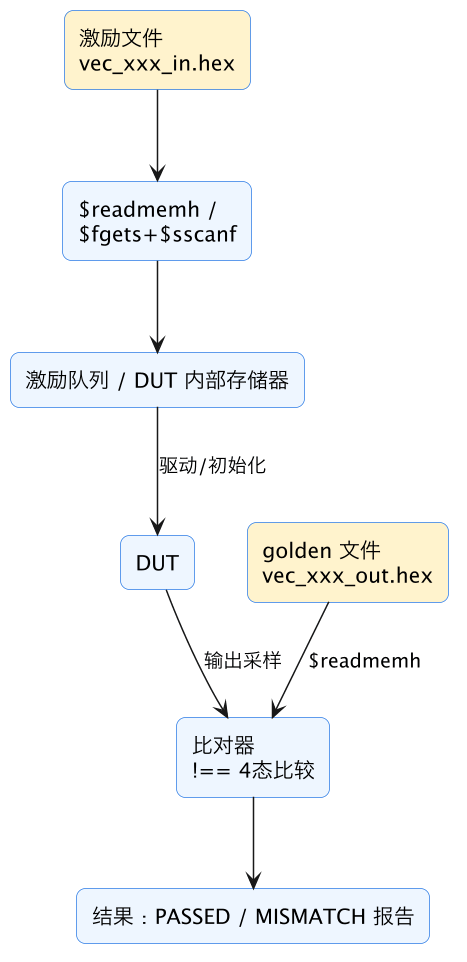
这张图的关键信息是两条文件通道在比对器汇合:激励文件走「加载 → 存储/队列 → DUT」的左链路,golden 文件走「readmemh → 比对器」的右链路,两者在仿真末尾或每个 beat 上对齐。左右不对称是刻意的——激励往往要带时序逐拍驱动,golden 多数情况下一次性灌满即可。理解了这个不对称,就能解释为什么工程里激励常用 $fgets+$sscanf(要按节拍发),而 golden 几乎总是 $readmemh(静态表)。
七、常见坑清单
- 相对路径找不到文件:
$readmemh相对的是仿真运行目录,不是源码目录。回归脚本和单跑目录不同步时最典型,统一用+define+DIR或 plusarg 传绝对路径前缀。 - 数组声明方向和文件不匹配:
mem[255:0]倒序声明时填充方向跟直觉相反,建议统一mem[0:255]升序。 - 文件尾部多一个换行:多数仿真器无所谓,但配合
$feof的 while 循环会多读一个空迭代,判断$sscanf返回值再入队。 - @addr 越界只 warning:前面说过,把 warning 纳入回归检查脚本。
- 2 态数组接 X 数据:往
bit [31:0] mem[]里 readmemh 一个含x的文件,X 被静默转 0,比对时查半天。激励/期望数据一律用 4 态logic数组。 - windows 行尾 CRLF:
$fgets拿到的行尾带\r,$sscanf("%h")通常无碍,但拿行内容做字符串比较时会被坑,必要时先过滤。 - 层次路径改了 DUT 结构没同步:后门
$readmemh("f", tb.dut.u_mem.mem)里u_mem改名后编译不报错(部分仿真器)或 elaboration 才报,做设计重构时记得全局搜 readmemh。
这一篇在知识体系里的位置
本篇是 SystemVerilog 验证语言地基中的一块「数据搬运」砖:向上承接 字符串处理与通用文件 IO($fopen/$fgets/plusarg 的完整语法在那篇),向具体应用延伸出 存储器后门 Scoreboard 和 事务抽象与 Driver(文件里读出来的数据最终要变成事务打进 DUT)。比对环节涉及 X 语义时,回头看 2 态/4 态与 X/Z 传播;批量跑向量时用 UVM 命令行 plusargs 切用例。
总结
SystemVerilog readmemh 是激励加载的「整块灌」捷径:纯数据镜像一行 $readmemh 直接初始化存储器(含 DUT 内部的后门加载),带控制字段的向量表用 $fopen + $fgets + $sscanf 逐行解析,golden 期望结果同样 $readmemh 进数组后用 !== 做 4 态比对——选对模式、盯死 warning、统一升序数组与绝对路径,文件激励这条链路就不会出幺蛾子。