UVM field automation 宏取舍:自动化收益、仿真代价与手写 do_* 的时机
更新时间:2026-09-29。UVM packer 与 field automation:打包位序与宏展开 讲了宏展开的 pack 位序怎么算,UVM compare 与 do_* 钩子:自定义比较逻辑 讲了
do_compare怎么写;这一篇把两件事拧到一起回答一个更工程的问题:宏自动化白给的五个方法,每个在仿真里花多少钱?热路径上什么时候必须放弃宏、手写do_*?
本文要回答的问题
- `uvm_field_int 宏到底自动生成了哪几个方法,各自在什么调用路径上被触发?
- 为什么说 pack/unpack 是宏开销的重灾区,而 copy/clone 几乎可以忽略?
- 一次
compare调用里宏展开实际跑了哪些隐藏步骤? - 什么信号(数据通路宽度、调用频率、scoreboard 模式)说明该手写
do_*了? - 手写之后丢掉自动化,怎么把 print/compare 的一致性风险管住?
一、宏自动化到底白送了什么
一个字段加一个 uvm_field_int 宏,UVM 在 uvm_object 基类的五个通用方法里为你自动接好了这个字段:
| 方法 | 触发场景 | 宏自动做的事 | 典型调用频率 |
|---|---|---|---|
copy / clone | sequence 复制 item、$cast 前备份 | 字段逐个赋值 | 中 |
compare | scoreboard 比对期望与实际 | 字段逐个比较,配合 UVM_NOCOMPARE 可关 | 高(每笔事务至少 2 次) |
pack / unpack | 事务过 uvm_packer 序列化成 bit 流 | 按声明顺序把字段压进位流 | 高(跨语言/参考模型对比必走) |
print / sprint | `uvm_info 打印、日志排错 | 按表格格式输出字段名/类型/值 | 低(调试时) |
record | 事务录波形供 GUI 回看 | 注册字段到 transaction recording | 中 |
白送的前提是「字段在宏里注册过」。一个 20 字段的事务类,手写这五个方法就是上百行样板代码,改字段名还要同步改五处——宏把这五处收敛成一行声明,这是它真正的价值:单点定义,多处生效。
代价藏在实现方式里。宏不是生成了五个针对你类定制的特化函数,而是往 m_uvm_automation 这张注册表里塞了一条条字段描述(名字、类型、位宽、radix、flag),运行期由基类的通用循环遍历注册表、按字段逐条解释执行。换句话说:你省了编译期的代码量,换成了仿真期的循环开销。
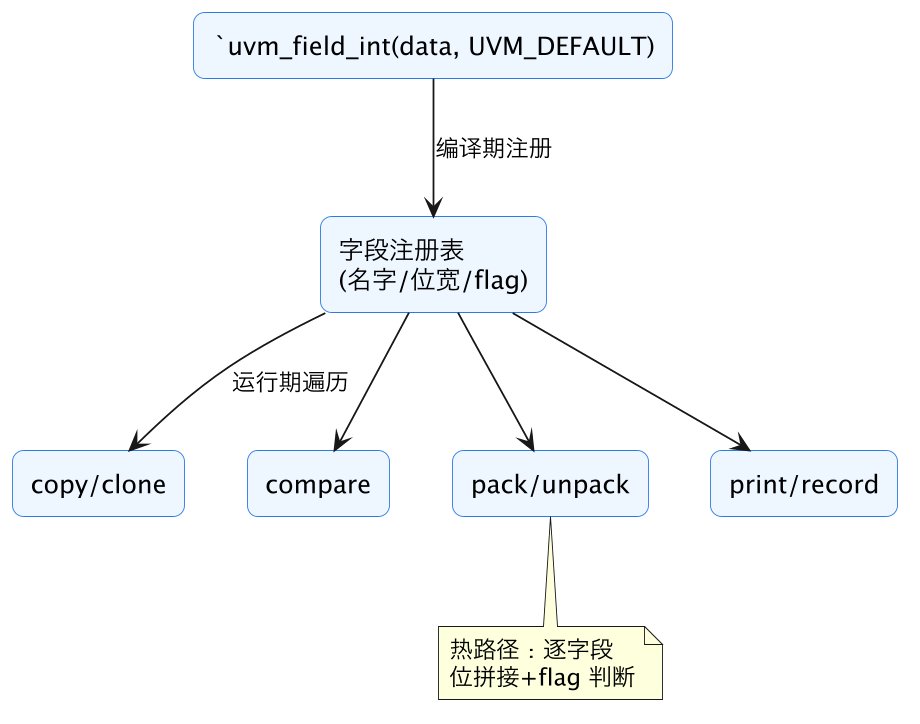
这张图的核心是中间那张注册表:宏只在编译期填表,五个方法全是运行期从表里查出来再执行。所以宏的开销不是「一次性的」,而是每次调用都按字段数线性增长——字段越多、调用越频繁,与手写特化代码的差距越大。
二、开销分布:为什么 pack 是重灾区
五个方法里开销并不均匀。copy 就是一次赋值,宏版本与手写差距通常在 2 倍以内,可以忽略;print 只在调试时跑,无所谓。真正的分水岭在 compare 和 pack/unpack。
compare 的宏版本每比较一个字段要做三件事:查注册表拿到字段描述、检查 flag 是不是 UVM_NOCOMPARE、再做值比较并累计 miscompare 字符串。20 个字段就是 20 轮「查表 + 分支 + 比较」。手写 do_compare 则是编译器优化过的连续比较指令,实测在 scoreboard 高频调用下差距常见 5-10 倍。
pack 更重。宏版本的 pack 走 uvm_packer::pack_field,每个字段要算位偏移、做位拼接、处理 packer 的物理/抽象策略,位宽不是字节整数倍时还要做部分字节合并。一个 256bit 数据段如果被声明成 8 个 32bit 字段,宏版本要循环 8 次位操作;手写 do_pack 一条 packer.pack_field_int(data, 256) 甚至直接写 m_data 的位拼接就完事。在把事务喂给 DPI-C 参考模型、或做 uvm_packer 字节级比对的场景,这是每笔事务两次(pack + unpack)的固定税,回归一跑就是百万级调用。
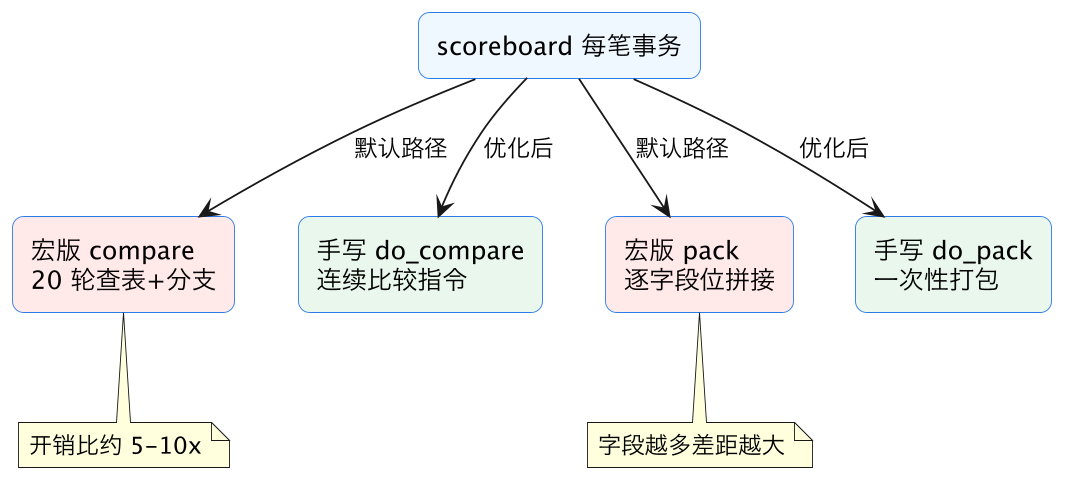
上图是同一个 scoreboard 的两种实现路径。红色是宏默认路径,绿色是手写 do_* 之后:调用次数没变,单次成本降一个量级。这也是为什么「宏取舍」的讨论永远从 scoreboard 和 packer 开始——它们是仿真时间里最密集的调用源。
三、什么时候该手写 do_*:三个判据
不是每个事务类都值得手写。判断看三个信号:
判据一:调用频率。 字段自动化开销 = 单次开销 × 调用次数。compare 在被动 scoreboard 里每笔事务至少调两次,pack 走参考模型比对时再乘二。回归一份百万事务的测试,宏版本光是 compare 就能吃掉几十分钟仿真时间。频率上了十万级,手写就回本。
判据二:字段结构。 宏按字段逐条处理,所以「字段少而宽」的类宏开销小,「字段多而碎」的类宏开销大。一个 AXI 数据 beat 类如果有 32 个 byte 字段,宏版本每次 pack 循环 32 次;合并成一个 bit [255:0]后手写do_pack` 一次搞定。字段数超过 8 个就该警惕。
判据三:是否需要定制语义。 有些字段宏天生处理不好:内容随机的 padding 字段不该参与比较、时间戳字段比较要用「容差」而非「相等」、unpacked 数组长度运行期才确定。这些场景宏只能靠 flag 关掉自动化(UVM_NOCOMPARE、UVM_NOPACK),关掉之后本来就该手写的逻辑还是要写——与其半宏半手写两头维护,不如整个 do_compare 收归手写,规则集中在一处可读。
三条占两条,手写;只占一条,宏继续用。比如配置寄存器类(字段少、事务少、语义简单),宏一辈子够用;数据通路 item(字段碎、流量大、有容差比较),第一天就该手写 do_compare 和 do_pack,宏只留 print 用。
四、手写之后的纪律:把一致性风险关回笼子里
手写 do_* 的代价是失去「单点定义」:新增一个字段,宏时代改一行,手写时代要记得改 do_compare、do_pack、do_unpack 三处,漏一处就是静默 bug——比较永远通过、或者 unpack 出来错位。两条纪律把风险压住:
第一,三件套成对提交。do_compare、do_pack、do_unpack 必须写在相邻代码块里,新增字段时一次改全。code review 的 checklist 里加一条「事务类新增字段,do_* 是否同步」,这个检查比任何宏都可靠。
第二,用宏做交叉验证(开发期)。手写 do_compare 后,可以保留一个宏注册的对照版本(flag 全开),在冒烟测试里同时跑两套比较,结果不一致就报错。回归稳定后再关掉对照路径。这相当于给手写代码配了一个自动生成的参考实现,把「手写写错」这一类 bug 在开发期清零。
print 和 record 可以一直留在宏里:它们不在热路径上,而且调试时字段表格的输出格式宏已经做得很好,手写纯属浪费时间。这正是「取舍」的落点——不是宏与手写二选一,而是按方法分别决策:热路径的 compare/pack 手写换速度,冷路径的 print/record 留宏换省心。
这一篇在知识体系里的位置
- 上游机制:UVM packer 与 field automation:打包位序与宏展开 讲宏展开的位序细节,本篇回答「这套机制花多少钱」。
- 手写侧:UVM compare 与 do_* 钩子:自定义比较逻辑 提供本篇判据三里「定制语义」的具体写法。
- 环境上下文:UVM 组件与 phases:环境骨架 里 scoreboard 的位置决定了 compare 的调用频率。
总结
UVM field automation 宏取舍的本质是「编译期省样板 vs 仿真期付遍历税」:宏白送 copy/compare/pack/print/record 五个方法,但运行期按字段查注册表逐条解释执行,字段多、调用频时 compare 和 pack 的开销是手写的 5-10 倍;判据是调用频率、字段碎度、定制语义三条占两条就手写 do_compare/do_pack,print/record 永远留宏,手写后靠「三件套成对提交 + 宏对照交叉验证」把单点定义丢失的一致性风险关回笼子——热路径手写换速度,冷路径留宏换省心,这才是宏取舍的正确姿势。