定时器级联验证:高低位拼接、进位边界与回读一致性怎么验
更新时间:2026-09-30。很多 MCU 和 SoC 的定时器 IP 只有 16 位计数单元,规格书却写着「支持 32 位计时」——实现方式就是把两个 16 位定时器级联(cascade):低位计数溢出时向高位进位,合起来当 32 位用。级联听着是「一根进位线的事」,但真实项目里这类模块的 bug 密度出奇地高:进位丢一拍、高低位回读撕裂、边界加载错位,全在级联缝里。本文是验证实操序列的长尾专题,承接 计数器边界验证 的单计数器套路,聚焦「两个拼一个」多出来的那部分问题,假定你已读过 SystemVerilog Testbench 实战。
本文要回答的问题
- 级联进位链上,低位 MAX 到高位 +1 的边界拍怎么才算验到位?
- CPU 分两次读高低位,中间恰好发生进位,回读值撕裂怎么防、怎么验?
- 定向、随机、SVA、覆盖率在级联场景下各自要多做什么,比单计数器多了哪些用例?
一、级联结构:先把进位语义钉死
典型的 16+16 级联定时器结构如下:低位定时器(TIM_LO)自由计数,它的溢出信号 ovf_lo 接到高位定时器(TIM_HI)的使能端;软件分别通过 LO_CNT 和 HI_CNT 两个寄存器读回。
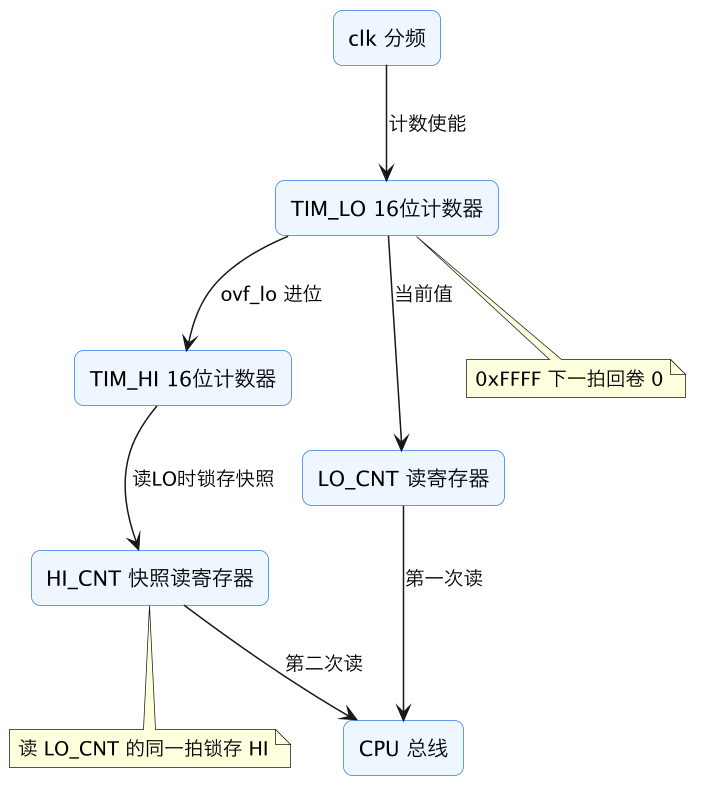
这张图里有三个验证必须盯死的语义点。第一,进位时序:低位到 0xFFFF 那一拍 ovf_lo 是否拉高?高位是同拍 +1 还是下一拍 +1?两种实现都合法,但断言写法完全相反,动工前必须和设计确认。第二,回读一致性机制:64/32 位计数靠两次 16 位读拼出来,如果两次读之间低位回卷进位,软件拼出的 32 位值可能差了 65536——所以规范实现会在「读 LO_CNT 那一拍」把 HI 值锁进快照寄存器,第二次读到的是快照而不是活值。第三,高位使能:TIM_HI 只由进位驱动,还是也能被软件单独启停?后者会多出一整块「级联断开」的测试面。
和单计数器一样,先把这些语义写成一张真相表(使能/加载/清零/进位组合的次态),它是定向用例和参考模型的共同依据。控制优先级、回卷拍行为的钉法与 计数器边界验证 第一节完全相同,不再重复。
二、进位边界:级联专属的「缝合拍」
级联验证的核心火力区是低位 0xFFFF 附近那几拍。下面把一次完整进位过程摊开:
| 拍 | LO 值 | ovf_lo | HI 值 | 说明 |
|---|---|---|---|---|
| n | 0xFFFD | 0 | 0x0005 | 正常计数 |
| n+1 | 0xFFFE | 0 | 0x0005 | 临近边界 |
| n+2 | 0xFFFF | 1 | 0x0005 | 低位满,进位拉高 |
| n+3 | 0x0000 | 0 | 0x0006 | 低位回卷,高位 +1 |
| n+4 | 0x0001 | 0 | 0x0006 | 继续计数 |
这张表看着平淡,但每一格都对应一类真实 bug:第 n+2 拍 ovf_lo 提前一拍拉高(比较值写成 0xFFFE)会导致高位多数一次;第 n+3 拍高位没 +1(使能沿对齐错)会丢 65536 个计数;低位回卷到 1 而不是 0,错因和单计数器一样是比较值写歪。还有一种更隐蔽的:ovf_lo 是组合逻辑输出,低位加载新值那一拍组合毛刺被高位采样到,高位凭空 +1——这类 bug 只在「加载恰好发生在 0xFFFF」时触发,定向用例必须专门构造。
定向集合在单计数器基础上要补的用例:低位从 0xFFFE 连拍走到回卷,逐拍比对 HI;低位 load 0xFFFF 后下一拍计数,确认进位只发生一次;进位拍同时给高位做 load,确认优先级(通常 load 赢过进位使能);进位拍同时拉清零;高位自己走到 0xFFFF 且低位再次进位,确认 32 位整体回卷到 0。最后这条最容易被遗忘——很多人只验低位回卷,没验「高位也满」的全 1 回卷。
三、回读一致性:两次读之间不能撕裂
回读一致性是级联定时器区别于单计数器的第二大战场。场景很具体:软件先读 LO_CNT 得到 0x0002,总线延迟几拍后再读 HI_CNT;如果这期间低位从 0xFFFF 回卷并进位,直接读活值会拼出 0x0001_0002 这种「来自未来」的组合,而真实序列里这个值从未存在过。
验证思路分两层。机制验证:确认读 LO_CNT 那一拍 HI 被锁进快照——定向用例让低位停在 0xFFF0,发起 LO 读,然后在 HI 读之前等足够多拍让低位回卷进位,最后比对 HI 读到的必须是锁存时刻的旧值,不是新值。抗扰验证:在 LO 读和 HI 读之间随机插入进位事件,统计拼出的 32 位值必须满足「单调且落在两次读夹住的真实区间内」。这条用 SVA 表达更干净:
// 读 LO 时锁存 HI 快照
a_snap: assert property (
  @(posedge clk) disable iff (!rst_n)
  (bus_rd && addr == LO_CNT) |-> ##1 (hi_snap == $past(hi_cnt, 1))
);

// 快照在读出前不被后续进位污染
a_snap_hold: assert property (
  @(posedge clk) disable iff (!rst_n)
  (snap_valid && !(bus_rd && addr == HI_CNT)) |=> $stable(hi_snap)
);
断言属性和 bind 写法见 SVA 断言实战。另外别忘了反方向场景:软件按「先 HI 后 LO」顺序读(有些驱动这么写),规格是否支持?多数快照机制只锚定「读 LO 锁 HI」,反序读需要软件自己重读比对——这类「机制不管、约定补齐」的点要在验证报告里显式记录,别当成覆盖完成。
四、随机、覆盖率与参考模型
随机激励在级联场景的「贴边」加权要加一档:低位 load 值让 0xFFFE/0xFFFF/0x0000 高频出现,高位 load 值同理,并且要让「低位在边界、高位恰好在被 load 或被读」的冲突窗口反复出现。约束写法沿用 受约束随机验证 CRV 的加权分布,只是权重表多一维「距离低位边界的拍数」。
功能覆盖率在单计数器模型上加两类 cross:低位值域(0/1/0xFFFE/0xFFFF)与高位动作(保持/进位/加载/清零)的 cross,这是进位边界的闭环证据;「总线读 LO」与「随后 N 拍内发生进位」的 cross,这是回读一致性的闭环证据。回卷事件本身用 cover property 单独收,模型细节见 代码功能覆盖率实战。
参考模型维护一对 exp_lo/exp_hi 软件变量逐拍推演:低位每拍 +1,低位回卷拍高位 +1,再叠加 load/clr 优先级,与 DUT 两个计数器逐拍比对。级联场景里参考模型格外值钱——进位丢一拍这种「积分性偏差」会带着错误一直走下去,单步断言可能恰好全过,逐拍比对一定抓到。模型里还要单独模拟快照寄存器:每次「读 LO」事件把当时的 exp_hi 拷进 exp_snap,之后总线读到 HI 时和 exp_snap 比对而不是和 exp_hi 比对,这样回读一致性的期望路径也被纳进自动比对,不用人肉盯波形。
最后提醒一个回归策略细节:级联定时器的用例跑起来很慢——16+16 位自然走到一次全 1 回卷要数亿拍。所以回归里要有「预加载逼近边界」的快速通道:先用 backdoor 或 load 把计数器摆到 0xFFFFFFFE 附近,再跑几十拍看回卷,把每次回归的进位边界覆盖时间从小时级压到分钟级;全量自由计数的长跑留给 nightly 即可。
这一篇在知识体系里的位置
单计数器的真相表、回卷断言与参考模型套路见 计数器边界验证;平台搭建见 SystemVerilog Testbench 实战;超时类定时器的另一验证视角见 看门狗定时器验证;寄存器读写属性与快照语义的验证方法见 寄存器读写属性验证。跨时钟域的级联计数(格雷码同步那套)则属于 异步 FIFO CDC 验证 的地盘,不要和本文的同钟级联混为一谈。
总结
定时器级联验证比单计数器多出来的全部工作量集中在两条缝上:一是进位缝——低位 0xFFFF 回卷到高位 +1 那几拍,用定向用例逐拍比对、用 SVA 锁死 ovf_lo 脉宽与高位次态、用低位值域与高位动作的 cross 证明边界真被命中,并且补上「高位也满」的 32 位全 1 回卷;二是回读缝——两次 16 位读之间发生进位会拼出从未存在过的撕裂值,必须验证「读 LO 锁 HI 快照」机制的锁存时刻与抗污染保持。配上一份逐拍推演 exp_lo/exp_hi 的独立参考模型兜底,级联定时器就能做到进位不错拍、回读不撕裂。