FPGA 原型验证专题 01:原型验证 Debug IP 寄存器是怎么被访问的
更新时间:2026-09-12。本文是
fpga/FPGA 领域第 09 篇,接 Zynq 与 SoC FPGA——AXI 总线、软硬件协同。片上信号抓取见 调试技巧——ILA、VIO、ChipScope,仿真波形数据库见 仿真波形数据库与格式横评。在 FPGA 原型验证(Prototyping)平台上,我们除了把 DUT(待测设计)综合到 FPGA,往往还会塞进一批 Debug IP:触发/断点逻辑、信号采集(trace)、性能计数器、内存/总线访问口、时钟复位控制等。这些 IP 都有一堆控制/状态寄存器。问题来了——主机上的调试软件,到底是怎么"够到"这些跑在 FPGA 内部的寄存器的? 本文就从这个问题出发,把整条访问链路拆开讲。
本文要回答的问题
- Debug IP 的寄存器在 FPGA 里"住"在哪?主机凭什么能读写它?
- 主机和 FPGA 之间有哪几条"路"(JTAG、PCIe、Ethernet、USB、UART)?各适合什么场景?
- 一条"写寄存器"的命令,从软件到 FPGA 内部触发器,中间经过了哪些环节?
- AXI/APB 总线、地址译码、AXI Debug Bridge 各自扮演什么角色?
- 自己写的 Debug IP,怎么挂到总线上、分配地址、写驱动?
- 多 FPGA 级联的大原型系统,怎么访问到另一颗 FPGA 上的寄存器?
- 常见访问不通(读回全 0 / 全 F / 挂死)怎么排查?
一、核心思想:寄存器本质是"有地址的片上存储单元"
先建立一个最关键的认知:
Debug IP 里的"寄存器",综合到 FPGA 后就是一组触发器(FF,或分布式/Block RAM)。
它和 DUT 里的状态寄存器在硬件上没有任何区别。

主机之所以能"专门"读写这组 FF,靠的是三样东西:
  1. 一条"路":主机 <-> FPGA 的物理传输通道(JTAG / PCIe / 以太网…)
  2. 一个"翻译官":把通道上的报文翻译成片上总线时序(如 JTAG->AXI 的 Debug Bridge)
  3. 一个"门牌号":寄存器挂在片上总线(AXI-Lite/APB)上,有唯一地址,
经地址译码(interconnect + decoder)选中目标 IP换句话说,访问 Debug IP 寄存器 = 一次片上总线的读/写事务,只是这次事务的发起者不是 FPGA 内部的 CPU,而是"主机经调试通道注入进来的"。这和 Zynq 里 ARM(PS)通过 AXI 访问 PL 外设寄存器是同一套机制,区别只在于"谁当总线主机"。
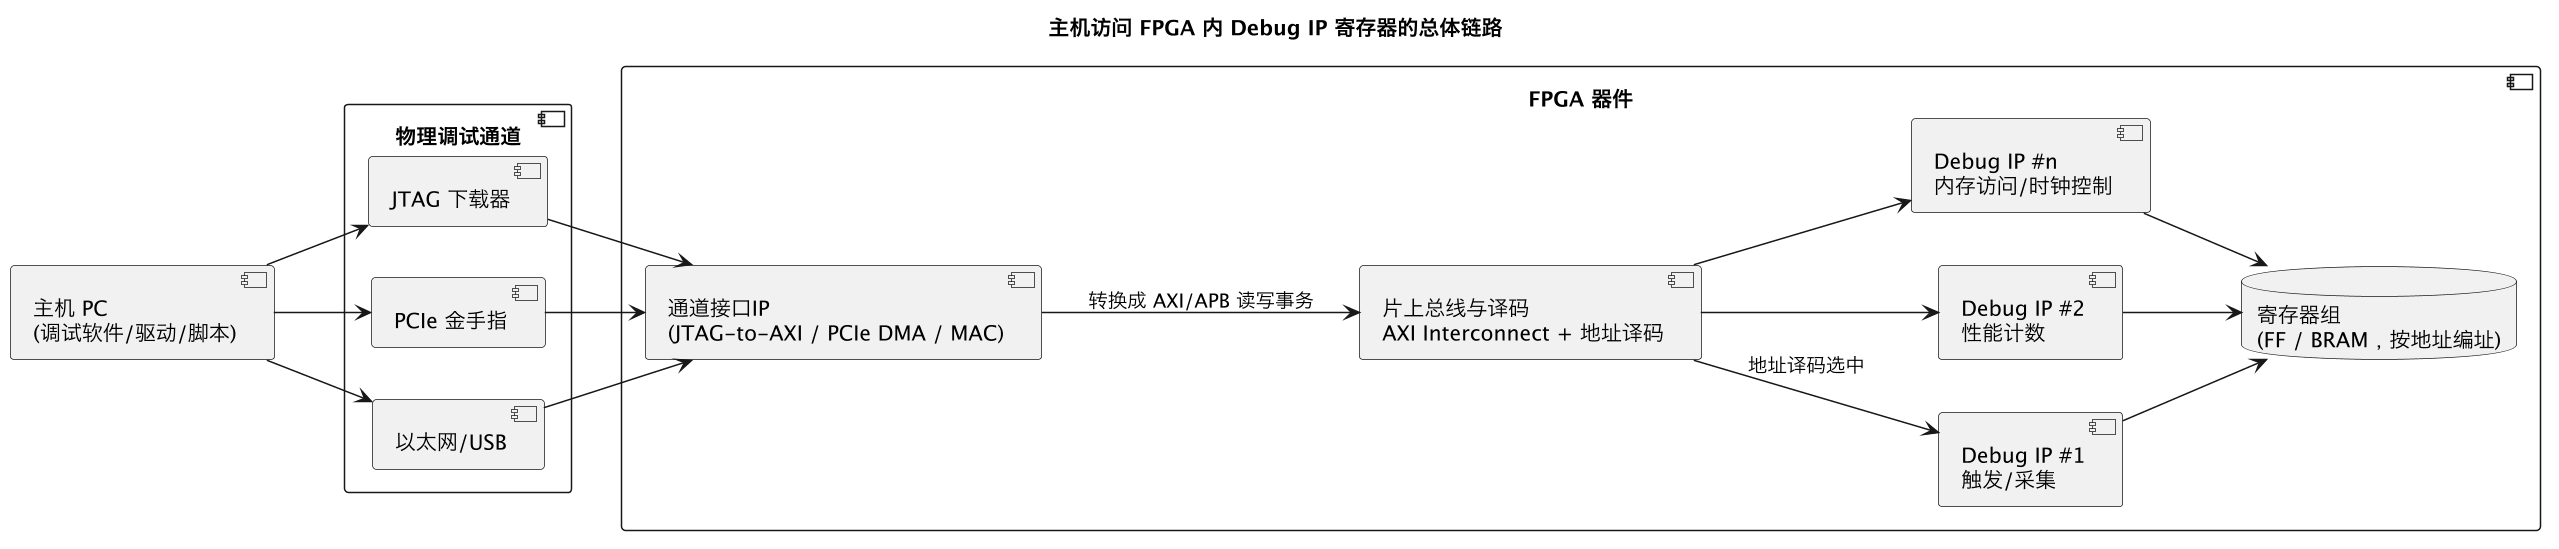
图里三段是固定套路:主机 →(物理通道)→ 接口/桥接 IP →(片上总线 + 地址译码)→ 目标 Debug IP 的寄存器。下面逐层拆开。
二、主机到 FPGA 的"路":四类物理通道对比
原型平台上,主机连到 FPGA 主要有四类通道。它们带宽、延迟、是否占用设计资源差别很大,决定了寄存器访问的"手感"。
| 通道 | 物理介质 | 典型带宽 | 是否占用设计资源 | 典型用途 | 代表场景 |
|---|---|---|---|---|---|
| JTAG | 下载器/USB-JTAG 电缆 | 低(Mbps 级,延迟高) | 否(用器件专用 JTAG 引脚与硬核) | 下载 bitstream、低速寄存器读写、ILA/VIO | Vivado Hardware Manager、VIO 控参、调试初期 |
| PCIe | 板卡金手指 / PCIe 硬核 | 高(GB/s 级,DMA) | 是(PCIe IP + DMA + AXI 桥占逻辑) | 高速数据搬运、大批量寄存器/内存访问 | 原型平台做 DUT 激励注入、trace 回传、驱动联调 |
| 以太网 | RJ45 / 光纤 + MAC | 中高(百~十 Gbps) | 是(MAC/PHY IP 或软核) | 远程调试、多板卡、长连接 | 机柜式多 FPGA 平台、远端实验室共享 |
| USB / UART | USB 串口 / FTDI | 低(Mbps 级) | 少量(软 UART/FIFO) | 简单命令行、控制面 | 轻量控制脚本、串口控制台 |
原型验证里最经典的组合是:JTAG 负责"控制面"(下载、起停、少量寄存器配置、挂 ILA/VIO),PCIe/以太网负责"数据面"(大块 trace 数据、内存镜像、高吞吐激励)。寄存器读写两条路都能做,JTAG 慢但"零侵入",PCIe 快但要在设计里放桥接 IP。
三、JTAG 通路:最常用也最"隐形"的一条
3.1 为什么 JTAG 能访问到内部寄存器
JTAG 本是 IEEE 1149.1 边界扫描标准,只用 4 根线(TCK/TMS/TDI/TDO),原本用来测引脚焊接。FPGA 厂商把它扩展成了片上调试骨干:
- FPGA 内部有一个硬的 JTAG TAP(Test Access Port),不受用户逻辑影响;
- 用户逻辑里可以放 JTAG 接入口——Xilinx 是
BSCANE2(原语)/ AXI Debug Bridge,Intel 是altera_jtag_avalon_master/ System Console; - 主机经下载器把命令按 JTAG 移位寄存器协议(IR/DR 扫描)送进 TAP,TAP 再把数据交给用户侧的 JTAG-to-AXI 桥;
- 桥把 JTAG 移位来的"地址 + 数据 + 读/写",在 FPGA 内部产生 AXI-Lite(或 APB/Avalon)总线时序,于是就变成了一次普通的片上总线读写。
关键点:JTAG 本身不产生总线时序,它只搬运比特;真正把比特翻译成 AXI 事务的是 FPGA 里例化的 Debug Bridge。
3.2 一次寄存器读写经过了什么(时序)
下面以"主机经 JTAG 写 Debug IP 的控制寄存器 0x10 = 0x1"为例:
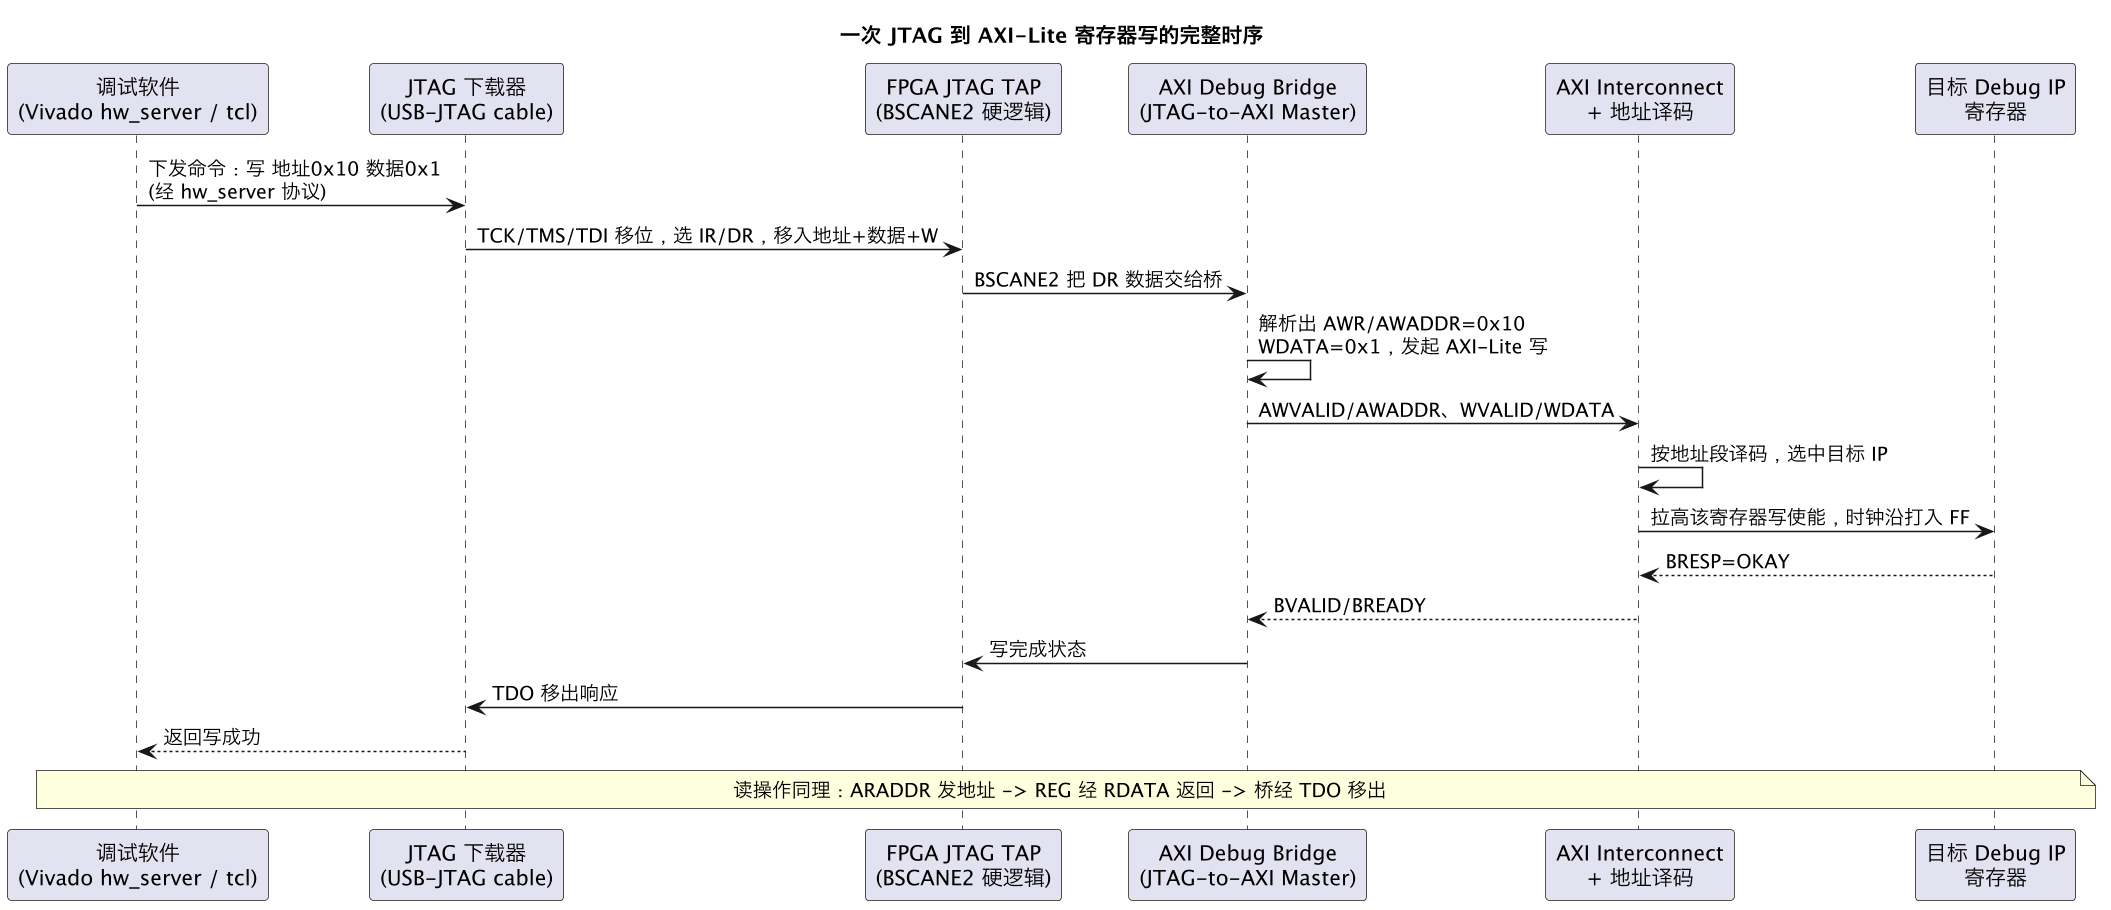
直观理解:软件写的每一个寄存器值,最终都是在 FPGA 内部某个时钟沿、靠"地址译码命中 + 写使能"打进一组触发器的。 JTAG 慢,是因为每一位都要 TCK 移位,且 USB 往返延迟高;但它不占用用户设计的总线资源,几乎"免费",所以是调试期首选。
3.3 两种 JTAG 使用方式
方式 A:厂商调试 Hub(最省事)
  - 例化 ILA/VIO/Debug Bridge,Vivado Hardware Manager 自动识别
  - VIO 的 probe_out 就是"可写寄存器",probe_in 是"可读寄存器"
  - 适合临时控参、观察,不用自己写译码

方式 B:自定义 AXI 寄存器 + JTAG-to-AXI Master(灵活、可成体系)
  - 例化 AXI Debug Bridge 配成 JTAG -> AXI Master
  - 自己的 Debug IP 做成 AXI-Lite 从机,分配地址段挂到 Interconnect
  - 主机用 tcl / xsdb / 驱动按地址读写
  - 适合量产级 Debug 子系统(大量寄存器、要脚本化)
四、FPGA 内部:总线、地址译码与寄存器本体
通道只是把请求"送进门",真正决定"访问到哪个寄存器"的是片上总线和地址译码。
4.1 片上总线:AXI-Lite / APB / Avalon
原型平台几乎都用 SoC 那套片上总线挂调试寄存器:
- AXI4-Lite(Xilinx/ARM 生态主流):轻量、单次读写、适合寄存器访问;Debug Bridge、PCIe 桥都吐出 AXI-Lite;
- APB(低带宽外设总线):更省资源、协议简单,常挂低速控制寄存器,AXI 经 AXI-to-APB bridge 转;
- Avalon-MM(Intel/Altera 生态):对应 JTAG-to-Avalon Master,概念等同。
Debug IP 通常实现成一个总线从机(slave):暴露地址、读数据、写数据、写使能、读使能等端口。复杂的多 IP 系统用 AXI Interconnect 把一个(或多个)master 路由到多个 slave。
4.2 地址映射:每个 IP 一段"门牌号"
互连内部靠地址译码器按高位地址选 slave,slave 内部再按低位地址选具体寄存器。典型地址映射如下(32 位 AXI,4KB 对齐一段):
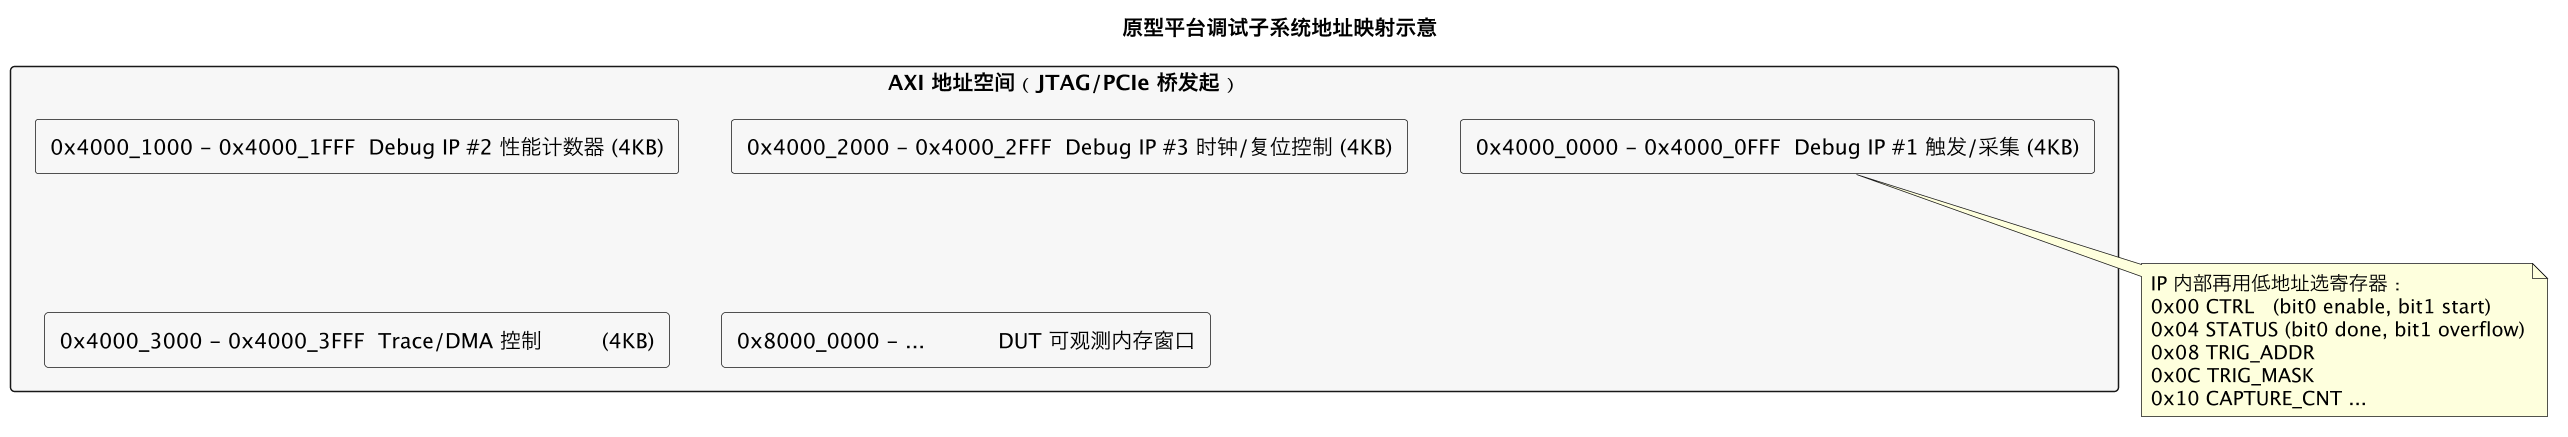
地址译码逻辑本质是一组比较器:sel_dbg1 = (base <= addr < base+4KB)。访问不存在的地址段时,互连通常返回 decode error(AXI DECERR)或默认从机返回 0。
4.3 一个寄存器本体长什么样
寄存器就是"写使能 + 地址匹配 + 时钟沿打入 FF"。极简 AXI-Lite 风格寄存器示意:
// 控制寄存器 CTRL,地址偏移 0x00;状态寄存器 STATUS,偏移 0x04
// wr_en / addr / wdata 来自 AXI-Lite 从机协议层(省略握手细节)
reg [31:0] ctrl;      // 可读写控制寄存器
reg [31:0] cap_cnt;   // 采集计数(只读状态)

wire wr_ctrl = wr_en && (addr[11:0] == 12'h000);
wire rd_stat = rd_en && (addr[11:0] == 12'h004);

always @(posedge aclk) begin
  if (!aresetn) begin
    ctrl <= 32'h0;
  end else if (wr_ctrl) begin
    ctrl <= wdata;            // 主机写 -> 时钟沿打入
  end
end

// 读:地址命中时把对应寄存器送上 rdata
assign rdata = rd_stat ? {28'h0, status_bits} :
               (rd_en && addr[11:0] == 12'h000) ? ctrl :
(rd_en && addr[11:0] == 12'h008) ? cap_cnt : 32'h0;这正是问题的答案落点:主机"访问寄存器"在硬件看来,就是桥接 IP 驱动总线地址/数据/写使能,在
aclk上升沿把值打进这组 FF,或把 FF 输出经rdata回传。 所谓"软件能读到硬件状态",是因为状态被持续连在某个可读寄存器的输入上。
实际工程里不会手写整套 AXI 握手,常用:
- Xilinx AXI External Master / AXI GPIO / AXI BRAM 控制器 等现成 IP;
- 或用脚本(如
raxidir/Vendor 的 register generator、IP-XACT)从寄存器描述表自动生成 AXI-Lite 从机 RTL、C 头文件(地址宏)与文档,保证软硬件地址一致。
五、高速通道:PCIe / 以太网下的寄存器访问
JTAG 胜在零侵入,但带宽低、延迟高,做几件事就吃力:读大块 trace 缓冲区、给 DUT 注入大批量激励、跑驱动/软件联调。这时走高速通道。
5.1 PCIe:把 FPGA 变成一张"设备卡"
FPGA 通过 PCIe 硬核/软核挂到主机总线,主机侧出现一个 PCIe 设备(可配成网卡/字符设备/自定义设备)。典型数据通路:
主机用户态/驱动
   │  BAR 空间映射(mmap)或 DMA 描述符
   ▼
PCIe Root Complex ── PCIe 链路 ──► FPGA 内 PCIe IP(Xilinx XDMA/QDMA,Intel PCIe SR-IOV)
   │  把 TLP 报文转换成
   ▼
AXI Bridge(XDMA 内置 AXI Master / AXI-Lite Master)
   │
   ▼
AXI Interconnect ── 地址译码 ──► Debug IP 寄存器 / AXI BRAM(trace 缓冲)
两种访问方式:
- 寄存器/小数据:BAR 映射 + AXI-Lite。驱动把 PCIe BAR mmap 到用户态,软件"写某个内存地址"即经 PCIe 产生一次 AXI-Lite 读写——延迟低(微秒级),适合配置寄存器;
- 大数据:DMA + AXI Memory Map。XDMA 提供 DMA 通道,主机和 FPGA 内 AXI BRAM/DDR 之间整块搬运,GB/s 级,适合回传 trace、下发激励。
对原型验证,PCIe 是"数据面"主力:Debug IP 用 JTAG/AXI-Lite 配置好触发条件,采集到的海量 trace 进 AXI BRAM/DDR,再由 PCIe DMA 流式回传主机,避免 JTAG 慢链路成为瓶颈。
5.2 以太网 / 其他
- 以太网:FPGA 内放 MAC(Tri-Mode Ethernet/10G MAC)+ 简单协议(UDP/TCP 或自定义),主机发包、FPGA 内协议解析 IP 把字段翻译成 AXI 事务;适合远程、多板卡、机柜式平台(S2C、HAPS 机柜常用专用高速 cable + 以太网交换做全局访问)。
- USB/UART:用软协议栈把命令帧解析成 APB/AXI 读写,轻量控制面用。
无论物理层是什么,进入 FPGA 后都收敛到同一件事:产生一次 AXI/APB 总线事务。
六、多 FPGA 级联:怎么访问"另一颗 FPGA"上的寄存器
大 SoC 原型常要切到多颗 FPGA(几十颗也常见)。主机一般只有一条物理链路接其中一颗/一个主控板,怎么访问到其他 FPGA 里的 Debug IP?
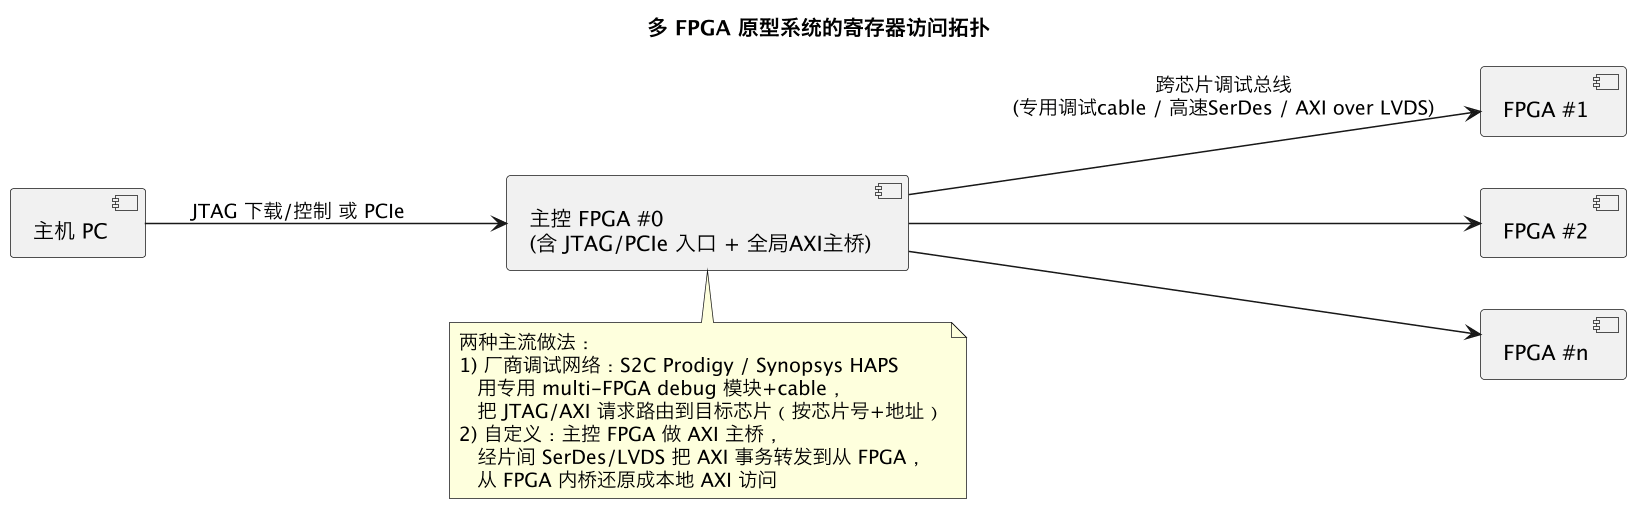
两种工程实现:
- 厂商调试网络(推荐、省事):S2C Prodigy PlayerPro、Synopsys HAPS 等原型平台提供多 FPGA 调试模块与专用高速 cable,软件侧统一地址空间,命令里带"芯片号 + 片内地址",平台硬件自动路由到目标 FPGA 的 JTAG/AXI;
- 自定义跨芯片 AXI:在主控 FPGA 放 AXI master 桥,把 AXI 事务打包经片间 SerDes 或 LVDS 发给目标 FPGA,目标 FPGA 内桥解包还原为本地 AXI 访问。本质是"把总线延长到板外",地址上为每颗 FPGA 预留高位段(如 0x0_0000_0000 给 FPGA#0,0x1_0000_0000 给 FPGA#1)。
设计期就要规划全局地址映射,给每颗 FPGA、每个 Debug IP 分配不冲突的地址段,否则多芯片联调时寄存器"撞地址"极难排查。
七、主机软件:从 GUI 到脚本到驱动
同一条链路,软件可以有多种"用法",从轻到重:
| 方式 | 工具 | 怎么做寄存器访问 | 适用 |
|---|---|---|---|
| 厂商 GUI | Vivado Hardware Manager / Quartus System Console | 图形化添加 AXI 寄存器访问器,填地址读写;VIO 直接拖按钮 | 临时调试、手动验证 |
| Tcl 脚本 | Vivado hw_server + create_hw_axi_txn | 脚本批量发 AXI 事务:create_hw_axi_txn wr … -address 0x40000000 -data 0x1 | 自动化、冒烟测试 |
| 调试命令行 | XSDB / xsct | mwr/mrd 写读内存映射地址 | Zynq/嵌入式联调 |
| 自研驱动+用户态 | C 驱动 mmap BAR、ioctl、XDMA API | 程序里像访问内存一样读写寄存器,跑寄存器级自检/驱动联调 | PCIe 平台、长稳测试 |
| 原型平台软件 | S2C PlayerPro / HAPS Concert | 统一多 FPGA 地址空间、GUI+脚本 | 大型商用原型机柜 |
典型 Tcl 片段(Vivado 经 JTAG-to-AXI 读写):
# 选中 JTAG-to-AXI Master,创建读写事务
set ctrl [create_hw_axi_txn wr_ctrl [get_hw_axis ...] \
            -address 0x40000000 -data 0x00000001 -type write]
run_hw_axi $ctrl
set st [create_hw_axi_txn rd_stat [get_hw_axis ...] \
            -address 0x40000004 -type read]
run_hw_axi $st
puts [get_property DATA $st]   ;# 读回 STATUS
八、常见问题排查
- 读回全 0:地址/基址不对(先核对地址映射与 Interconnect 段配置);该 IP 的 AXI 时钟/复位没起来;寄存器是"写触发"型(读无意义);信号被综合优化(加 keep/引出到寄存器)。
- 读回全 F(0xFFFF_FFFF):访问到了不存在的地址段(返回默认从机/DECERR 拉高),或该 IP 没接在总线上、总线悬空。
- 写入不生效:写使能逻辑没对齐时钟沿;该寄存器有写保护/需要先解锁(如先写 KEY 寄存器);AXI 握手没完成(WSTRB、AW/W/B 通道接错)。
- 访问挂死(软件超时):AXI 事务无人响应(slave 没返回 BVALID/RVALID,互连卡住);跨时钟域没接对;多 master 仲裁死锁。JTAG 访问挂死常因 Debug Bridge 时钟未就绪。
- JTAG 能连但 AXI 事务报错:Debug Bridge 配置的 master 模式/数据宽度与 Interconnect 不匹配;时钟频率不匹配。
- 多 FPGA 访问不到某芯片:芯片号/地址高位段错;片间调试 cable 未连接或路由未使能。
- PCIe 下 mmap 读写错位:BAR 偏移与 AXI 基址换算错;DMA 与 AXI-Lite 通道混用;字节序(大小端)问题。
排查顺序建议:先用 VIO/ILA 在 FPGA 内部确认寄存器逻辑本身对 → 再确认桥接 IP 输出了 AXI 事务(抓 AWVALID/AWADDR)→ 再确认地址译码 sel 命中 → 最后才怀疑通道/驱动。分层定位,别一上来就查软件。
九、设计清单:给自己的 Debug IP 加可访问寄存器
- 把 Debug IP 做成 AXI-Lite/APB 从机(用厂商模板或寄存器生成器,别手写整套握手);
- 规划寄存器偏移表(CTRL/STATUS/…),用 IP-XACT/脚本同时生成 RTL、C 头文件、文档,保证软硬件地址一致;
- 在 Block Design 里把它挂到 AXI Interconnect,分配唯一基地址段(4KB 对齐),多 FPGA 还要规划芯片号高位;
- 选一个 master 入口:调试期用 AXI Debug Bridge(JTAG-to-AXI),数据面加 PCIe XDMA;
- 接好时钟/复位:桥、Interconnect、Debug IP 的 AXI 时钟要一致或走正确 CDC;
- 关键状态位连到可读 STATUS 寄存器,控制位做成可写 CTRL,必要时加写保护/锁;
- 留好 ILA 观测点(桥的 AXI 口、译码 sel、写使能),方便分层排查;
- 软件侧准备 Tcl/驱动两套访问方式,先用脚本做寄存器级冒烟测试。
十、寄存器接口设计:把「可访问性」做成一门规范手艺
前面讲通了「主机请求如何到达寄存器」,这一节反过来讲怎么设计一批好访问、好调试、好维护的 Debug IP 寄存器——同一条 AXI 通路,接口设计得是否规整,直接决定后期 bring-up 的痛苦程度。
先确立统一的寄存器视图。给每个 Debug IP 划一段基地址,内部寄存器按 4 字节(32 位)对齐连续编号:控制寄存器(只写或读写,用来启动/停止/配置模式)、状态寄存器(只读,反映运行状态机、FIFO 水位、链路状态)、数据寄存器(读写,注入或读取数据)、时间戳/版本寄存器(只读,含 IP 版本和构建号)。强烈建议在固定偏移(如 0x00)放一个魔数/版本寄存器,值是该 IP 的固定标识,软件读它就能确认「这条路上挂的是不是我以为的那个 IP、版本对不对」——在多 FPGA、多版本比特流混跑的原型环境里,这个廉价的自检能省掉无数「为什么寄存器读写全对、行为却不对」的事故,因为那种事故的根因往往是比特流和软件驱动版本错配。
再定读写语义与位域纪律。每个寄存器的每一位都要有明确含义并形成一张寄存器表(地址、复位值、读写属性、位域、含义),软件头文件、文档、RTL 解码三者由同一张表生成或至少严格对应。常见的好习惯:状态寄存器用写 1 清零(W1C)的 sticky 位锁存错误事件(溢出、触发丢失、CRC 错),这样即便错误转瞬即逝,软件下次来读也看得到、写 1 清除;控制位里保留 enable 与 mode 的明确分离,复位后 IP 处于「不自动运行、等待配置完再 enable」的安全态;读写无效地址或保留位时返回总线错误(DECERR/SLVERR)或至少读到确定值,而不是挂死总线。寄存器表最好用 SystemRDL、IP-XACT 或表格模板这类单一来源生成 RTL 解码逻辑和 C 头文件,从根上消灭「软件按旧偏移访问、硬件已改版」的错位。
跨时钟域是寄存器接口里最容易被忽略的一环。 AXI 从机工作在总线时钟(如 100MHz),而 Debug IP 的采集逻辑常工作在另一个时钟域。控制信号从总线域到采集域、状态信号从采集域回总线域,都是 CDC,必须规范处理:单 bit 的启停/模式控制用握手或至少同步器,确保控制脉冲不丢不重;多位的配置(如采样深度、触发阈值)要么经异步 FIFO/保持寄存器加握手一次性装载,要么保证在 IP 停止时才允许写,避免配置跨域中途变化;回读状态用同步器并接受「读到的是稍早一两个周期的快照」。把总线从机和功能逻辑用一层「寄存器适配 + CDC」隔开,功能模块就完全不感知 AXI,既能被软件访问,又能在仿真里单独验证。
还要考虑访问安全与多主机。原型系统里可能有多个发起者(JTAG 调试桥、PCIe 主机、片上 CPU)同时访问同一批寄存器,需要明确仲裁与保护:关键控制寄存器加锁(先写解锁钥匙才允许改),防止某个主机误操作打断另一个主机正在进行的采集;调试构建和生产构建可通过编译开关关掉危险寄存器,避免现场软件误触发。对会影响 DUT 行为的「侵入式」控制(如强制停时钟、强制触发),单独划入需要显式使能的寄存器组。
最后是可观测性内建。一个好用的 Debug IP 寄存器组,除了完成功能,还应让软件能自助排查:可读的内部状态机编码、最近一次错误码、各 FIFO 的实时水位与溢出计数、自环测试控制位(让 IP 自己产生一段已知数据再读回,验证通路)、软复位位。bring-up 时软件的标准动作通常是「读版本→确认基地址译码→做自环→配参数→启动→轮询状态→读数据/计数」,整条链路每一步都有寄存器可验证,定位问题时就能迅速区分是总线没通、CDC 丢了配置、还是功能逻辑本身出错。把这套规范固化下来,你做的下一个 Debug IP 几乎只是在同一张寄存器骨架上换功能位。
十一、多片系统与大规模原型中的访问拓扑
当单颗 FPGA 放不下整个 ASIC 设计、原型平台由数颗甚至数十颗 FPGA 组成时,「访问某颗芯片上某个寄存器」从一次本地总线读写变成了一个跨芯片路由问题。这一节讲清多片原型系统里调试访问网络的典型拓扑和设计要点。
起点是一个全局地址空间。 无论底下挂了几颗 FPGA,主机侧都希望用一套统一的地址访问所有 Debug IP:高位地址用于「选片/选模块」,低位用于「片内寄存器偏移」。厂商原型平台(如 HAPS、S2C 及自研多板系统)通常提供一个调试网络(debug interconnect/fabric),主机经 JTAG/PCIe/以太网进入一个主节点,主节点根据地址把事务路由到对应 FPGA 上的从节点,再由该芯片本地的 AXI-Lite/APB 总线送达具体 IP。逻辑上它就是一个跨芯片的「地址译码 + 路由 + 本地解码」三级结构,和单芯片内部的译码思想一致,只是中间多了跨芯片物理链路。
跨芯片链路要回答三个问题:带宽、延迟、寻址。 带宽上,调试访问分两类流量——偶发的寄存器读写(窄、突发、对延迟敏感)和大批量 trace/活动数据上传(宽、持续、对吞吐敏感),成熟拓扑会把两者分到不同通道或不同优先级,避免一次大数据上传把整条 JTAG 链路占满、连「停一下采集」的紧急控制都发不进去。延迟上,跨芯片每经过一级桥和一段串行链路都要付出若干微秒,读操作尤其贵(请求下去、数据回来是往返),所以软件要避免「靠逐字轮询跨片寄存器等待状态」,而应改用块传输、邮箱中断或本地状态汇聚。寻址上,地址映射表必须随分区/比特流构建自动生成并带版本号——哪段 RTL 被编进哪颗芯片、基地址是多少,是由原型分区工具决定的,软件看到的地址表必须与实际 build 严格一致,否则会「合法地访问错对象」。
拓扑形态各有取舍。 菊花链把多颗 FPGA 串在一条 JTAG/调试链上,简单、省线,但远端芯片的每次访问都要穿过前面所有节点,延迟随位置线性增长且一处故障影响全链;星型/交换型拓扑通过一个中心交换节点为每颗芯片提供近似等距的访问,延迟均衡、可并行,但需要额外硬件和更复杂的路由;分层混合型在板内用本地总线、板间用高速串行链路汇聚,是大型系统的常见折中。自研原型时通常让「本地寄存器访问走低速可靠通道、海量 trace 走 SerDes/PCIe 高速通道」,两条网络在每个节点处汇合到同一片本地地址空间,兼顾可达性与带宽。
一致性与并发是多片访问的隐形陷阱。 对多个芯片分别写控制寄存器,物理上是多次非原子事务,如果没有「先配置、最后统一触发」的机制,各芯片可能在不同时刻启动,导致跨片数据不同步——因此多片系统普遍提供一个广播「屏障/触发」寄存器或硬件触发线:各芯片先各自配好并进入等待,主机一次广播让它们在同一个时钟/触发沿同时动作。读多片状态时也要么用本地锁存+广播快照(各芯片同一时刻记下状态,再逐个读回),要么接受读数在时间上有先后。前面采集篇强调的「同步周期计数器、跨片触发广播、时间戳归并」,在寄存器访问这一层就体现为「配置走单播、同步动作走广播、状态用快照」。
工程上务必让拓扑对软件透明且可自描述。 理想情况下,驱动只面对统一地址空间和一组标准服务(读、写、块传、广播、快照),底层路由由调试网络和构建时生成的地址/路由表处理;每个节点暴露拓扑信息(有几片、各自 build_id、链路是否 alive、各链路误码计数),软件启动时先枚举一遍网络、核对每颗芯片的版本与预期是否一致,任何一片比特流错版或链路掉线都在 bring-up 第一时间暴露,而不是等到读到莫名其妙的数据才追查。把「全局地址、控制/数据通道分离、广播同步、快照读取、自描述与版本门禁」这五件事做扎实,哪怕系统扩到几十颗 FPGA,调试寄存器访问仍然是可推理、可自检、可扩展的——这正是把单芯片那套「桥+总线+译码」手艺放大到系统级之后的必然形态。
十二、调试链路自身的可靠性:别让调试工具成为第一个故障源
访问 Debug IP 寄存器的整条链路——主机软件、桥接 IP、片上互连、地址译码、CDC 转换——本身也是一套数字系统,它同样会挂死、丢事务、版本错配。调试基础设施一旦不可靠,带来的不是「调不了」那么简单,而是更糟的情况:它返回错误的寄存器值,把你引向完全错误的根因。因此调试链路需要按一个正式产品来设计和自检。
最常见的故障是地址与版本错配。 软件按旧版寄存器映射访问新比特流(或反之),读写字段错位,现象千奇百怪:状态位对不上、写控制位没反应、读到的版本是陌生值。系统性的防御有三层:每个 IP 在固定偏移放魔数加版本寄存器,软件连接后第一步就核对;地址映射由构建流程自动生成并带构建标识,软件加载的映射表必须与比特流构建号一致;顶层还有一个全局构建信息寄存器,记录整个多片系统的构建哈希。bring-up 时先读全局构建信息、再逐个读各 IP 魔数,任何不匹配立即停止,不允许在「不知道对面是什么版本」的状态下继续调试。
第二类故障是总线挂死。 AXI 事务要求从机必须返回响应,若某从机地址译码落空、CDC 路径设计错误导致握手卡死,主机会永远停在等待事务完成的状态,表现为整个调试软件界面冻结。设计上的预防措施包括:地址译码对未映射区间返回 DECERR 而不是不应答、互连加可选的超时监视器把长时间无响应的事务错误返回、跨时钟域用经过验证的标准桥而不是自行拼接握手。出现挂死后的恢复手段也要预先准备:总线软复位、Debug IP 局部复位、必要时对单个从机发起安全重初始化,而不必重配整个 FPGA。
第三类是并发访问冲突。 多个主机(JTAG、PCIe、CPU)同时配置同一个采集 IP,可能出现一个主机刚启动采集、另一个主机改写了触发配置的竞态。寄存器层要定义清楚的拥有权模型:关键序列(配置→加锁→启动)用锁存和状态位保护,运行中只读状态不可写,停止后才允许改配置;或者提供一个全局的「调试会话所有者」寄存器,同一时刻只授权一个发起者写控制面。读路径则应尽量无副作用,允许多主机轮询状态而互不干扰。
第四类是让链路具备自检测试能力。 沿访问路径放若干测试点:桥接之后、互连上挂一个「 scratch 寄存器」(写什么读什么)验证读写通路完整;远端每片 FPGA 放数据回环寄存器验证跨片路由;用前面讲的多片拓扑枚举定期检查各节点是否在线、链路误码计数是否增长。标准上电自检序列(读构建号→枚举节点→scratch 读写→远端回环→各 IP 魔数)应做成脚本一键执行,几十秒内给出「调试链路是否健康」的明确结论。通过自检后再开始真正的业务调试,可以排除掉大量「问题其实出在观测工具上」的无效排查时间。
最后是一条纪律:调试链路的资源与时序不能豁免。 原型项目里常见的错误心态是「这些反正是调试用的,时序差点没关系」。但桥接和采集逻辑若不做 CDC、不约束时序、不验证,它在临界频率下产生的错误数据会被当成 DUT 的缺陷去追,浪费的时间远超当初省下的功夫。调试基础设施必须和功能设计使用同样的时钟约束、同样的复位规范、同样的跨时钟域纪律,并在独立的最小设计上先验证再集成。记住那句反直觉的话:观测系统的可信度,是所有观测结论可信度的前提。
相关与延伸
片上抓信号与 VIO 控参见 调试技巧——ILA、VIO、ChipScope;AXI 总线与软硬件协同见 Zynq SoC FPGA;高速物理层见 高速接口——LVDS、DDR、PCIe、Ethernet。仿真/Emulator 侧的波形与活动数据见 仿真波形数据库横评 与 DPA-DB 活动数据库。
总结
FPGA 能让主机访问 Debug IP 寄存器,靠的是"物理通道 + 桥接翻译 + 片上总线地址译码"三件套:JTAG/PCIe/以太网把请求送进 FPGA,AXI Debug Bridge 等接口 IP 把报文翻译成 AXI-Lite/APB 事务,Interconnect 按地址译码选中目标 Debug IP,最终在时钟沿把数据打进寄存器对应的触发器(写)或把触发器输出回传(读)。调试期用零侵入的 JTAG,大数据面用 PCIe DMA;多 FPGA 靠厂商调试网络或跨芯片 AXI 桥路由;自己做时把 IP 做成 AXI 从机、分配唯一地址、用寄存器生成器保证软硬件地址一致即可。