FPGA 原型验证专题 43:原型结果的可信度分级——哪些结论能拍板、哪些只能参考与测试报告规范
更新时间:2026-09-13。本文是模块 E 收尾篇。41 原型在 SoC 验证矩阵中的定位 用例分配/RACI/证据移交定原型在验证矩阵里的职责,42 降频原型架构性能评估 cycle 计数/A-B/伪延迟扣除讲性能数字怎么测和外推,25 真实激励驱动 ASIC 签核 SAIF 反标/边界讲功耗签核如何消费原型活动;本篇给一个跨指标的统一问题:**原型跑出来的每一个结论,可信度到底是多少,怎么在报告和评审里防止它被过度解读。**这是原型价值能否真正被采信的临门一脚。
一、原型结论失真的四个根源
要分级,先记住结论可能"骗你"的四个地方:
- **时序不真。**FPGA 的走线延迟、时钟树、时序收敛目标与 ASIC 完全不同;系统还整体降频(30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算)。任何依赖绝对时间、建立保持、亚稳态裕量的结论都不成立。
- **物理层被替换。**PHY、模拟、PLL、SerDes、部分存储控制器用功能模型替换(11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY、31 速率适配器 Speed Adapter 弹性FIFO/两种范式),模型只保功能行为,不保电气/延迟/抖动。
- **平台伪延迟。**跨片 TDM、速率适配器给事务加了芯片上不存在的周期(42 降频原型架构性能评估 cycle 计数/A-B/伪延迟扣除)。
- 覆盖未证明。"跑通了某场景"不等于"该功能所有情况都对"——原型不做随机约束和功能覆盖率证明(41 原型在 SoC 验证矩阵中的定位 用例分配/RACI/证据移交)。
这四点决定了可信度框架的基本盘:功能存在性与系统级健壮性证据很强;任何带物理时间量纲的绝对数字证据很弱。
二、三级可信度框架
| 级别 | 含义 | 可支撑的决策 | 原型结论举例 |
|---|---|---|---|
| L1 可签核/强证据 | 在真实规模、真实软件/真实流量下反复跑通,结论不依赖被替换部分和绝对时序 | 该功能/场景在系统级可用、未发现问题,可作为流片信心的重要组成 | OS 完整启动、真实 PCIe 枚举与传输、驱动用例通过、跨子系统无死锁、7×24 soak 无挂死 |
| L2 可决策/中等证据 | 受控条件下的相对结论,平台伪延迟同构可抵消,测量口径清晰 | 微架构 A/B 取舍、资源配置方向、活动剖面驱动的功耗优化 | 缓存加大后 MPKI/IPC 改善比例(83 篇)、仲裁策略对公平性的影响、真实场景活动热点(25 真实激励驱动 ASIC 签核 SAIF 反标/边界) |
| L3 仅参考/弱证据 | 依赖绝对时序、替换模型、平台伪延迟或覆盖不足 | 只能当早期预估/风险提示,不能作为签核或承诺依据 | 绝对 DMIPS/GB/s/ns 数字、真实 DRAM 精确延迟、SerDes 误码、中断最坏延迟、模拟性能、功耗瓦数绝对值 |
最关键的纪律:L1 证明的是"没在覆盖到的真实场景里出错",不是"数学上正确"——正确性仍由仿真/形式的覆盖率签核;L2 只对"差值/趋势"背书,不对绝对量背书;L3 必须显式降级标注,哪怕数字看起来很精确。
三、四类结论的置信边界(速查)
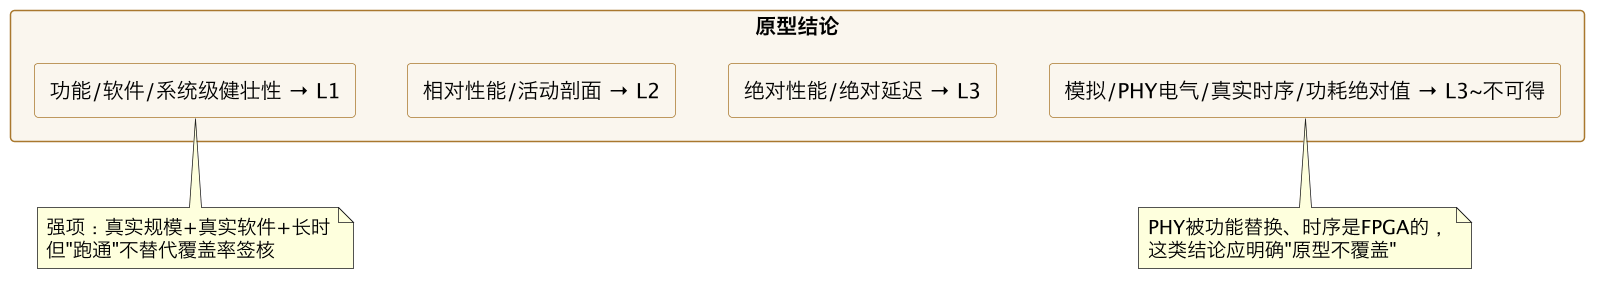
- 时序类:功能时序关系(A 一定先于 B、握手不死锁)可 L1;建立保持、最高频率、亚稳态、时钟域穿越的物理可靠性 → 原型不覆盖(靠 STA/CDC 审查)。
- 性能类:cycle 级相对趋势 L2(83 篇方法);主频、绝对带宽/延迟/ benchmark 分数 L3。
- 模拟与 IO 类:数字接口协议互通可 L1/L2;PHY 电气特性、信号完整性、SerDes 均衡、模拟精度、真实总线延迟 → 模型只保功能,标 L3 或"不覆盖"(33 PCIe/SerDes 上原型 硬核/降速子卡/LTSSM)。
- 功耗类:真实场景的活动率/翻转剖面可 L2(喂给功耗流很有价值,25 真实激励驱动 ASIC 签核 SAIF 反标/边界);绝对功耗瓦数是 L3——FPGA 工艺/电压/电容完全不同,不能从 FPGA 功耗推 ASIC 功耗。
四、一份"不被过度解读"的测试报告长什么样
建议固定如下结构,每条结论强制带级别和口径:
- 结论摘要表(最先放):结论 / 级别 L1~L3 / 通过标准 / 结果 / 残余风险。管理层只看这张表也不会误读。
- 平台与模型清单:用了哪些 FPGA、几片、DUT 频率与目标频率、分区数与关键割边、每个被替换 IP/PHY/存储模型的版本与保真度声明、速率适配器配置(72/73 篇)。读者必须能判断哪些结论受模型限制。
- 测量口径:性能数据写明是 cycle 计数还是墙钟、伪延迟如何扣除(83 篇)、计数器/采样方法、run 次数与方差;活动数据写明向量、工具、与签核流的对接方式(66 篇)。
- 版本指纹:RTL commit、网表/比特流 ID、软件镜像、时隙表版本(20 比特流烧录与四方版本一致 manifest/门禁、40 多板多 FPGA 全局触发与时间对齐 跨片 trace 同步),保证可复现。
- 覆盖与未覆盖:跑了哪些场景矩阵/软件用例/soak 时长(41 原型在 SoC 验证矩阵中的定位 用例分配/RACI/证据移交),明确列出原型不覆盖、需 STA/仿真/混合信号/硅后兜底的项——这一节往往最有价值。
- 发现的问题与关闭状态:原型暴露的系统级 bug、在仿真/形式的复现与修复闭环。
- 总体建议与残余风险:基于 L1/L2 证据给信心陈述,对 L3 项只给"早期指示,待 X 手段确认"。
措辞纪律:报告里禁止出现不带级别和口径的裸数字(如"启动时间 8 秒""带宽 40 GB/s");必须写成"原型墙钟 8 秒(L3,不可外推)/ 启动链 XXX 万 cycle,按目标 2 GHz 外推约 Y 秒(L2,未含真实 DRAM/PHY 延迟)"。
五、评审会上怎么回答"这颗芯片到底行不行"
原型团队常被要求给一个简单的 yes/no,正确的回答是分级的信心陈述:
- "在原型覆盖的这些真实场景里(列出矩阵),完整软件栈和真实接口反复跑通、长稳无挂死(L1)——系统级集成风险已显著降低;"
- "这些架构取舍有相对数据支持(L2,附加速比/活动剖面)——方向可定;"
- "但最高频率、真实接口裕量、模拟、绝对功耗原型不签(L3/不覆盖),它们的信心来自 STA/仿真/混合信号验证和硅后,当前状态是……"
这样既不谦虚掉原型的真实贡献(系统级、软件、长稳),也不越界给它给不了的承诺。流片决策是多源证据的综合:仿真/形式给功能正确性、原型给真实规模下的系统可信度、STA/物理验证给时序与制造、硅后给最终确认(呼应 05 原型到硅后衔接 pre/post-silicon 协同/errata)。原型是其中关键一环,不是单独的通关章。
六、报告措辞改写实例
同一个事实,错误写法会被拿去做超出证据的承诺,合规写法保留信息同时锁住边界:
| 场景 | 危险写法 | 合规写法 |
|---|---|---|
| 启动 | "Linux 8 秒启动,满足量产要求" | "原型墙钟 8 秒(5 MHz,L3);启动链 3.6 亿 cycle,按 2 GHz 外推 0.18 s(L2),未含真实 NAND/PHY 延迟" |
| 网络性能 | "吞吐达到 40 Gbps" | "DMA 引擎在该负载下周期数达成线速所需预算的 1.12 倍余量(L2);PHY/SerDes 由替换模型承载,真实线速不签(不覆盖)" |
| 稳定性 | "连续一周没挂,芯片没问题" | "场景矩阵 47/47、软件用例覆盖 92%、累计 210 板·小时 soak 零故障(L1,系统级);功能覆盖率仍以仿真 98.7% 签核为准" |
| 功耗 | "FPGA 实测 18 W,芯片就这个量级" | "典型场景活动率剖面已导出供功耗流(L2,25 真实激励驱动 ASIC 签核 SAIF 反标/边界);FPGA 与 ASIC 工艺电压不同,18 W 不外推为芯片瓦数(L3)" |
| 接口 | "PCIe Gen4 验证通过" | "真实主机 Gen4 x4 枚举/混合 DMA/24h soak 通过(L1);眼图与信号完整性属 PHY 电气范畴,原型不覆盖,由混合信号仿真与硅后签核" |
| 没复现 | "那个死锁已经修好了" | "修复在仿真断言可证;原型同用例 40/40 运行未复现(历史概率 1/30,40 次零复现≈95% 概率已消除),保留观察至流片前 soak" |
最后一行展示了一个常被忽略的统计纪律:偶现 bug 的"没复现"要带概率陈述(按历史复现率算连续无故障运行给出的置信度),否则"跑了几次没再出"在评审上等于没说。
七、评审问答的边界话术
被追问超出原型能力的问题时,三句模板:
- "这个问题原型给的是 X 级证据:……(说清测了什么);"
- "它不覆盖 Y,Y 的签核手段是……(仿真/STA/混合信号/硅后),当前状态是……;"
- "综合各引擎证据,当前风险等级是……,残余风险和兜底计划是……。"
八、流片评审:原型证据应该回答的七个问题
把可信度框架转成评审 checklist。流片评审会上,关于原型这一栏,评审者通常需要(也只需要)得到以下七个问题的明确回答:
- 覆盖了什么:场景矩阵、软件版本与用例覆盖、soak 累计板·小时数分别是多少(41 原型在 SoC 验证矩阵中的定位 用例分配/RACI/证据移交)?
- 没覆盖什么:模拟/PHY 电气、绝对时序、哪些替换模型承载的功能,分别由什么手段兜底?
- 发现并关掉了什么:原型暴露的系统级问题清单、各自在仿真/形式的关闭证据;还有多少 open、严重度和规避方案?
- 性能/活动结论是哪一级:相对趋势(L2)的实验方法是否受控(同分区/同模型/多 run);活动剖面是否已交功耗流(25 真实激励驱动 ASIC 签核 SAIF 反标/边界)?
- 数据可不可复现:抽 2~3 个结论,现场给出版本指纹和重跑路径(20 比特流烧录与四方版本一致 manifest/门禁);
- 偶现问题的统计状态:每个历史偶现 bug 给出"连续 N 次/多少板·小时未复现"对应的置信度,而不是"最近没见了";
- 残余风险与硅后计划:哪些已知风险要在回片后优先观测,原型用例如何转为硅后回归(05 原型到硅后衔接 pre/post-silicon 协同/errata)?
这七问有一个共同点:**它们要的都是带边界的事实,而不是信心表态。**准备评审时按七问组织材料,比写几十页流水账更能让原型的价值被正确采信,也最能防止"L3 数字被当承诺"这种最危险的误读。
九、可信度不是固定标签:随项目阶段演化
同一类结论在项目不同阶段的级别会变化,报告里应反映这种演化而不是一次定级永久引用:
- 早期(RTL 频繁变动、替换模型未校准):性能类结论普遍只能 L3——分区和模型都在变,cycle 数字的稳定性不足;此时原型的主要价值是"系统能跑起来"的 L1 早期信号。
- 中期(分区稳定、关键模型校准、软件栈就绪):受控 A/B 的相对趋势升级为可支撑决策的 L2;真实流量下的系统级健壮性开始形成 L1 证据。
- 冻结后(版本稳定、场景矩阵大量执行、soak 累积):功能/软件/长稳的 L1 证据最扎实;但绝对时序、模拟、PHY 电气永远不会因为跑得久而升级——它们不是靠重复运行能解决的,只能由对应签核手段背书。这是最常见的误判:"这块逻辑在原型上跑了半年"并不能给建立保持时间或 SerDes 眼图增加任何置信度。
- 硅后回灌:回片实测出来后,回头校准当初的 L2/L3 结论(外推误差多少、哪个模型保真度不足),这个校准记录是下一个项目最宝贵的建模输入(05 原型到硅后衔接 pre/post-silicon 协同/errata)。
因此每份报告除了给结论定级,还应注明定级的前提条件(分区版本、模型保真声明、软件版本),前提一变级别就要重评。把可信度当作"带有效期和适用条件的判断",而不是盖在数字上的永久图章,才能真正防止过度解读。
十、当结论看起来"太好"时
经验上需要主动提高警惕的几种报告信号:原型性能数字恰好满足甚至超过市场指标(十有八九把乐观功能模型或墙钟当结果);所有长稳测试"零异常"且没有任何错误注入(很可能错误路径从未被执行,而非设计无错,见 D4 主题);不同团队给出的同一指标数字不同却无人对账(测量口径不统一);结论引用的是几个月前的旧分区/旧模型(前提条件已失效,级别要重评)。可信度文化的一部分,是鼓励在报告里写"这个结论我们不确定"和"这里可能被过度解读了"——主动标注局限的报告,在成熟评审者眼里比全绿报告更可信。
十一、跨团队沟通:让非技术决策者也用对数字
报告除了给工程师看,还要过市场、项目管理和管理层,他们最容易把 L3 数字摘出去做对外承诺。两个实用做法:在摘要表用颜色/图标直观区分三级,且每个 L3 数字后面紧跟一句"不能用于……";对外材料(客户路线图、产品规格预沟通)只使用已由对应签核手段支撑的数字,原型 L2/L3 结果一律不进对外文档。需要表达进展时,用可验证的工程事实替代性能承诺——"完整软件栈在真实规模已连续运行 X 板·小时零系统级故障",这既是 L1 的强证据,也不会制造芯片无法兑现的预期。
十二、常见坑速查
- 报告给裸绝对数字 → 一律带 L 级别和口径;
- 把"跑通"当"正确" → 功能正确性靠覆盖率,原型只证覆盖场景无错;
- 从 FPGA 功耗推 ASIC 瓦数 → 只信活动率,不信绝对功耗;
- 不列被替换模型 → 读者无从判断置信边界;
- 用墙钟外推性能 → cycle 外推且标注未含 PHY/DRAM 延迟;
- 评审上给 yes/no → 给分级信心陈述 + 残余风险。
与系列及现有篇目的链接
- 职责与覆盖:41 原型在 SoC 验证矩阵中的定位 用例分配/RACI/证据移交
- 性能与功耗口径:42 降频原型架构性能评估 cycle 计数/A-B/伪延迟扣除、25 真实激励驱动 ASIC 签核 SAIF 反标/边界、24 活动覆盖率与性能调试闭环 热点/瓶颈/回放
- 失真根源:11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频、31 速率适配器 Speed Adapter 弹性FIFO/两种范式、33 PCIe/SerDes 上原型 硬核/降速子卡/LTSSM
- 版本与闭环:20 比特流烧录与四方版本一致 manifest/门禁、05 原型到硅后衔接 pre/post-silicon 协同/errata
总结
一句话总结:原型最大的风险不是测不出来而是测出的数字被过度解读,结论失真有四个根源——FPGA 走线/时钟树/降频导致时序不真、PHY/模拟/PLL/SerDes/部分存储被只保功能不保电气延迟抖动的模型替换、跨片 TDM 和速率适配器加入芯片上不存在的伪周期、原型不跑随机约束所以"跑通"不证明覆盖率;据此把所有原型结论分三级:L1 可签核(在真实规模、真实软件栈、真实接口流量下反复跑通且不依赖被替换部分和绝对时序,证明的是覆盖场景里系统级可用、无死锁、长稳不挂,如 OS 启动、真实 PCIe 枚举传输、驱动用例、7×24 soak,是流片信心的重要组成但不替代仿真/形式的正确性签核),L2 可决策(受控 A/B 且伪延迟同构抵消的相对量,如缓存加大的 MPKI/IPC 改善比例、仲裁公平性、真实场景活动剖面,只对差值趋势背书不对绝对量背书),L3 仅参考(绝对 DMIPS/GB/s/ns、真实 DRAM 精确延迟、SerDes 误码、中断最坏延迟、模拟性能、绝对功耗瓦数,只能做早期指示不能签核承诺);四类结论的边界是功能时序关系和协议互通可 L1、建立保持/最高频率/亚稳态归 STA、cycle 相对趋势 L2 而主频和绝对带宽延迟 L3、数字协议可验而 PHY 电气和信号完整性标不覆盖、真实场景活动率 L2 但绝不能从 FPGA 功耗推 ASIC 瓦数;报告要固定结构——最前面放"结论/级别/通过标准/结果/残余风险"摘要表,附平台与每个替换模型的版本和保真度声明、测量是 cycle 还是墙钟及伪延迟扣除口径和 run 方差、RTL 与比特流和镜像及时隙表版本指纹、场景矩阵与 soak 覆盖以及明确列出原型不覆盖需 STA/仿真/混合信号/硅后兜底的清单、系统级 bug 的仿真关闭状态,禁止出现不带级别口径的裸数字,"启动 8 秒"必须写成"墙钟 8 秒 L3 不可外推 / XXX 万 cycle 按目标频率外推约 Y 秒 L2 未含真实 DRAM/PHY 延迟";评审会上不答简单 yes/no,而给分级信心陈述:覆盖场景系统级风险已显著降低(L1)、架构方向有相对数据支持(L2)、最高频率/接口裕量/模拟/绝对功耗不签而由 STA、仿真、混合信号和硅后兜底(L3/不覆盖);因为流片从来是多源证据综合——仿真形式给功能正确、原型给真实规模下的系统可信、STA/物理验证给时序制造、硅后给最终确认——原型是关键一环但不是单独的通关章。