AXI ID QoS 仲裁:ID 线程、QoS 权重与 WRAP/RR 混合调度的饿死防护
更新时间:2026-09-28。本篇是「集成电路大类 · 芯片设计 · 片上总线」序列里讲互连调度的一篇。QoS 信号本身的语义先读 AXI4 QoS 信号与服务质量,仲裁器的公平性基础看 Round-Robin 仲裁器与公平性,乱序返回的 ID 规则看 AXI4 Outstanding 与 ID 排序,互连整体数据通路见 AXI Crossbar 互连结构。本篇把它们拧到一起:一笔传输从「进入端口」到「赢得仲裁被发出」之间,ID、QoS、调度器各自扮演什么角色。
本文要回答的问题
- AXI 的 ID 为什么等价于「线程」,它怎样把仲裁粒度从「主设备」细化到「流」?
- 互连里到底有几个仲裁点,地址仲裁和数据仲裁分别锁什么资源?
- QoS 四比特进入仲裁器后怎么变成调度决策,固定优先级、RR、WRR 怎么混用?
- WRAP/RR 混合调度(先按 QoS 分桶、桶内轮询)的 RTL 骨架长什么样?
- 高 QoS 流量持续涌入时,低优先级请求靠什么机制不被饿死?
一、ID 是「线程」:仲裁粒度的细化
AXI 每个通道都带一组 ID 信号:写地址 AWID、写数据 WID(AXI3,AXI4 已删)、写响应 BID、读地址 ARID、读数据 RID。工程上理解 ID 最准确的类比是操作系统的线程号:同一个 master 可以用不同 ID 发出多笔互不依赖的传输,互连和 slave 允许不同 ID 之间乱序完成,只要求同一 ID 内按序返回。一个四核 CPU 的每核取指是一个 ID、每核的 cache line 回填是另一个 ID;DMA 控制器的八个通道各占一个 ID——从互连视角看,挂在一个端口上的不是「一个主设备」,而是「若干条并发流」。
这对仲裁的含义是根本性的。如果互连只按物理端口仲裁,一个发出八条并发流的 DMA 与一个只发单笔配置访问的 GPIO 主机会拿到同样的份额,前者内部的流还要自己再排队。把 ID 纳入仲裁键后,调度器可以按「端口 + ID」做请求源登记,调度粒度细化到流,配合 QoS 才能做到「这条流是实时的、那条流是批处理的」这种区分。
图中三条「物理链路」在请求登记表里展开成八个候选流,仲裁器每拍从中挑一笔授权。读通道的返回路径靠 RID 解复用回正确的 master 与流,所以 AR 仲裁胜出时互连必须把(端口,ARID)压入一个未决队列,R 通道数据回来时按队头弹出校验——这也是 AXI4 删 WID 的原因之一:写数据改为「跟着写地址的授权顺序走」,省掉了 W 通道的一套 ID 匹配表,写返回的乱序自由度让位给面积。关于 ID 排序规则的完整约束可回读 AXI4 Outstanding 与 ID 排序,本篇只取它与仲裁器衔接的那一半。
二、互连里有几个仲裁点
很多人以为仲裁只发生一次,实际上一个典型 AXI crossbar 里至少有三类仲裁点,它们锁的资源完全不同:
| 仲裁点 | 候选者 | 锁住的资源 | 典型调度目标 |
|---|---|---|---|
| 地址通道仲裁(AR/AW) | 各入口端口的未决传输 | 目标 slave 端口的地址通道一拍 | 按 QoS 让紧急流先走 |
| 读数据复用(R) | 各 slave 端口返回的数据 | master 端口的 R 通道一拍 | 防单 slave 占满返回带宽 |
| 写数据路由(W) | master 端口内部的写缓冲 | slave 端口的 W 通道 | 跟随 AW 授权顺序 |
地址通道仲裁是 QoS 真正起作用的地方:AR/AW 握手成功的那一拍,地址、ID、QoS 被目标 slave 锁存,互连同时把这笔传输登记进「未决事务表」。数据通道的仲裁更像带宽分配,QoS 在这里通常退化为简单的轮询,因为数据阶段再分优先级意义有限——传输已经启动,卡它一拍只会堵 buffer。
注意 AR 与 AW 是两个独立仲裁器:读写互不阻塞,这就是为什么「读饿死」和「写饿死」要分别防护。未决事务表是全互连的稀缺资源——它的深度决定了 outstanding 上限,表满时仲裁器必须整体停授权,哪怕候选流的 QoS 再高。RTL 实现里这张表常按目标 slave 分组(每组一个 CAM),因为乱序返回只发生在同一 slave 的不同 ID 之间,跨 slave 的完成顺序本来就无约束。
三、QoS 怎么进入调度决策
AWQOS/ARQOS 各四比特,值越大越紧急,复位默认 0。规范(IHI 0022)只定义「大的优先」这一个语义,怎么用完全留给实现,这正是仲裁器设计的自由度所在。常见三种用法:
- 固定优先级(FP):直接拿 QoS 值当优先级,高者恒先。实现最简单——一个优先级编码器就够,但低 QoS 流可能被永久压制,只适合流量模型确定的封闭系统。
- 纯轮询(RR):无视 QoS,指针轮转。公平但浪费信号,显示屏这类实时流会和批处理流量平起平坐。
- 加权轮询(WRR):把 QoS 值换算成权重,每 N 个调度周期里给高 QoS 流更多授权名额。兼顾倾向性与公平,是商用互连(如 NIC-400 的可编程 QoS)的主流。
工程上最常见的其实是分桶混合:把 16 档 QoS 映射成 2~4 个优先级桶(比如 QoS≥12 进实时桶、8~11 进高优桶、其余进普通桶),桶间严格优先,桶内 RR。这样优先级编码的宽度从 16 缩到 3 左右,时序和面积都友好,而且桶内轮询天然提供基本公平。

这就是「WRAP/RR 混合调度」的实际形态:WRAP 在这里指「绕桶一圈回到桶首」的轮转语义,桶间不走轮转走严格优先。调度器每拍的决策延迟必须控制在一拍以内——它坐在地址通道的关键路径上,组合逻辑超过半拍就会限制整个互连的频率上限,所以商用设计普遍用「掩码 + 优先级编码器 + 循环掩码更新」的纯组合结构,而不是逐拍扫描。
四、WRR 的权重怎么落地
分桶方案里桶内是纯 RR,想再细一点就要在桶间引入权重。WRR 的经典实现是缺陷轮询(Deficit Round Robin, DRR):每个桶维护一个赤字计数器,每轮给计数器加上权重配额,桶内请求被授权一次就扣掉相应字节数(或拍数),计数器不足时本桶本轮让位。相比简单的「权重个名额轮流发」,DRR 按字节记账,长短突发混合时份额才准确——显示控制器一笔 64 拍的 INCR 和配置总线一笔 SINGLE 按「笔数」记账会严重偏袒后者。
| 调度策略 | 公平性 | 实时性 | 实现成本 | 适用场景 |
|---|---|---|---|---|
| 固定优先级 | 差,低优可饿死 | 最好 | 一个优先级编码器 | 封闭流量模型 |
| 纯 RR | 最好 | 无区分 | 掩码+编码器 | 同构多核 |
| QoS 分桶+桶内 RR | 好(靠老化兜底) | 好 | 两级编码器 | 通用 SoC 默认 |
| DRR 加权轮询 | 按权重精确 | 可调 | 计数器组+比较器 | 带宽需按比例分配的 NoC |
验证 WRR 要盯的不是「顺序」而是「份额」:仿真足够长的窗口(比如十万拍),统计各桶拿到的授权拍数占比,与权重的偏差应落在突发长度量化噪声以内。SVA 断言对份额无能为力,这类检查属于计分板/性能监视器的活,可在互连内挂一组 perf counter 授权时按桶累加。
五、饿死防护:老化提升与带宽预留
只要存在严格优先级,饿死就是理论必然:高优流量占满带宽时,LO 桶的授权率趋近于零。规范不管这件事,饿死防护纯粹是实现者的责任,主流有三种机制。
**老化提升(aging)**最常用:每个等待中的请求带一个年龄计数器,等待超过阈值就把它的有效优先级抬一档,最高抬到 RT 桶之下(或直接抬到桶首)。实现上是一个可饱和计数器加比较器,阈值做成寄存器可配,因为「可接受的等待」因产品而异——MCU 子系统 256 拍就够,大 SoC 里常设 1024 拍以上。
带宽预留/限速是第二道闸:给 RT 桶加 leaky bucket 限速器,承诺给它「至多 X%」而不是「想要多少给多少」,超出的部分降桶处理。这把实时流的带宽需求变成显式契约,系统级性能建模时能算清「RT 流全速跑时 LO 还剩多少」。信用机制则是更硬的版本:master 侧按信用发流,互连按信用发放节奏回填,端到端都有界,代价是握手复杂度上一个台阶。
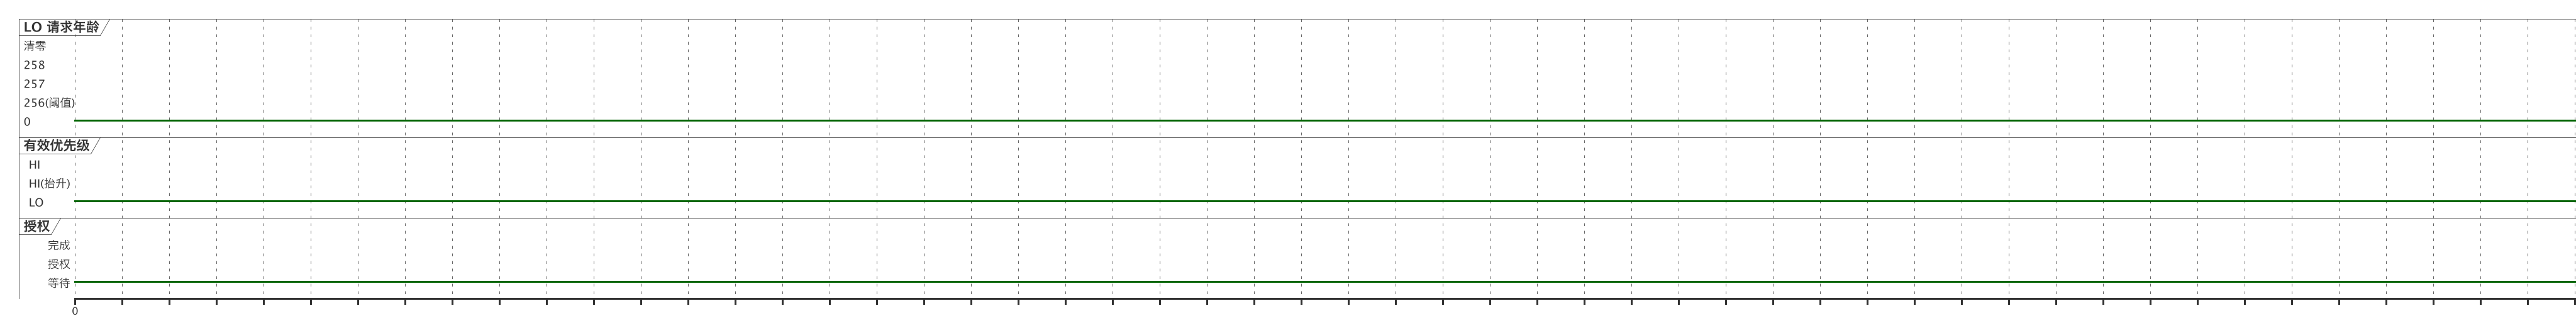
图中请求等了 257 拍才拿到总线:阈值 256 触发抬升,抬进 HI 桶后一拍内轮到它。注意授权后年龄必须清零、有效优先级回落,否则这笔请求残留的「高优先级身份」会污染下一次调度。验证上要把饿死防护当成功能点而非性能点写进计划:构造 RT 流 100% 占满的场景,断言「LO 请求从进入到授权不超过 阈值 + HI/LO 桶内最长轮转」这个有界等待性质;不造满占场景,老化逻辑在回归里永远不被触发,是最典型的覆盖率盲区。
六、落地清单:写一个可验证的仲裁器
把前五节收拢成设计动作,一个生产级 AXI 地址仲裁器的最小集合是:请求登记按(端口,ID,QoS)展开;QoS 经查找表映成 2~4 个桶;桶间严格优先、桶内掩码式 RR;每请求一个可饱和年龄计数器与阈值比较;授权的同时登记未决事务表并检查表满反压;所有阈值、桶边界、权重挂 APB 寄存器可配。验证侧对应四组场景:同桶并发查 RR 指针轮转正确性、跨桶抢占查严格优先、满占场景查老化有界等待、长突发混合查 WRR 份额偏差。调度器的时序收敛、掩码编码器的综合写法可对照 Round-Robin 仲裁器与公平性,互连端口级反压与 register slice 插法见 AXI Crossbar 互连结构 与 AXI Register Slice 时序。
这一篇在知识体系里的位置
上游概念是 QoS 信号语义 AXI4 QoS 信号与服务质量 与乱序规则 AXI4 Outstanding 与 ID 排序;同层对照有 NoC 里的路由级调度 NoC 片上网络路由器、总线选型视角的 AMBA 总线性能与面积基准;下游是把仲裁策略配进真实系统的 DMA 控制器微架构 与 显示控制器 Framebuffer DMA。
总结
AXI ID QoS 仲裁的本质是把互连的调度粒度从物理端口细化到「端口 + ID」的并发流,再用 AWQOS/ARQOS 四比特给流分档:地址通道是唯一真正执行 QoS 的仲裁点,主流实现用「QoS 分桶、桶间严格优先、桶内轮询」的 WRAP/RR 混合结构,需要精确带宽份额时上 DRR 加权轮询;严格优先必然带来饿死风险,工程上靠年龄计数器老化提升、RT 桶限速与信用机制兜底,并把「满占场景下的有界等待」当成功能断言写进验证计划——仲裁器每拍一拍出结果、授权即登记未决事务表,是它落 RTL 的两条硬约束。