FPGA 原型验证专题 06:原型验证系统全景与文档地图——仿真/原型/Emulation 的定位、三方分工与本系列导读
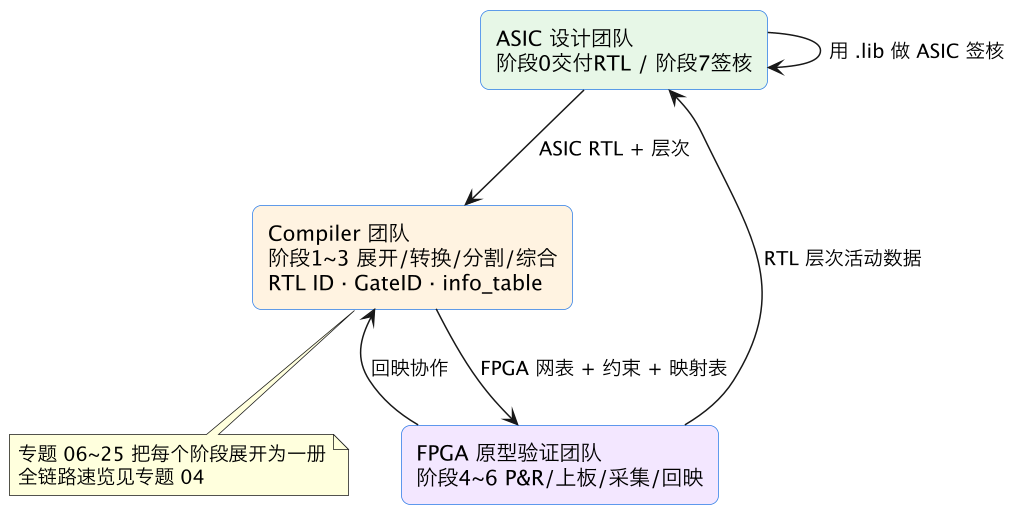
更新时间:2026-09-12。本文是「FPGA · 原型验证专题」系列 06~25「ASIC FPGA 原型验证系统」的总入口。单篇速览见 04 ASIC 原型验证全链路 RTL ID/GateID/层次映射,本系列把其中每个阶段纵向展开为独立一册:07/08 讲阶段 0 交付、09/10 讲前端展开与 RTL ID、11~14 讲适配/分割/互联/插桩、15~17 讲逻辑综合与 GateID/info_table、62~63 讲约束与时序、20~22 讲上板与采集、67~68 讲回映与活动分析、69 讲真实激励反哺 ASIC 签核。
这一篇在体系里的位置
04 ASIC 原型验证全链路 RTL ID/GateID/层次映射 用一篇讲完八阶段全链路;本专题 06~25 是它的"放大版":每一阶段一册,讲透输入/输出、工具内部原理、ID 与层次如何流转、三方如何交接。本篇(专题 06)负责回答"为什么需要这套系统、三方怎么分工、20 篇按什么顺序读"。
本文要回答的问题
- 软件仿真、FPGA 原型、硬件 Emulation(仿真加速器)三者在速度/成本/可见性/调试周转上怎么取舍?
- 什么样的设计规模/验证目标必须上 FPGA 原型?软件/固件验证、性能评估、功耗活动采集各依赖原型的什么特性?
- ASIC 设计团队、Compiler 团队、FPGA 原型验证团队各自对什么产物负责(RACI),交接物是什么?
- RTL Hierarchy、RTL ID、GateID 三个标识在八阶段里何时诞生、何时失效、靠什么串起来?
- 20 篇系列怎么分组、推荐阅读顺序是什么?
一、为什么非上原型不可:仿真速度的数量级墙
一颗现代 SoC 上电启动 Linux 需要执行几十亿条指令。事件驱动的逻辑仿真器(VCS/Xcelium)按网线事件逐条求值,典型速度只有 1 kHz~1 MHz 的等效时钟——按 100 kHz 算,启动 1 秒真实时间的系统行为要跑 1000 秒以上,启动一次系统要几周。流片前却必须回答四类问题:固件能不能跑、启动流程对不对、性能是否达标、真实流量下功耗活动长什么样。把设计映射到真正并行的硬件上执行是唯一可行的加速手段,这就是 FPGA 原型与 Emulation 存在的理由(速度对比的工程体感见 04 ASIC 原型验证全链路 RTL ID/GateID/层次映射)。
二、三种手段的光谱:仿真 / FPGA 原型 / Emulation
三者不是替代关系,而是速度、可见性、成本、周转的连续光谱,项目里同时使用:
| 维度 | 软件仿真 Simulation | FPGA 原型 Prototyping | 硬件仿真 Emulation |
|---|---|---|---|
| 等效速度 | 1 kHz~1 MHz | 1~30 MHz(受 TDM 拖累) | 0.5~5 MHz |
| 容量 | 几乎无限(服务器内存) | 受单/多片 FPGA 资源限制 | 极大(专用处理器阵列,数十亿门) |
| 单次周转 | 秒~分钟(改代码重跑) | 小时~天(综合+P&R) | 小时(编译),可多人分时 |
| 内部可见性 | 任意信号任意时刻 | 受限:须提前插桩、受 trace 存储预算约束 | 很好:硬件支持全信号动态探针 |
| 成本 | License 贵,硬件零成本 | 平台一次投入,后续便宜 | 极贵(机房级设备、按分钟租) |
| 典型用途 | 模块/子系统功能验证、定向回归 | 跑真实软件/固件、长时 soak、真实激励活动采集 | 全芯片级软硬件协同、早期 RTL 调试 |
记忆口诀:仿真最慢但全知全能,原型最快且便宜但"瞎",Emulator 居中但昂贵。FPGA 原型最适合「设计已相对稳定、要跑很久真实负载」的阶段。与仿真器协同的混合模式见 专家 37 FPGA 与仿真器互联。
三、原型验证的四类价值
- 软硬件协同验证(HW/SW co-verification):在真实并行硬件上跑驱动、RTOS、固件,暴露总线死锁、中断丢失、寄存器配置顺序等软件视角的 bug,仿真跑不出这种长交互;
- 固件/OS 提前开发(shift-left):RTL 冻结前几个月就给软件团队一块「足够像真芯片」的板子,流片回来时软件已就绪,典型能把项目关键路径缩短数月;
- 架构性能评估:真实激励下的吞吐、延迟、缓存命中率、总线利用率——但必须扣除原型的降频与跨片延迟(见 19 原型频率与时序收敛 TDM 降频/关键路径、23 Gate→RTL 数据回映 查表/聚合/SAIF);
- 真实激励活动数据反哺签核:上板采到的门级翻转活动回映到 RTL 层次后,可生成 SAIF 喂给 ASIC 功耗分析与功耗相关签核,比仿真向量真实得多——这是 25 真实激励驱动 ASIC 签核 SAIF 反标/边界的主题,也是整条链路为什么非要把 Gate 域数据查回 RTL 的根本动因。
四、三方分工与 RACI
原型不是一个团队能闭环的事,交接物必须机器可读、版本对齐:
| 阶段 | 主导方 | 交接产物 |
|---|---|---|
| 0 RTL 交付 | ASIC 设计团队 | 干净可展开的 RTL、时钟复位表、黑盒/存储清单(07 面向原型的 RTL 交付规范 层次/黑盒/电源域/08 不可综合构造识别与存根替换 模拟IP/时钟门控) |
| 1~3 展开/适配/分割/综合 | Compiler 团队 | FPGA 网表、RTL ID/GateID 体系、info_table、跨片逻辑、插桩(09 编译器前端展开 Elaboration AST/实例树~17 info_table 映射表 GateID↔RTLID/回溯/版本) |
| 4~6 P&R/上板/采集/回映 | FPGA 原型验证团队(Compiler 配合回映) | 比特流、运行结果、Gate 域采集数据、回映后的 RTL 域报告(18 原型约束体系 SDC/XDC/跨片时序/例外~24 活动覆盖率与性能调试闭环 热点/瓶颈/回放) |
| 7 ASIC 签核消费 | ASIC 设计团队 | 用真实活动数据做功耗/覆盖率等签核分析(25 真实激励驱动 ASIC 签核 SAIF 反标/边界) |
平台怎么搭、多片怎么点亮的实操见 02 多 FPGA 原型系统 ASIC 分区/TDM、03 原型平台 bring-up 多片点亮/trace。
五、三个标识的生命周期(全系列主线)
三方协作之所以能自动化,全靠三个不进比特流、只活在工程服务器上的标识:
- RTL Hierarchy:源码自带的模块实例树,阶段 0 就有,是一切回映的最终锚点;
- RTL ID:阶段 1 Elaboration 时给每个实例/端口/信号分配的全局唯一主键,RTL 不改则 ID 不变(10 RTL ID 体系 分配规则/层次绑定/稳定性);
- GateID:阶段 3 Compiler 逻辑综合时给每个 cell/net 分配,随网表产生(16 GateID 与逻辑网表模型 cell/net/ID 分配);
info_table(17 info_table 映射表 GateID↔RTLID/回溯/版本)维护 GateID ↔ RTL ID ↔ hierarchy 路径三方映射。上板采到的只是 Gate 域翻转,阶段 6 全靠这张表查回 RTL(23 Gate→RTL 数据回映 查表/聚合/SAIF)。RTL、网表、比特流、info_table 必须四位一体同一版本,错版采集等于垃圾数据(20 比特流烧录与四方版本一致 manifest/门禁)。
六、20 篇怎么读
- 先读 51~54:搞懂一份 ASIC RTL 怎样才算「原型可接收」,以及编译器前端如何把它变成带稳定 ID 的实例树;
- 再读 55~61:原型适配的核心工程——单元替换、多 FPGA 分区、跨片 TDM、观测插桩、两级综合与映射表;
- 最后读 62~69:落地与闭环——约束、降频、烧录版本纪律、软硬协同激励、Gate 域采集、回映、活动分析到 ASIC 签核。
- 横向参考:平台/容量看 02 多 FPGA 原型系统 ASIC 分区/TDM,bring-up 看 03 原型平台 bring-up 多片点亮/trace,trace 硬件看 45,硅后衔接看 05 原型到硅后衔接 pre/post-silicon 协同/errata。
- 续篇(原型外围系统工程,67~76):本系列讲的是"芯片逻辑怎样上原型、数据怎样回映";紧接着的姊妹系列 26 事务处理器 SCE-MI 三类通道/transactor 实现~35 多 FPGA IO 引出与引脚规划 连接器/电平/SI/取舍讲"原型跑起来之后的外围系统"——模块 B 软硬件协同(26 事务处理器 SCE-MI 三类通道/transactor 实现、27 在电路仿真 ICE 与协同加速模式 接线/时钟纪律、28 处理器 JTAG/调试口上原型 GDB/trace/失真、29 固件 shift-left RTL 冻结前 bring-up/驱动开发、30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算)与模块 C 真实接口(31 速率适配器 Speed Adapter 弹性FIFO/两种范式、32 DDR/存储接入原型 真实DRAM/降速模型/容量墙、33 PCIe/SerDes 上原型 硬核/降速子卡/LTSSM、34 以太网/USB/MIPI 外设接入 子卡生态/等时实时性、35 多 FPGA IO 引出与引脚规划 连接器/电平/SI/取舍)。读本系列理解"为什么",读续篇上手"怎么接、怎么 bring-up"。
- 续篇二(原型平台选型·调试 IP·验证方法学,77~86):外围系统讲完"怎么接",这一组讲"怎么选平台、怎么看得见、结论怎么采信、花多少钱"——平台选型与成本(36 商用原型平台版图 HAPS/Protium/第三方能力边界、37 原型/Emulation/仿真选引擎 决策树/多引擎排班、38 国产与第三方原型平台生态 可用性/工具链/迁移成本、44 自建/购买/租云原型 TCO 模型 盈亏平衡/机会成本)、商用调试 IP 与 trace 系统(39 商用原型调试 IP 深跟踪/动态探针/可见性预算、40 多板多 FPGA 全局触发与时间对齐 跨片 trace 同步、45 Trace 带宽与深度工程 采样/缓冲/压缩/回传管线)、验证方法学与结果可信度(41 原型在 SoC 验证矩阵中的定位 用例分配/RACI/证据移交、42 降频原型架构性能评估 cycle 计数/A-B/伪延迟扣除、43 原型结果可信度分级 可签核/可决策/仅参考与报告规范)。
七、组织模式:自研 Compiler vs 商用方案
商用原型编译器(如 S2C/Cadence/ Synopsys 系方案)提供现成的展开、替换库、分区、TDM 互联与调试套件,中小团队直接采用;超大规模厂常自研或深度定制 Compiler,因为替换库、ID 体系、回映格式要与内部 ASIC 流程(功耗签核、覆盖率平台、回归系统)打通。无论哪种模式,三条纪律相同:ID 稳定可追溯、替换关系显式留档、全链版本对齐。这三条正是后面 19 册反复出现的主旋律。
八、从项目时间线看三种手段如何接力
把仿真、Emulation、FPGA 原型放到一条项目时间线上,更容易理解它们不是互相抢预算的竞品,而是在不同成熟度阶段接力的三棒。需求冻结前后、RTL 尚在大改时,仿真器是唯一现实的选择:编译一次几分钟到几十分钟,波形全可见,断言能精确定位到信号和周期,这一阶段追求的是「证伪越快越好」,速度慢不是主要矛盾,因为测试场景集中在模块和子系统,不需要几十亿周期。等到子系统逐渐稳定、模块间交互成为主要风险源时,Emulation 接第二棒:它能以 0.5~5 MHz 跑全芯片、保留很好的可见性、支持多人分时使用,适合软硬件团队第一次在「完整芯片」上联调中断、缓存一致性、启动序列这类跨子系统行为;它按分钟计费极贵,所以用例要精选——在 Emulator 上跑过的长软件场景通常会沉淀为回归资产,反复利用而非随手重跑。当 RTL 接近冻结、需要连续几天几夜跑真实操作系统、真实流量、真实外设连接时,FPGA 原型接第三棒:一次性平台投入之后单位机时极便宜,可以开多板并行跑 soak、性能基准和活动采集。这条接力线解释了一个常见的排期错误:在 RTL 还每周大改时就急着上多板原型,结果一次综合实现要过夜,改一轮等一周,原型团队沦为给不稳定 RTL 做慢速编译器的角色;反过来,RTL 已冻结却还只在仿真器里跑驱动,软件团队会被迫在流片后才第一次面对真实时序,bug 在硅片上暴露的代价高几个数量级。成熟团队用「RTL 变更率」作为切换信号:模块级变更频繁时留在仿真,跨子系统接口变更收敛后上 Emulator,接口冻结、版本节奏变为周级再大规模铺原型板。
九、能力边界的显式声明:原型「不能回答什么」
一套可信的原型体系,价值不只在于它能给出什么数据,还在于它明确拒绝回答什么问题;把超出能力边界的结论写进报告,比没有报告更危险。第一类不能回答的是绝对时序与工艺相关行为:FPGA 上跑的时序是 LUT、布线、MMCM 的时序,跟 ASIC 标准单元的建立保持时间、工艺角、OCV 完全无关,原型上「时序通过」对 ASIC 签核没有任何证明力,连降频后的相对比较都要扣除跨片延迟才成立。第二类是模拟、混合信号与 PHY 物理层行为:FPGA 原型里的 SerDes、DDR PHY 通常是商用替换 IP 或真实外部芯片,其均衡、校准、抖动表现不代表目标工艺的 PHY,误码率测试只能证明原型链路本身通,不能给 ASIC PHY 签字。第三类是功耗的绝对值:FPGA 与 ASIC 是完全不同的工艺和结构,原型板上测电流推不出 ASIC 功耗;原型在功耗签核链路上的真正产物是活动数据(翻转率、各层次活动率),再用 ASIC 自己的工艺库计算功耗,这正是 69 篇存在的理由。第四类是依赖电源域、关断、隔离、保持的行为:FPGA 没有电源域概念,UPV/UPF 设计在原型里被折叠为常上电世界(见 52 篇),电源开关、状态保持、隔离钳位这些行为必须靠仿真和形式验证回答。第五类是容量被 TDM 稀释后的微架构细节:跨片信号被时分复用时,原始仲裁延迟、总线公平性的观察必须配合校正模型,否则会把「时间被拉长了」误判成设计本身的性能缺陷。每一份原型报告都应在显著位置列出这些边界,结论使用方(架构、物理、功耗、软件团队)才知道哪些数字可以直接用、哪些只能作定性参考、哪些根本不该在原型上找答案。
十、一次典型的原型项目排期:人、板与里程碑
理解这套系统的最好方式之一,是看它在一个真实项目日历上如何展开。以下给出一个中型芯片(约几亿门级、需四到八片高端 FPGA)的典型排期骨架,帮助新人把各篇文档对应到项目阶段。
阶段一:平台与接收准备(RTL 冻结前三到四个月)。 原型团队并非等 RTL 就绪才进场,而是提前做三件事:按预估规模选定板型和片数、准备平台基础设施(时钟复位编排、调试总线、采集网络、远程电源与烧录链路)、与设计团队共同制定交付规范(51 篇)。这一阶段最容易被压缩,而它恰恰决定后期迭代速度——基础设施晚一个月,后面每个版本都多等一周。
阶段二:首次展开与点亮(冻结后两到三周)。 第一次完整跑通展开、替换、分区、综合、实现、烧录,目标不是性能而是「能下载、能释放复位、版本号读得对、跨片链路全部训练成功」。第一次构建几乎必然失败多次,失败点集中在黑盒端口不符、时钟结构未识别、存储推断异常;这正是门禁自动化(51 篇)和综合分诊报告(59 篇)要提前就绪的原因。点亮里程碑通常以板级自检全部通过、最小测试向量跑通为标志。
阶段三:频率爬坡与软件接入(第四到第八周)。 分区和时序迭代,把等效系统频率从勉强跑通提升到软件团队可用的水平;同时发布第一块可共享的板子给软件团队,让驱动和启动序列在真实硬件上跑起来。此阶段硬件团队与软件团队的协作接口是「版本节奏」:每周固定日期出一版比特流并附变更说明,软件不必追每天的构建。
阶段四:回归化与活动采集(第八周以后)。 系统进入农场化运行,自动化回归常驻,性能基准卡按版本跟踪,活动数据按签核需求批量采集、回映、交付功耗团队(68、69 篇)。此阶段人力投入从「救火」转为「运营」,团队规模可以下降,平台利用率成为主要指标。
排期上有两个反复出现的教训:一是软件接入时间应尽量早,哪怕第一版只跑很小一部分设计——软件团队发现的接口类问题往往需要 RTL 改动,越早发现越便宜;二是不要承诺「冻结当天就能上板」,从冻结到点亮的两三周是客观的工程时间,压缩它的唯一正道是把能提前做的基础设施全部前置。
十一、给不同角色的阅读路径与常见误解
最后给出按角色裁剪的阅读建议,并澄清几个跨团队最常见的误解,作为全系列导读的收尾。
给 ASIC RTL 设计师:重点读 51、52 篇即可掌握「我该交什么、为什么我的某些写法会被退回」;54 篇帮助理解为什么不要随意改例化名;69 篇说明你将来要消费的活动数据长什么样。常见误解是「原型是验证团队的事,与我无关」——事实上交付质量直接决定你的设计能以多快速度接受真实负载检验,原型发现的长场景 bug 最终还是你来修。
给 Compiler/EDA 工程师:53 到 61 篇是主干,外加 56、57 篇理解分区与互联的物理约束。常见误解是把原型综合当普通综合器加个后端,忽略可追溯性这个第一目标函数——在普通综合里「优化掉」是褒义词,在这里「优化丢了且来源说不清」是事故。
给 FPGA 板级/平台工程师:55、57、62、63、64、66 篇与日常最近。常见误解是把多片系统当多块独立单板分别对待——它在时序、复位、版本上是一个整体,任何一片错配都让全组数据失效。
给软件/固件工程师:读 50、64、65、69 篇。要建立的核心认知是:你跑的不是真芯片,它更慢(且慢得不均匀)、某些 IP 是替身、但接口和软件可见行为应被设计成与真芯片一致;遇到异常先查版本自证寄存器,能排除掉一半的「灵异问题」。
给项目经理:50 篇的分工模型、本篇第九节的排期、64 篇的版本纪律最相关。原型平台最大的管理风险不是技术而是同步——三方对「这个版本验证了什么、没验证什么」的认知必须一致,能力边界声明(第九节)和 manifest 就是用来消除这种认知差的。
全系列的最终图景只有一句话:用一套严格的标识、版本和映射体系,把「在替代硬件上跑出来的现象」可靠地翻译回「对真实芯片的判断」。后续每一篇都是这句话在某个环节的展开。
十二、经济账:自建、租用与商用平台的决策
最后补上一个所有技术讨论都绕不开、却很少被写进文档的问题:原型平台到底该花多少钱、自建还是租用。把账算清楚,技术方案才能落地。成本构成有四块:硬件(FPGA 板卡、互联子卡、主机服务器、供电制冷,一次性投入且随 FPGA 换代而折旧)、软件(商用编译器、调试套件、部分 IP 的年订阅授权,往往比硬件还贵且持续发生)、人力(平台开发和维护团队,是长期最大头)、机时机会成本(板子被一个项目占着,另一个项目就只能等)。三种获取模式各有适用区间:小团队、单项目、工期短——租用商用云原型或整机托管最划算,把资本开支变成运营开支,缺点是单位机时贵、数据出境和保密要评估;有持续多项目、长期路线——自建平台加自建或深度定制 Compiler,摊到三五年通常更便宜,且知识和数据留在内部;中间路线——购买商用平台但自建运营层(调度、CI、采集脚本),硬件软件买成熟的、组织流程自己沉淀,这是多数中型团队的实际选择。决策中最常被低估的两项:一是 Compiler 与工具链的集成成本,「能跑 demo」和「能支撑五十人团队每天回归」之间相差数个工程师的年工作量;二是平台利用率——买八片的系统若平均只有三片在干活,等效单位成本翻倍,农场化运营(64 篇)和多项目混部调度正是为了把利用率打满。不要为了省钱省掉的三项:版本与采集基础设施(省了它,所有上板数据的可信度失去保障)、关键板卡的备件(一块板返修四周可以让整个平台停摆,备件约为总片数的一成)、时序与电源设计裕量(为省一点选了刚好够用的器件,第一次加功能就被迫换板)。把这份经济账在项目立项时和技术方案一起评审,让决策者看到原型投入与「流片一次的成本、延期一个月的收入损失、软件提前就绪的价值」之间的数量级关系——一个流片项目的一次重制代价,通常超过整套原型平台十年的花费,这就是这条技术路线存在的最终理由。
十三、术语速查与新成员上手清单
系列导读以一份速查表收尾,帮助新加入项目的成员在第一周建立共同语言。仿真(Simulation)指事件驱动的软件逻辑仿真,速度为千赫到兆赫级,任意信号可见,承担模块级功能回归;仿真加速/硬件仿真(Emulation)指处理器阵列式专用硬件,容量极大、可见性好、按机时计费,承担全芯片早期联调;FPGA 原型(Prototyping)指把设计映射到商用 FPGA 板上真实并行执行,速度快、单位机时便宜,但内部可见性受插桩预算限制,承担真实软件、长时负载与活动采集。RTL Hierarchy 是源码自带的模块实例树;RTL ID 是展开阶段分配、随源码稳定的对象主键;GateID 是逻辑综合阶段为每个门级对象分配的主键;info_table 维护两者与层次路径的映射;manifest 是一次构建的五件套版本清单。TDM(时分复用)指多条逻辑跨片连接共享一条物理互联线;割边是分区后跨越 FPGA 边界的连接;时槽比决定等效系统频率。stub 是不可实现模块的占位替身;替换模型按周期精确、功能等价、近似、占位分级;dont_touch 是阻止综合删除或合并对象的保留属性。新成员的上手建议是:第一天读本篇和 25 篇,建立全链路图景;第一周跑通一次完整构建(从 RTL 到比特流)和一次最小采集,不求理解内部,只求亲手摸到五个版本号如何对齐;第二周按角色精读对应分册并在板上完成一个小的观测或修改任务;之后再进入专题。带着两个问题上手会快得多:「这个信号现在属于哪个域、用什么 ID 引用」以及「我看到的这个现象,在多大程度上代表真芯片」。全系列的训练目标只有一个:让每个成员在自己的岗位上,都能对这两个问题给出确定的、可追溯的答案。
十四、结语:坐标系、纪律与人
回到全系列的起点:50 篇做的全部工作,是为后续十九册建立一个坐标系——横轴是从 RTL 交付到签核消费的八个阶段,纵轴是三方团队的责任边界,而贯穿坐标系的主线是三个标识、一张映射表和一套版本纪律。技术细节会随工具换代而变化,今天的 TDM 方案明天可能被更宽的串行背板取代,商用 Compiler 的自动化程度也会逐年提高,但有三样东西不会变:第一,替代硬件上的现象必须能翻译回原设计,否则它只是昂贵的灯光秀;第二,翻译的可信度来自可追溯的数据结构和强制的版本对齐,而不是任何人的口头保证;第三,系统由三方共同建成,交接物必须机器可读、责任必须显式。对个人而言,这个领域要求罕见的能力组合:既要懂 RTL 和时序的硬件细节,又要有编译器和数据库式的软件工程思维,还要能在团队之间用「能力边界」的语言管理预期。培养这样的人没有捷径,系列的建议路径是从一次完整构建和一次完整采集动手开始,再回到分册深入原理。当一个组织里越来越多的人能同时用硬件和软件两种语言思考、能用数据而不是威望解决争议、能把「这个结论在多大程度上算数」讲清楚时,原型验证就不再是流程末端的一道工序,而成为整个芯片项目的共同语言。
知识脉络
与系列及现有篇目的衔接
- 全链路速览:04 ASIC 原型验证全链路 RTL ID/GateID/层次映射
- 横向深化:02 多 FPGA 原型系统 ASIC 分区/TDM、03 原型平台 bring-up 多片点亮/trace、37 FPGA 与仿真器互联、45 片上 trace 系统、05 原型到硅后衔接 pre/post-silicon 协同/errata
- 调试细节:01 原型验证 Debug IP 寄存器是怎么被访问的
总结
一句话总结:仿真速度(kHz~MHz 等效时钟)跑不动现代 SoC 几十亿条指令的启动与长时负载,流片前要在真实并行硬件上回答「软件能不能跑、性能够不够、真实活动长什么样」,于是形成仿真(最慢但全信号可见、适合功能回归)—FPGA 原型(1~30 MHz、便宜、适合跑真实软件与长时 soak 但内部可见性受插桩预算限制)—Emulation(0.5~5 MHz、容量巨大、可见性好但极贵)的手段光谱;原型的四类价值是软硬件协同、固件 shift-left、架构性能评估和真实激励活动反哺签核;全链路由 ASIC 设计(阶段 0/7)、Compiler(阶段 1~3:展开、替换、分区、综合,产出 RTL ID/GateID/info_table)、FPGA 原型团队(阶段 4~6:P&R、上板、采集、回映)三方按机器可读的交接物协作,主线是三个不进比特流、只存于工程服务器的标识——源码自带的 RTL Hierarchy、Elaboration 后固定的 RTL ID、逻辑综合后产生的 GateID,经 info_table 串成 GateID↔RTL ID↔层次路径映射,让 Gate 域采集能查回 RTL;50 篇建坐标,51~69 逐阶段展开,全系列的共同纪律是 ID 稳定可追溯、替换关系显式留档、RTL/网表/比特流/映射表四位一体版本对齐。