SV 用例基类派生:testcase 基类设计、派生用例与 plusarg 工厂选择实战
更新时间:2026-09-28。在 UVM 组件与 phase 里,整个 testbench 的顶层是
uvm_test:它是 phase 执行的入口、组件树的根。但一个项目动辄几百条用例,如果每条用例都从uvm_test裸派生、各自把 env 搭一遍,代码复制会泛滥到无法维护。SV 用例基类派生解决的就是这件事:把「所有用例都要做的事」收进一个项目级 testcase 基类,派生用例只写差异。这一篇讲清基类该装什么、派生该写什么、以及回归时怎么用 plusarg 和工厂机制选择要跑哪条用例。
本文要回答的问题
- testcase 基类和派生用例之间的职责边界怎么划,什么该进基类、什么必须留在派生类?
- 基类的
build_phase、connect_phase、run_phase各阶段分别该放什么逻辑? - 派生用例想改激励行为,应该改约束、改 sequence 还是 override 组件?
- 仿真启动时怎么用
+UVM_TESTNAME和自定义 plusarg 选择用例与配置? - 回归规模上到几百条用例后,基类设计不当会踩哪些坑?
一、为什么所有用例要共享一个基类
先看反例。早期项目里常见这样的写法:每条用例直接 extends uvm_test,然后在 build_phase 里 new env、设 config、注册 verbosity,几十行几乎一样的代码复制到每个文件里。三个月后 DUT 加了一个接口,env 结构要变,于是打开两百个用例文件逐个改——漏改的那几条在回归里静默跑出了错误结果,因为旧 env 恰好还能编译过。
基类派生把这条链拧过来:共性下沉,差异上浮。所有用例共享的 env 例化、config_db 设置、objection 模板、报告开关,全部写在一个 base_test 里;具体用例(如 sanity_test、error_inject_test)从 base_test 派生,只写自己独有的那部分——通常是换一条 sequence、调一组约束、或者覆盖一个组件配置。这正是 SystemVerilog 类继承与多态 在验证平台里最经典的一次落地:基类定义骨架,派生类填充变化点。
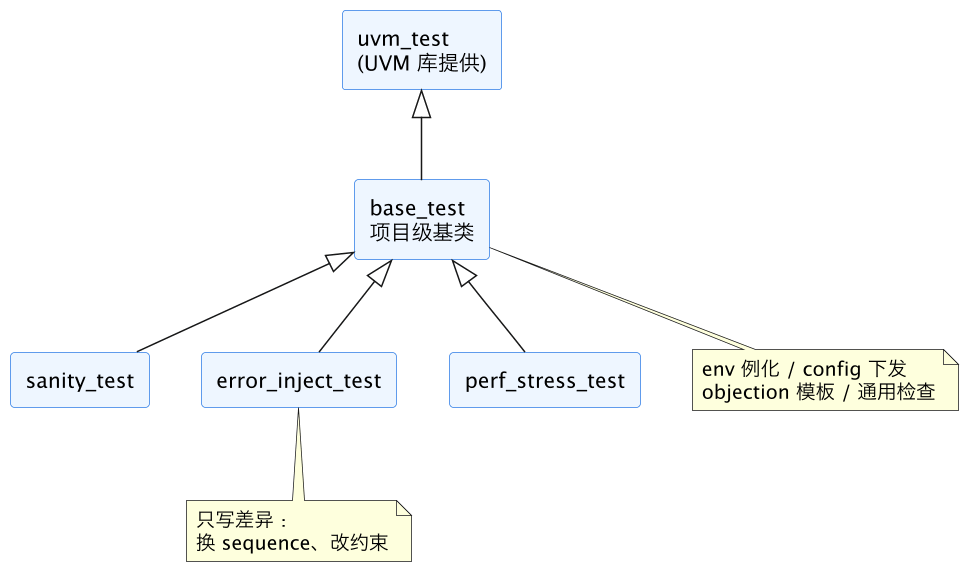
上图是典型项目里的用例继承结构:uvm_test 是 UVM 库的根,项目自己的 base_test 夹在中间,所有具体用例挂在 base_test 下。中间这一层是整个策略的核心——它是「这个项目所有用例的公约数」,也是将来改架构时唯一要动的文件。
职责划分用一张表说清:
| 职责 | 归属 | 理由 |
|---|---|---|
| env 例化与配置下发 | 基类 | 所有用例共用同一棵组件树 |
| virtual interface 获取与传递 | 基类 | 取自 config_db 的样板代码 |
| objection 提起/撤销的骨架 | 基类 | 结束条件模板化,派生只关心何时完成 |
| 启动哪条 sequence | 派生类 | 这是用例之间的本质差异 |
| 事务约束收紧/放松 | 派生类 | 定向场景各不同 |
| 组件 factory override | 派生类 | 换 driver、换 monitor 属于用例意图 |
| timeout 看门狗 | 基类(参数可被派生改) | 防挂死人人需要,阈值各用例可调 |
判断一个东西该不该进基类,有个经验准则:想象删掉它之后,是不是每条派生用例都得自己补一份一样的?是,就进基类;只有一部分用例需要,就做基类里的可配置项(成员变量或 config 对象字段),让需要的用例打开它。
二、基类的骨架:各 phase 里放什么
一个实用的 base_test 长这样(省略了 uvm_component_utils 注册等样板):
class base_test extends uvm_test;
  my_env    env;
  my_config cfg;
  int unsigned timeout_ns = 100_000;

  function void build_phase(uvm_phase phase);
    super.build_phase(phase);
    cfg = my_config::type_id::create("cfg");
    cfg.has_err_inject = 0;            // 默认值,派生类可改
    uvm_config_db#(my_config)::set(this, "env*", "cfg", cfg);
    env = my_env::type_id::create("env", this);
  endfunction

  function void end_of_elaboration_phase(uvm_phase phase);
    uvm_top.print_topology();          // 调试期打印组件树
  endfunction

  task run_phase(uvm_phase phase);
    phase.raise_objection(this);
    fork
      run_stimulus();                  // 虚方法,派生类实现
      begin
        #(timeout_ns * 1ns);
        `uvm_fatal("TIMEOUT", "test watchdog fired")
      end
    join_any
    phase.drop_objection(this);
  endtask

  virtual task run_stimulus();         // 基类给默认行为
    `uvm_info("BASE", "no stimulus in base_test", UVM_LOW)
  endtask
endclass三个设计点值得展开。第一,build_phase 里先建 config 对象、设默认值,再 set 进 config_db,最后才 create env——顺序不能反,env 里的组件在各自 build_phase 就要 get 这份配置了。config_db 的用法细节在 UVM config 对象与资源数据库 里有完整展开。第二,看门狗和激励用 fork...join_any 并行:激励正常结束就踢掉看门狗,看门狗先触发说明激励卡死,直接 fatal 收尾,回归里不会出现挂到超时才被杀的僵尸仿真。第三,run_stimulus 声明成 virtual 并给一个空默认实现——这是模板方法模式(template method):基类搭好 objection 和看门狗的舞台,派生类只填演戏的内容。
派生类因此可以非常短:
class error_inject_test extends base_test;
  function void build_phase(uvm_phase phase);
    super.build_phase(phase);          // env 已由基类建好
    cfg.has_err_inject = 1;            // 收紧配置
    set_inst_override_by_type("env.agt.drv",
      my_driver::get_type(), err_driver::get_type());
  endfunction

  virtual task run_stimulus();
    err_seq s = err_seq::type_id::create("s");
    s.start(env.agt.sqr);
  endtask
endclass
注意 super.build_phase(phase) 必须是派生类 build_phase 的第一行:基类的 env 创建、config 下发都靠它,漏写了 env 就是 null,后面 env.agt.sqr 会在运行期才炸,而且报错信息离根因很远。override 语句要在 super.build_phase 之后、env 实际被使用之前——set_inst_override_by_type 影响的是后续 create,env 里的 driver 是 env 自己 build 时才 create 的,所以在基类 build_phase 返回后立刻设置 override 仍然来得及,因为 env 的子组件 build 发生在 UVM 自顶向下展开的下一拍。工厂 override 的完整机制见 UVM 工厂与 env 派生。
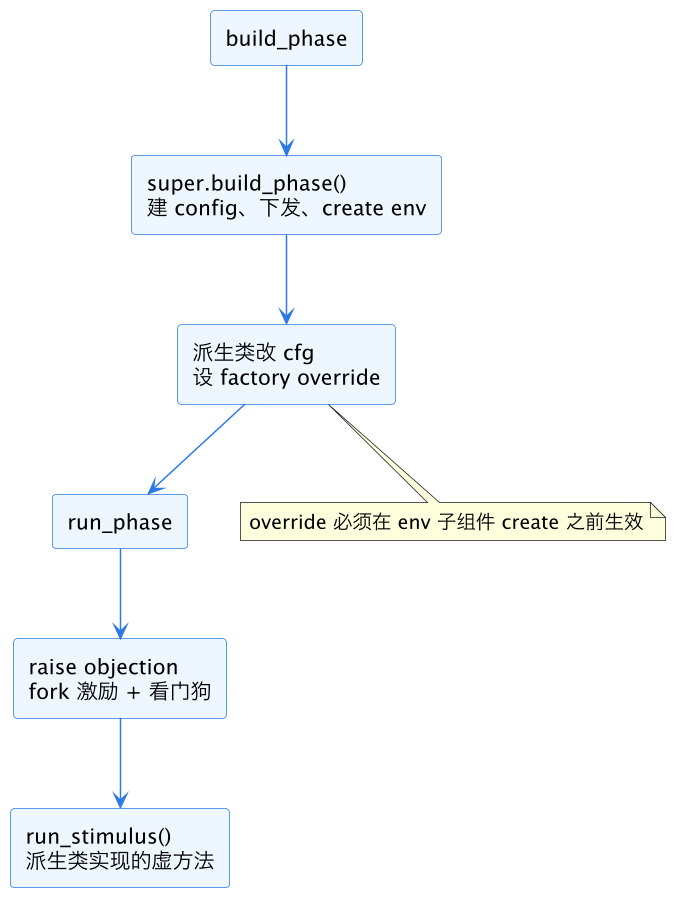
这张流程图对应上面两段代码的执行次序:build 阶段先走基类的通用搭建,派生类随后调整配置和 override;run 阶段基类搭 objection 与看门狗的框架,真正的激励落在虚方法 run_stimulus 里。把时序关系记在脑子里,比背语法重要——绝大多数基类 bug 都是顺序错了,不是语法错了。
三、派生用例的三种定制手段
派生类能改的东西不止换 sequence 一种。按「改动侵入度从轻到重」排,有三种手段,选择原则是能用轻的就不用重的。
第一种是改配置与约束:通过基类暴露的 config 字段、或者派生类里 constraint_mode / inline constraint 收紧随机空间。完全不碰组件结构,风险最小,回归里最稳。
class small_pkt_test extends base_test;
  virtual task run_stimulus();
    my_seq s = my_seq::type_id::create("s");
    // inline 约束把包长压到 64B 以内
    if (!s.randomize() with { max_len <= 64; })
      `uvm_fatal("RAND", "seq randomize failed")
    s.start(env.agt.sqr);
  endtask
endclass第二种是换 sequence:基类跑默认流量,派生类换成错误注入、backdoor 预填、多并发等专用 sequence。sequence 体系本身就是为「激励即插即用」设计的,配合 UVM sequence、driver 与 scoreboard 协作 里讲的 sequencer 握手,换 sequence 对 testbench 其余部分零影响。
第三种是 factory override 换组件:把 driver 换成会注入 CRC 错误的 err_driver,把 monitor 换成记录延迟直方图的增强版。这个手段威力最大,但有两个约束:替换类型必须是原类型的派生类(否则 connect 时对不上端口),而且 override 的层次路径(如 "env.agt.drv")写错字符串不会编译报错,只会静默不生效——所以 override 之后最好在 end_of_elaboration_phase 打印一次工厂信息确认。
| 手段 | 适用场景 | 侵入度 | 回归风险 |
|---|---|---|---|
| 改 config/约束 | 包长、带宽、开关类差异 | 低 | 低 |
| 换 sequence | 激励模式差异 | 中 | 低 |
| factory override | 行为模型差异(错误注入、协议变异) | 高 | 中,需验证 override 生效 |
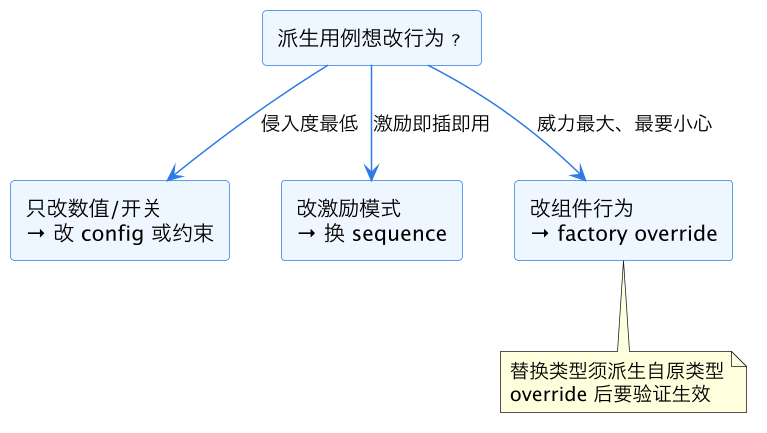
这张决策图建议在写每条新用例前过一遍:先问自己「能不能只调配置做到」,能就停手。真实项目里大约七成用例靠第一种手段就够了,override 留给真正的行为变异。
四、用例选择:UVM_TESTNAME 与自定义 plusarg
用例写好了,回归怎么决定这次仿真跑哪条?UVM 内置的入口是命令行加 +UVM_TESTNAME=error_inject_test:run_test() 不带参数时会读这个 plusarg,通过工厂按名字创建对应的 test 类。这也是为什么每个 test 类都必须用 `uvm_component_utils 宏注册进工厂——没注册的类,名字传进去工厂查不到,直接 fatal。
在此之上,项目通常还会加一层自定义 plusarg 做「用例族 + 种子」的二维选择:
class base_test extends uvm_test;
  function void build_phase(uvm_phase phase);
    string mode;
    super.build_phase(phase);  // 示意,实际顺序见前文
    if ($value$plusargs("MODE=%s", mode))
      cfg.mode = mode;                       // 例:MODE=low_power
    if ($test$plusargs("BACKDOOR_PRELOAD"))
      cfg.use_backdoor = 1;                  // 开关型 plusarg
  endfunction
endclass
$value$plusargs 取带值的参数,$test$plusargs 只判断开关是否存在,两者配合覆盖了绝大多数回归旋钮。更系统的 plusargs 配置打法(分层命名、与 config_db 的分工)会在 plusargs 专题里展开;这里的要点是:plusarg 的解析统一收在基类里,派生类不各自 $value$plusargs——散在各处的 plusarg 解析会让「这个参数到底谁在读」变成考古问题,同一个参数两处解析出不同默认值的事故在真实项目里反复上演。
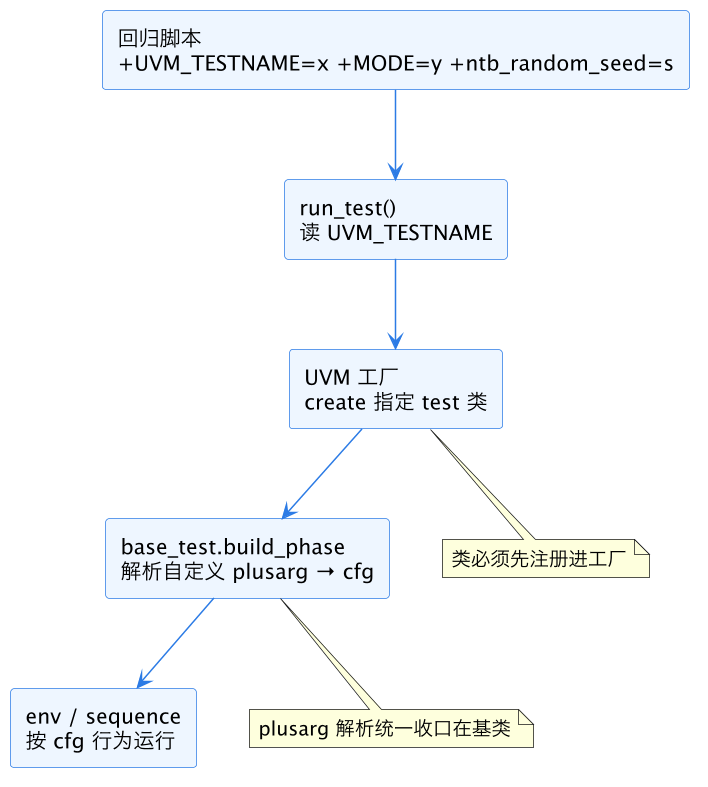
上图是从命令行到仿真行为的完整链路:回归脚本只发 plusarg,UVM_TESTNAME 决定建哪个类,自定义 plusarg 在基类里翻译成 config 字段,组件按 config 行事。链路里每一环都是单点收口——这就是为什么回归规模翻倍时,加用例只需要「派生一个类 + 脚本加一行」,而不是改 testbench。
五、回归规模化后的基类维护坑
用例数从二十涨到两百,基类设计的好坏会被放大成生产力差距。几个反复踩到的坑:
基类膨胀。 某个用例需要一点特殊逻辑,顺手塞进基类加个 if;下一个人照做。半年后基类一千行、十几个互斥开关,没人敢动。对策是死守第一节的职责表:新需求先问「这是不是所有用例的公约数」,不是就放派生类或 config 字段。基类的理想状态是几个月才改一次。
默认行为隐性变化。 基类改了某个默认值(比如 timeout 从 100us 调到 200us),几十条依赖旧默认值的用例行为悄悄漂移,覆盖率掉了还不知道为什么。对策:影响行为的默认值改动,必须在提交信息里点名,并在回归里跑一次全量对比;更好的做法是让派生类显式写它依赖的关键值,不依赖默认。
层次路径硬编码。 set_inst_override_by_type("env.agt.drv", ...) 里的字符串路径,在 env 重构(agent 改名、多了一层子 env)后全部失效,而且失效方式是静默不生效。对策:路径常量集中在基类或 env 里用 get_full_name() 派生,override 后打印工厂 audit;这也是 分层 testbench 架构与复用 强调「组件名稳定即接口稳定」的原因。
seed 与随机稳定性。 基类里任何一处多 new 一个对象、多调一次 randomize,都会改变全局随机流,让所有用例在同一个 seed 下跑出不同激励——复现 bug 时「同 seed 不复现」往往根因在基类改动。随机稳定性的原理与守则在 SV 随机稳定性与 seed 管理 里有专门论述。
| 坑 | 症状 | 对策 |
|---|---|---|
| 基类膨胀 | 基类千行、开关互斥 | 职责表守门,差异回派生类 |
| 默认值漂移 | 覆盖率/行为悄悄变化 | 关键值派生类显式写 |
| 路径硬编码 | override 静默失效 | 常量收口 + 工厂 audit 打印 |
| 随机流扰动 | 同 seed 不复现 | 基类改动审视 new/randomize 次序 |
六、多层基类:从单基类到基类层次
项目再往前走一步,单个 base_test 也会不够。典型场景是公司同时维护多个项目:SoC 级平台和各个 IP 子项目共享一套仿真基础设施(时钟复位生成、日志开关、license 检查、回归结果回传),但各有各的 env。这时自然长成三层:company_base_test(跨项目公约数:plusarg 规范、看门狗、结果回传)→ proj_base_test(本项目 env 例化与 config 下发)→ 具体用例。
层次化之后,第一节的职责表要按层重新分配,原则不变:每一层只收「它的所有子树」的公约数。跨项目基础设施沉到最底层,项目相关收中间层,用例差异留在叶子。判断一个新需求进哪一层,还是那条删掉测试——删掉之后,是不是这个层所有子类都得各自补一份?
两层以上要额外防两件事。一是中间层被遗忘:新人写用例直接从 company_base_test 派生,绕过了项目层,env 没建、config 没下发,编译能过、运行时才炸。对策是在 company_base_test 的 build_phase 里留一个纯虚(或 fatal 默认)的 build_env() 钩子,强迫中间层实现。二是super 链断裂:三层结构里每一层 build_phase 都要先 super.build_phase(phase),中间层漏写一次,底层的基础设施就静默消失——症状是 plusarg 不解析、看门狗没了,回归挂死才被发现。code review 里对「phase 方法第一行」的检查值得做成 lint 规则。
| 层次 | 收什么 | 修改频率 |
|---|---|---|
| company_base_test | plusarg 规范、看门狗、结果回传、日志开关 | 半年级 |
| proj_base_test | env 例化、config 下发、objection 骨架 | 月级 |
| 具体用例 | sequence 选择、约束收紧、override | 随时新增 |
回到单项目视角,如果基类始终只有一层,也不用焦虑——多层结构是规模逼出来的,提前抽象只是徒增跳转成本。守住「共性下沉、差异上浮」这条总原则,层次该长出来的时候自然会长出来。
这一篇在知识体系里的位置
本篇是验证方法学「用例组织」环节的核心一篇:向上,它依赖 UVM 组件与 phase 的 phase 机制和 SystemVerilog 类继承与多态 的虚方法/多态基础;横向,它与 UVM 工厂与 env 派生、UVM config 对象与资源数据库 共同回答「用例之间怎么不同」;向下,它组织的激励最终由 UVM sequence、driver 与 scoreboard 协作 执行,跑出来的结果进 回归管理与失败分类 的流水线。读懂这一篇,就有了从零搭建一个可扩展用例体系的完整图纸。
总结
SV 用例基类派生的本质是「共性下沉、差异上浮」:项目级 base_test 收走 env 搭建、config 下发、objection 骨架、看门狗与 plusarg 解析这些所有用例的公约数,派生用例只用改配置、换 sequence、或 factory override 三种由轻到重的手段写差异,回归通过 +UVM_TESTNAME 与自定义 plusarg 选择用例——守住这条边界,用例数从二十涨到两百也只是「派生一个类、脚本加一行」的事。