UVM Sequence 写法:sequence/item/sequencer 三角关系与 uvm_do 宏拆解
在 UVM Testbench 架构入门 里我们把验证平台拆成了 env、agent、driver、monitor 这些角色,但那篇只回答了「激励从哪条管子流过」,没回答「激励本身怎么写」。本篇聚焦激励的源头——sequence 层。它是 UVM 里最容易让新手绕晕的部分:sequence 不是组件、没有 phase、却能把事务一笔一笔「流」进 driver。理解它的关键在于看清 sequence、sequence_item、sequencer 三者的分工,以及 uvm_do 宏在背后替你做的那几步握手。driver 侧拿到 item 之后的完整回路,另有一篇 UVM Driver 与 sequence_item 的数据流 专门展开,两篇配合阅读。
本文要回答的问题
- 为什么 UVM 要把「一笔事务」(item)和「一段激励序列」(sequence)分成两个类?
- sequence、sequencer、driver 三方各管什么,数据从谁手里流到谁手里?
- 一个最小可跑的 sequence/item 长什么样,字段、约束、注册宏怎么写?
`uvm_do宏展开后到底发生了什么,手工等价的start_item/finish_item怎么写?- 什么时候该绕开宏、手工控制 item 的发送过程?
一、为什么激励要拆成「事务」和「序列」两层
写裸 SV testbench 的时候,激励通常是几个 task:send_one_pkt(8'h12, 64)、send_one_pkt(8'h34, 128),参数写死、顺序写死,想换一种组合就再写一个 task。约束随机(见 约束随机验证入门)兴起之后,大家发现「一笔事务长什么样」和「以什么顺序发多少笔」是两件正交的事:前者是数据模型,后者是场景编排。UVM 于是把它们拆成两个类:
| 角色 | 基类 | 归属 | 一句话职责 |
|---|---|---|---|
| sequence_item | uvm_sequence_item | 数据(object) | 一笔事务的字段与约束:地址、数据、长度、类型 |
| sequence | uvm_sequence | 行为(object) | 用代码编排「发哪些 item、发多少、什么顺序」 |
| sequencer | uvm_sequencer | 组件(component) | 仲裁多个 sequence 的请求,把 item 逐个交给 driver |
这个拆分的直接收益是复用:同一个 my_item 类,可以被「随机打 100 笔」的 smoke sequence 用,也可以被「先连续写再连续读」的 directed sequence 用;同一个 sequence,挂在 APB agent 的 sequencer 上发 APB 事务,换个项目换个 agent 照样跑。字段和约束只写一遍,场景可以无限叠加。
还有一个容易被忽略的点:sequence 和 item 都是 object 而不是 component,它们不占 uvm_top 下的层次位置、不经历 build/connect 等 phase(phase 的来龙去脉见 UVM 组件与 phase 机制),纯粹是「按需 new 出来、跑完就丢」的临时对象。这决定了 sequence 天然适合表达「动态生成、用完即弃」的激励流。
二、三角关系:sequence 生产、sequencer 仲裁、driver 消费
三个角色之间的数据通路是 UVM 激励机制的主干,先用一张流程卡把整条链路立起来:
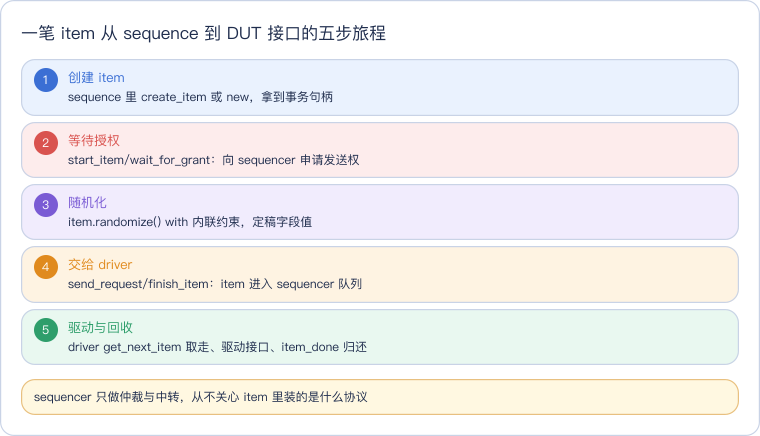
读这张图抓住一条主线:sequence 是生产者、driver 是消费者、sequencer 是中间的传送带兼红绿灯。sequence 主动「推」,但推之前必须先举手申请(第 2 步);driver 主动「拉」,拉完要还(item_done)。sequencer 站中间,当多个 sequence 同时挂在一个 sequencer 上时,由它按仲裁算法决定谁先发——仲裁策略的坑(lock/grab、优先级)在 UVM Sequencer 仲裁机制 和 lock 与 grab 的独占语义 里单独讲,本篇先记住默认是 FIFO 公平仲裁。
这个「推-拉结合」的握手模型有个重要推论:sequence 的 body() 是一个会阻塞的过程。finish_item 不返回,sequence 的代码就停在那里等。所以 sequence 天然是按时间顺序书写激励的好地方——代码写在上面的 item 一定先被驱动,不需要任何额外的同步原语。
三、最小可跑的 sequence_item 与 sequence
先看 item。一个 sequence_item 的核心是三样东西:字段、uvm_field_* 自动化宏(或 do_copy/do_compare 手工钩子)、约束块。
class apb_item extends uvm_sequence_item;
  rand bit [31:0] addr;
  rand bit [31:0] data;
  rand bit        write;      // 1=写 0=读
  rand int        delay;      // 事务间隔拍数

  constraint c_addr  { addr[1:0] == 2'b00; }            // 4 字节对齐
  constraint c_delay { delay inside {[0:10]}; }

  `uvm_object_utils_begin(apb_item)
    `uvm_field_int(addr,  UVM_ALL_ON)
    `uvm_field_int(data,  UVM_ALL_ON)
    `uvm_field_int(write, UVM_ALL_ON)
    `uvm_field_int(delay, UVM_ALL_ON)
  `uvm_object_utils_end

  function new(string name = "apb_item");
    super.new(name);
  endfunction
endclass
几个细节值得停下来看一眼。第一,字段加 rand 是为了让 sequence 端能 randomize();不加 rand 的字段(比如错误注入标记)由 sequence 直接赋值。第二,uvm_field_int 宏自动注册 copy/compare/print/pack 等行为,代价是宏展开体积和仿真开销,字段很多的大事务类可以考虑手工钩子——这笔账在 UVM field 宏的代价与取舍 里算得很细。第三,约束写成 soft 还是普通约束要有意识:基类库里留给用户覆盖的约束该用 soft,否则用户想收紧时会撞硬冲突。
再看 sequence。它继承 uvm_sequence #(apb_item),核心是一个 body() task:
class apb_write_seq extends uvm_sequence #(apb_item);
  `uvm_object_utils(apb_write_seq)

  rand int num = 16;
  constraint c_num { num inside {[8:32]}; }

  function new(string name = "apb_write_seq");
    super.new(name);
  endfunction

  virtual task body();
    apb_item req;
    repeat (num) begin
      `uvm_do_with(req, { write == 1; addr inside {[32'h0:32'hFF]}; })
    end
  endtask
endclass
uvm_do_with 是 uvm_do 家族里最常用的一个:创建一笔 req、按内联约束随机化、发出去,一行顶手工五步。sequence 在 test 里通过 seq.start(env.apb_agt.sqr) 启动——start 做的事是把 sequence 挂到指定 sequencer 上、调 pre_body/body/post_body,body 返回后整个激励流就结束了。配合 UVM Sequence、Driver 与 Scoreboard 的协作 里讲的平台全貌,到这里你已经能写出一个完整 agent 的激励侧。
四、uvm_do 宏背后:五步握手逐个看
宏写起来爽,但调试时你会盯着波形问「为什么这个 item 没发出去」「为什么 sequence 卡住了」——这时候必须知道宏展开后是什么。uvm_do_with(req, {...}) 等价于下面这五步:
// 1. 创建(走 factory,可被 override)
req = apb_item::type_id::create("req");
// 2. 申请发送权:等 sequencer 仲裁放行
start_item(req);
// 3. 随机化(内联约束在这里生效)
if (!req.randomize() with { write == 1; addr inside {[32'h0:32'hFF]}; })
  `uvm_error("RANDFAIL", "randomize failed")
// 4. 把 item 推给 sequencer,阻塞等 driver 的 item_done
finish_item(req);
start_item 内部又拆成「等授权(wait_for_grant)」和「(可选的)pre_do 回调」;finish_item 内部是「send_request 把 item 塞进 sequencer 的请求队列,然后 wait_for_item_done 阻塞」。整条链路和 driver 侧的 get_next_item/item_done 对接,画成时序图更直观:
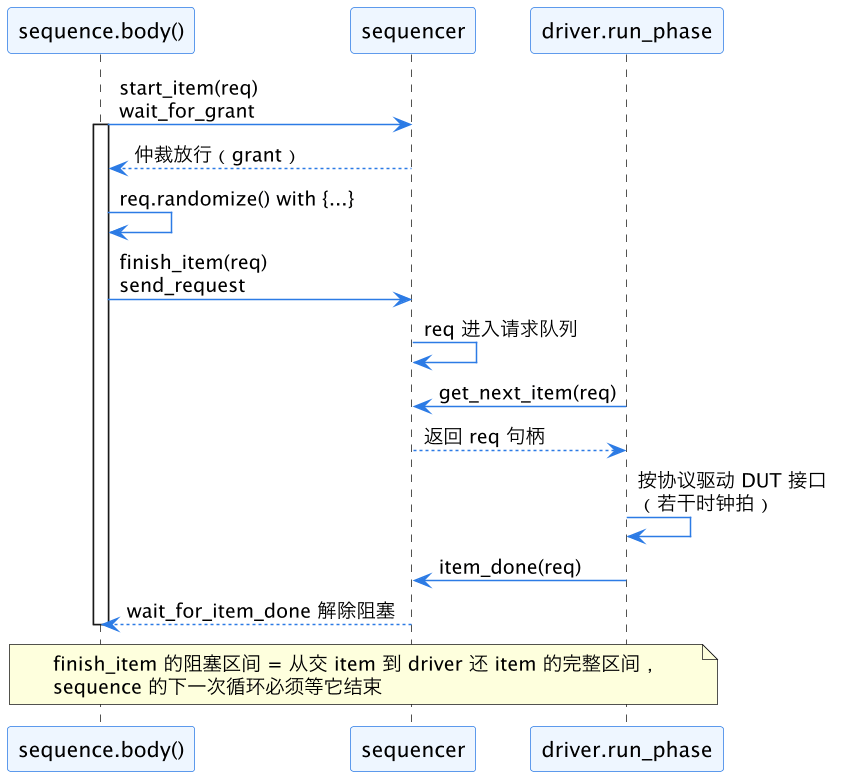
这张图要盯住的两个点:其一,start_item 和 finish_item 都可能阻塞,前者等仲裁、后者等 driver 归还——「sequence 卡死」类问题九成发生在这两个等待点上,顺着时序图找是谁没授权或谁没还 item 就能定位。其二,driver 的 get_next_item 是拉的动作,如果 driver 代码里忘了写 item_done(或者异常路径跳过了它),sequence 会永远停在 finish_item 里——这是新手最高发的 hang 死原因,比 UVM objection 永不落下导致的仿真不收尾 还要常见。
五、什么时候绕开宏:手工控制的三类场景
uvm_do 宏覆盖了 80% 的日常场景,但有三类情况必须手工写五步:
- 随机化和发送之间要夹私货。比如随机化之后要根据结果算一个 CRC 填回字段、或者要把 addr 记下来供后续读检查用——宏里没地方插这刀,手工写法在
randomize()和finish_item之间随便加逻辑。 - driver 用
get/put或 response 模式。带响应的协议(driver 回传rsp,sequence 里get_response(rsp))推荐手工流 +uvm_create/uvm_send的组合,事件点更清晰;response 队列溢出、rsp 与 req 配对这类细节在 Driver 与 sequence_item 数据流 有完整写法。 - 性能敏感的大规模激励。宏展开的
create走 factory 字符串查找,千万级 item 的场景下可以预创建 item 池复用、跳过 factory——这是进阶优化,先把语义写对再谈。
另外提醒一个语义陷阱:uvm_do 宏里的变量名有约定(第一个参数是 item 句柄名,宏内部直接引用),把宏包在自己写的 task/循环里时,注意句柄作用域别遮蔽。真遇到「宏在 for 循环里行为诡异」,第一步就是把它展开成手工五步再调。
六、把 sequence 接进平台:start、default_sequence 与 virtual sequence
sequence 写好后有三种挂载方式。最常用的是 test 的某个 phase 里显式 seq.start(sqr)——控制权完全在 test 手里,多次 start、传参、串行拼接都直观。第二种是给 sequencer 配 default_sequence(run_phase 自动拉起),适合「这个平台永远要有个背景流量」的场景,细节与覆盖顺序见 UVM default_sequence 配置与覆盖。第三种是多 agent 协调:用 virtual sequence 拿着各 agent sequencer 的句柄统一编排,这是 SoC 级环境的标配,入口写法见 UVM virtual sequence 的 start 方式,其中 m_sequencer 与 p_sequencer 的差别(一个常见踩坑点)在 m_sequencer 与 p_sequencer 辨析 里专门讲。
层级再往上还有 sequence 套 sequence(分层序列,把「初始化配置」「正常流量」「错误注入」各写成子序列再组合),这套打法见 UVM 分层 sequence 堆叠。但不管堆多少层,落到最底层仍然是本篇讲的五步握手——机制只有一套,组合是无限的。
这一篇在知识体系里的位置
本篇是 UVM 激励链路的中段:上承 UVM Testbench 架构入门(平台骨架)与 UVM 组件与 phase 机制(生命周期),下接 UVM Driver 与 sequence_item 的数据流(item 的下半程)与 UVM Sequencer 仲裁机制(多 sequence 并发)。随机化字段与约束的深入写法见 约束随机验证入门 与 约束调试:求解失败怎么办。说明一点:UVM 依赖商业仿真器,本文的类与宏均按 IEEE 1800.2 标准语义描述,建议在自己的仿真环境里跑一遍最小例子验证手感。
一句话总结
UVM Sequence 写法的本质是「生产者-传送带-消费者」三角:sequence_item 定义一笔事务的字段与约束,sequence 用阻塞式的 body() 按时间顺序编排激励,sequencer 仲裁并把 item 中转给 driver;uvm_do 宏只是「create → start_item 等授权 → randomize → finish_item 等归还」五步握手的糖衣,吃透这五步,sequence 卡死、item 丢失、响应配对失败这类问题就都有了排查锚点。