多 Vt 漏电优化:先全 LVT 收敛时序、再 leakage recovery 换回 HVT/SVT 的完整打法
STA setup 修复里说过,收敛 setup 的两大武器是 sizing 和 VT swap;STA hold 修复里又说过,换慢速 VT 是 hold 修复的性价比之王。这两篇都把 VT 当成「修时序的手段」,而本篇换一个视角:多 Vt 漏电优化——VT 类别本身就是功耗变量。先进节点上漏电占总功耗 30%-50%,同一个逻辑门 LVT 版和 HVT 版的漏电差 5-10 倍,于是一条成熟的工程路线被反复验证:先放开 LVT 把时序抢下来,再系统性地把用不着的快换回慢,把漏电一笔一笔收回来。这一收一放之间的流程设计、swap 规则和副作用管理,就是本篇的内容。
本文要回答的问题
- 为什么工程上不是「按需混用 VT」,而是「先全 LVT 再回收」这种看似浪费的两段式?
- leakage recovery 的收益量级到底有多大?各阶段的回收空间怎么分布?
- VT swap 的硬规则是什么?footprint 兼容意味着什么、哪些 swap 是禁止的?
- 换回 HVT/SVT 之后,IR drop、老化(NBTI/HCI)会受到什么影响?
- 一轮完整的 leakage recovery 要过哪些回归闸门,才能确认时序没被回马枪打翻?
一、为什么是两段式:先抢时序,再收漏电
直觉上最省事的策略是「每个单元一开始就用恰好够快的 VT」,但综合和布局布线工具做不到这一点——时序是物理的:一条路径快不快,要等单元摆下去、线连起来、寄生提出来才知道。综合阶段的时序估计和 post-route 真相差 20%-40% 是常态。如果初期保守用 SVT,等物理信息到位后发现关键路径收不住,再把成千上万处 SVT 换 LVT,每次 swap 都可能牵动版图和布线,迭代收不了尾。
反过来「先全 LVT」把问题变成了单向的:LVT 是库里最快的版本,用它收敛时序等于给每条路径买了最大的余量保险;时序一旦收敛,剩下的工作只剩一个方向——把余量厚的路径上的单元换回慢 VT,只降功耗、不碰时序红线。这个过程叫 leakage recovery(漏电回收),也叫 VT 回收或 power recovery。它的本质是把「时序余量」这种已经花不出去的资产,兑换成「漏电下降」这种实实在在的收益。
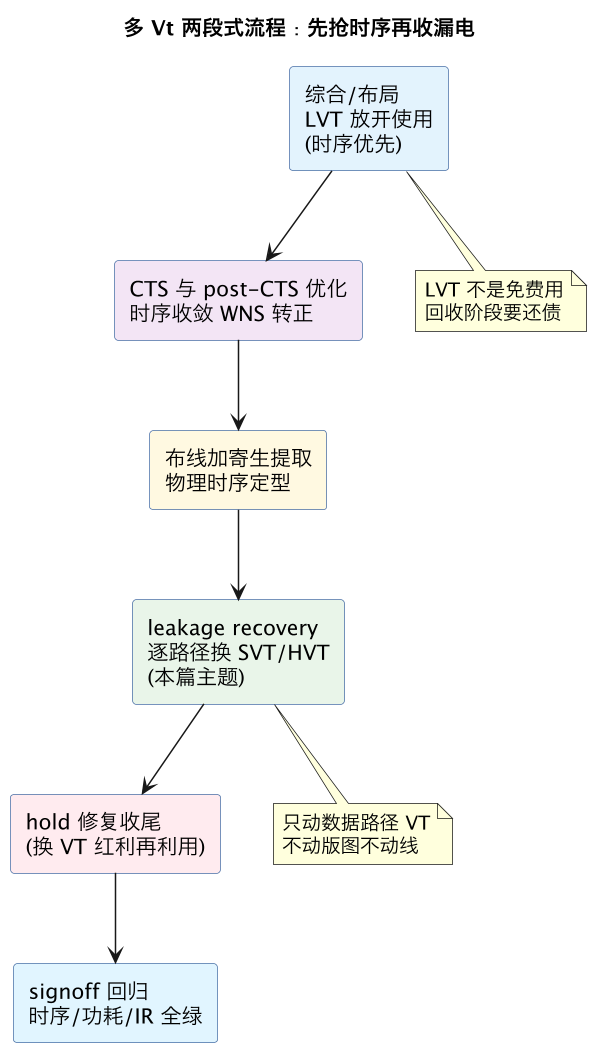
注意图里 leakage recovery 的位置:它在 post-route 寄生定型之后、hold 修复收尾之前。这个位置不是随意的——recovery 本身会把路径变慢,天然附赠 hold 修复效果,所以 hold 大修复排在它后面能白捡一批违例消失;而把它排在寄生定型之前则是浪费,因为那时候的时序余量还是估计值,换错了还得换回来。
二、收益量级:漏电到底能收回多少
先看单管级的事实。阈值电压每抬高一档,亚阈值漏电大约指数下降:同族单元 LVT→SVT 漏电降 3-5 倍,SVT→HVT 再降 3-5 倍,LVT→HVT 合计 5-10 倍。代价是延迟:LVT→SVT 慢 15%-25%,SVT→HVT 再慢 15%-20%。这两组数字决定了整条策略的轮廓——用延迟余量换指数级的漏电收益,只要余量是真的,这买卖永远划算。
设计级的收益量级,来自对大量实际项目 recovery 报告的经验归纳:
| 阶段 | 典型操作 | 可换单元占比 | 漏电降幅 |
|---|---|---|---|
| 综合后第一次 recovery | 非关键路径 LVT→SVT | 40%-60% 的 LVT 单元 | 总漏电降 20%-30% |
| post-route recovery | 按真实寄生重算再换 | 剩余 LVT 的 50%-70% | 再降 15%-25% |
| signoff 前最后一轮 | SVT→HVT 精修 | 全设计 20%-40% 单元 | 再降 10%-20% |
| 三轮累计 | LVT 占比压到 5%-15% | — | 漏电累计降 30%-60% |
这张表里最容易被误读的是最后一行:30%-60% 是「漏电」的降幅,不是「总功耗」的。总功耗里还有动态功耗(VT swap 基本不动它,因为翻转功耗由负载电容和电压决定),所以折算到总功耗,典型收益是 10%-25%。别嫌少——先进节点一个漏电占 40% 的设计,砍掉一半漏电就是总功耗降 20%,直接决定能不能塞进目标散热封装,或者移动芯片能不能过续航指标。
收益的分布在设计内部极不均匀,这决定了 recovery 引擎的工作方式。时序分析给出的路径 slack 分布通常是长尾的:少数关键路径 slack 贴着零,大量非关键路径 slack 厚达几百皮秒甚至上纳秒。一个百万实例级模块里,slack 大于 200ps 的时序单元常常占 60% 以上——这些就是 recovery 的主矿脉。引擎按「每消耗 1ps slack 换多少漏电下降」给候选 swap 排序,优先做性价比最高的交易,所以实际报告里常见「前 20% 的 swap 贡献了 70% 的漏电收益」这种集中度。这也意味着 recovery 的边际收益递减很快:第一轮把厚余量路径扫完之后,剩下的都是贴着守护线的硬骨头,再压收益小、风险大,这也是「两轮收手」节奏的底层原因。
还有一个结构性收益常被忽略:漏电对温度极其敏感(温度每升 25°C 漏电大约翻一倍),而芯片的漏电大头又集中在最热区域,形成正反馈。把热区附近的 LVT 换成 HVT,砍掉的不只是名义漏电,还压住了「温度升→漏电升→温度再升」的循环增益,这对 Voltus/RedHawk 签核里的热-功耗迭代收敛是实打实的帮助。
三、swap 规则:footprint 兼容是底线
leakage recovery 之所以能成为 post-route 阶段的常规操作,靠的是标准单元库的一条设计纪律:同族不同 VT 的单元 footprint 完全相同。BUF_X2 的 LVT、SVT、HVT 三个版本,宽、高、pin 位置、金属层占用一模一样——区别只在阈值注入的掺杂,版图外形无差异。这意味着 VT swap 是纯网表操作:不改尺寸、不动位置、不重布线,把单元名里的 L 改成 H 就完事,是 metal-only ECO里最干净的一类变更。
但「footprint 兼容」有四个边界,越界就是事故:
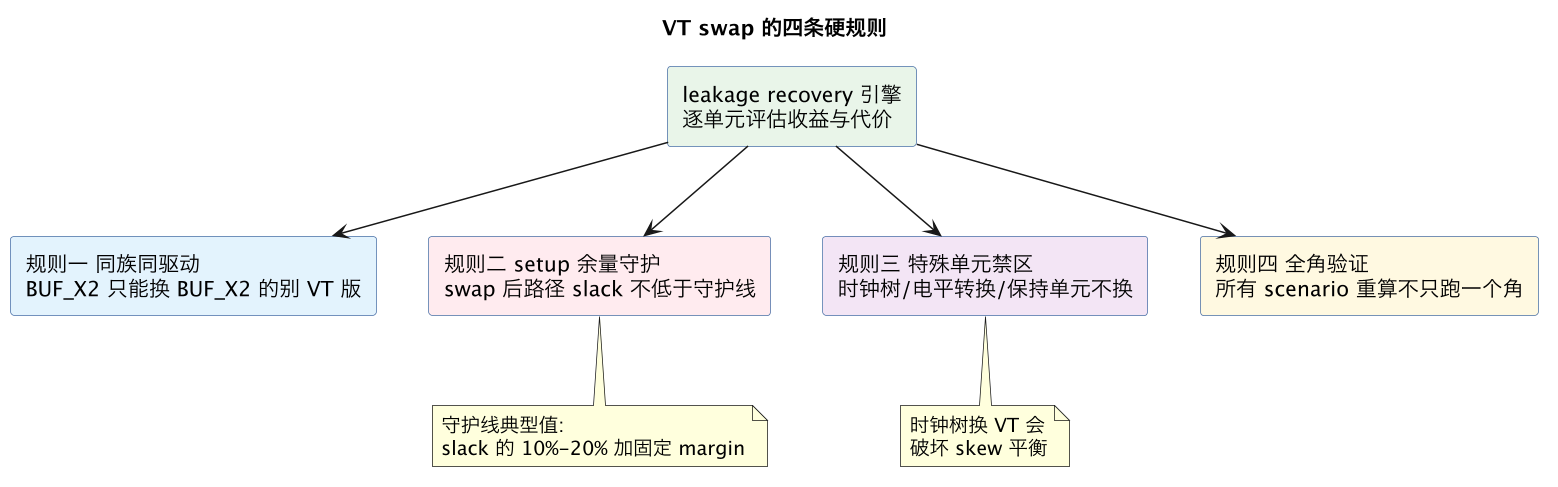
规则一的字面意思之外还有一层:换 VT 不能顺手改驱动。BUF_X2 换成 BUF_X4 的 HVT 版虽然可能时序也满足,但 X4 版图更大,footprint 不兼容,布局就裂了。recovery 引擎的候选集必须锁死在「同逻辑、同驱动、同 footprint」三个条件上。
规则二是收益和风险的平衡器。一条路径 slack 100ps,把上面的 LVT 换成 SVT 要吃掉 30ps,换不换?直接换到 slack 归零是玩火——slack 是统计量,POCV 波动、SI 串扰、电压降都会再吃余量。工程做法是设守护线:recovery 只允许吃掉每条路径 slack 的一部分(典型 50%-80%),且 swap 后 slack 不得小于一个固定下限(比如 20-30ps)。守护线越保守,回收收益越小但回归越稳;临近流片时把守护线收紧是标准操作。
规则三的禁区清单:时钟树单元(换 VT 改变 clock latency,直接打破 CTS 调好的 skew 平衡,见 CTS 时钟树 的同类纪律)、电平转换器和 isolation 单元(UPF 定义的功耗域接口,换了可能破坏 UPF 功耗意图)、spare 单元(留着做功能 ECO 的种子,换成 HVT 以后用不上)、以及所有被 时序 ECO what-if 分析标记为敏感的路径上的单元。
规则四对应一个真实翻车模式:某个角下 slack 很厚,换了 VT 结果另一个角违例。多 scenario 设计里,一个单元往往同时出现在 setup 角、hold 角、功耗角的时序图里,recovery 必须在所有 active scenario 的并集约束下做决策——工具术语叫「multi-scenario recovery」,只跑单角的 recovery 报告是假绿。
四、换慢之后:与 IR drop 和老化的相互影响
把几十万单元换成 HVT/SVT,副作用不会为零,主要集中在两个方向。
IR drop 方向总体是利好但分布会变。漏电下降直接降低静态电流,电源网上的 DC 压降随之减小;动态电流方面 VT swap 不改变翻转率,但慢 VT 单元驱动能力弱、输出斜率变缓,峰值 di/dt 反而更平缓,对瞬态压降也是好消息。但有一个反向机制要警惕:换慢之后单元延迟变长、对供电电压更敏感(延迟对 VDD 的敏感度随 VT 升高而增大),同样 5% 的 IR drop,HVT 路径的延迟退化比 LVT 路径更大。所以 recovery 之后必须重跑一次 IR vectorless 与 vector-based 分析——不是为了看压降(它多半变好了),而是要把新的电压分布反标回 STA,确认低电压区域里没有 slack 被压穿的路径。recovery 和 IR 是耦合迭代:换 VT 改了电流分布,电流分布改了延迟,延迟又可能打开新的 recovery 空间,收敛标准是两轮之间 slack 变化小于阈值。
老化方向是把双刃剑。先说利好:换回 HVT/SVT 后漏电降、局部温度降,而 NBTI(负偏置温度不稳定性,PMOS 在负栅压高温下阈值电压随时间漂移)和 HCI(热载流子注入)的退化速率都对温度指数敏感,降温直接延寿;HVT 单元本身初始阈值就高,同样绝对量的 ΔVth 漂移占的比例更小。再说风险:慢 VT 单元的驱动电流小,老化导致的驱动能力下降在快路径上更显著——一条用足守护线余量的 SVT 路径,三年后 NBTI 再吃掉几十 ps,可能从「刚好达标」变成「现场失效」。这就是 老化可靠性签核要和 leakage recovery 对账的原因:recovery 的守护线里应该显式包含老化余量(aging margin),签核工具(PrimeTime 的 aging 分析或专用可靠性工具)会把 NBTI/HCI 的 ΔVth 模型叠进 STA,凡是 aging 后 slack 转负的路径,recovery 阶段就不该把它的余量换走。
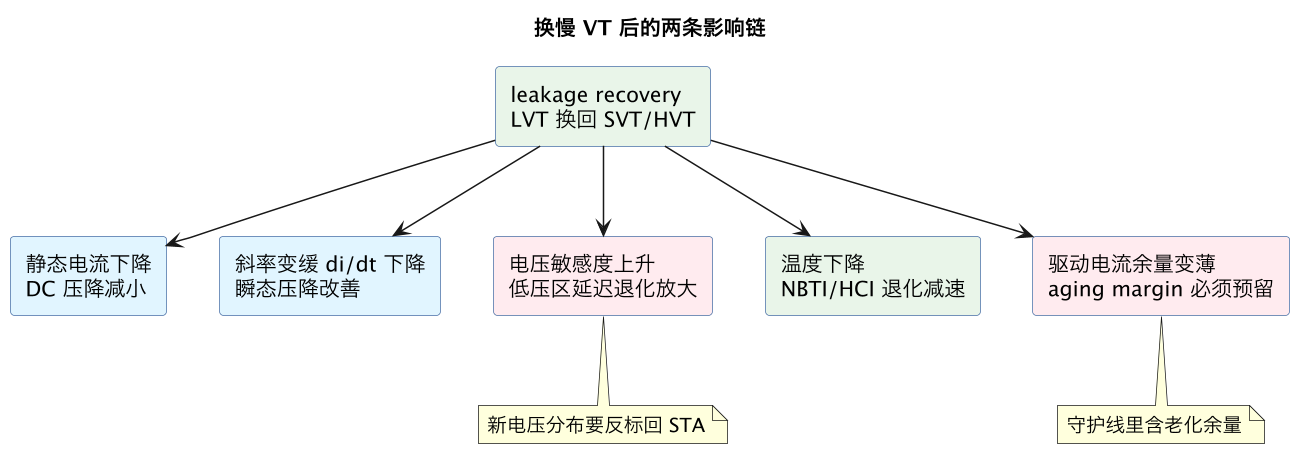
这张图的核心读法:recovery 的收益(绿)和代价(红)都真实存在,工程上不是回避代价,而是把代价折成余量提前记账——IR 反标和 aging margin 就是那两本账。
五、回归闸门与实战节奏
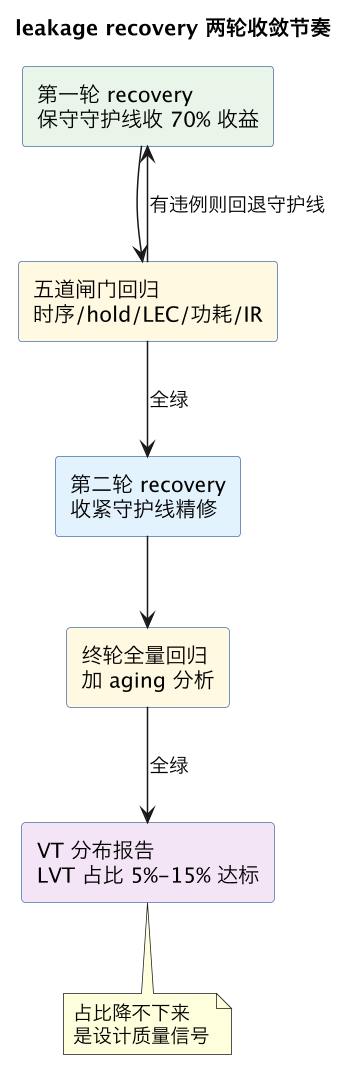
一轮 leakage recovery 动的是全设计 20%-50% 的单元,回归必须按闸门走:时序全角回归(所有 setup scenario 重算,WNS/TNS 与 recovery 前对齐)、hold 复看(换慢附赠红利,但个别被守护线卡住没换的路径要确认没被相邻路径的 sizing 牵连)、LEC 等价性(VT swap 逻辑等价,但几十万处网表变更必须过 Formality LEC 兜住脚本错误)、功耗重签(leakage 数字进 功耗签核 总账)、IR/热迭代(上节的对账)。五道闸门全绿,这一轮 recovery 才算落袋。
回归执行层有几个容易踩的实现坑。一是增量提取的范围:VT swap 不改版图不改线,理论上寄生不变,但工具的增量提取默认按「网表变了就重提」处理,几十万处变更会触发大范围重提,跑一轮全量 SPEF 以天计——正确姿势是显式告诉流程「本 ECO 仅 VT 变更、几何不动」,让提取走旁路、STA 直接复用旧寄生只换时序库视图。二是多 VT 库的视图一致性:recovery 用的是哪一套 liberty 的漏电数据,功耗签核就必须用同一套,混用不同特征化批次的库(比如 recovery 用 Q2 版库、签核用 Q3 版库)会让收益数字对不上账,liberty 时序模型里讲过 NLDM 与 CCS 的功耗数据差异,这类不一致在审计里是会被揪出来的。三是别把 recovery 和 sizing 混在一轮里做:sizing 动 footprint 要牵动布局,和纯 VT swap 的「零物理扰动」假设冲突,混做之后回归挂了很难归因,纪律是一轮只做一类变更。
实战节奏上还有两个经验。其一,recovery 不要一轮打满:第一轮用保守守护线收 70% 的理论收益,跑回归;确认没问题再收第二轮。一次把守护线压到底、回归挂了再回退,比重来两轮贵得多。其二,留一份 VT 分布报告当体检表:recovery 结束时 LVT 占比 5%-15% 是健康区间;占比下不来,说明时序余量从头到尾都很紧,设计上要么约束太狠要么结构有问题,这个数字是比任何单条路径报告都诚实的设计质量指标,值得带回综合侧复盘。
这一篇在知识体系里的位置
- 上游:时序余量从哪来见 时序收敛 ECO(sizing 与 VT swap 如何抢 setup),多 scenario 的分析口径见 PrimeTime 签核。
- 同层:换 VT 在 hold 侧的另一面见 STA hold 修复(换慢 VT 是免费延迟),swap 的 ECO 属性见 metal-only 与 spare 单元,swap 前的方案评估见 时序 ECO what-if 分析。
- 下游:功耗与压降对账见 Voltus/RedHawk 签核 与 IR 分析模式,老化余量见 老化可靠性签核,网表等价性由 Formality LEC 兜底。
总结
多 Vt 漏电优化的核心打法是两段式:先放开 LVT 把时序抢下来,post-route 寄生定型后再做 leakage recovery,在同族同驱动 footprint 兼容的硬规则下、按守护线逐路径换回 SVT/HVT,三轮累计可砍掉 30%-60% 漏电;收益要拿全角回归、LEC、功耗与 IR/aging 对账五道闸门来守——换回来的不只是功耗数字,还有温度和寿命,前提是余量账先记清。