功耗-热耦合分析:温度反馈漏电的迭代收敛方法、热点对时序与可靠性的影响及签核落地
更新时间:2026-10-05。功耗-热耦合分析是先进工艺签核里最容易「各算各的、拼起来错」的一环:功耗团队用 25°C 的库算出一个功耗图,热团队拿这个功耗图去仿真温度场,两边的输入输出只对了一轮就各自交差。问题在于温度和功耗是互相咬着的——结温每升高 10°C,亚阈值漏电大约翻 1.5 到 2 倍,漏电增加又推高功耗、进一步升温,这个正反馈不迭代到收敛,两个结果都是错的。这一篇把整条链路讲透:芯片功耗分布怎么生成、封装与系统散热怎么建模、温度-漏电迭代怎么收敛、热点对时序和可靠性各有什么影响,以及签核流程里怎么把这些账对平。读之前建议先有 SAIF 翻转率与功耗精度 的基础,可靠性侧的深入话题见 BTI 与 HCI 老化。
本文要回答的问题
- 功耗-热耦合分析到底在耦合什么,为什么单次传递(先功耗后温度)一定是错的?
- 芯片功耗分布图(power map)从哪些数据源生成,精度由什么决定?
- 封装与系统散热怎么建模成热阻网络,边界条件各代表什么物理事实?
- 温度反馈漏电的迭代收敛怎么做,收敛判据和不收敛的常见原因是什么?
- 热点对时序(温度反转效应)和可靠性(BTI、HCI、电迁移)的影响分别怎么量化签核?
一、耦合在哪里:温度与功耗的正反馈环
先把被耦合的两个量摆清楚。芯片功耗分三块:翻转功耗(switching,与翻转率和电压平方成正比)、短路功耗(internal,输入翻转过程中上下管瞬时同通)、漏电功耗(leakage,晶体管关断时的亚阈值电流加栅氧隧穿)。前两块对温度不敏感,第三块对温度极度敏感:亚阈值漏电与温度呈指数关系,工程上的经验系数是每升高 10°C 漏电乘 1.5 到 2 倍,先进工艺(7nm 以下)因为短沟道效应加重,这个系数偏上限。
反方向,温度是功耗的函数:硅片上每一点耗散的功率,经过硅衬底、导热界面材料(TIM)、封装基板、散热器一路传到环境,沿途每一层都有热阻,功率乘热阻就是温升。于是闭环形成:温度高 → 漏电大 → 功耗大 → 温度更高。在 28nm 以上时代这个环的增益小(漏电占总功耗 5% 以内,迭代一轮就收敛、甚至不迭代也行),到了 5nm/3nm,漏电占比常态 20% 到 40%,环增益大到不迭代就是系统性低估——实测案例中,单次传递算出的结温比收敛值低 8°C 到 15°C,对应漏电功耗低估 30% 以上。
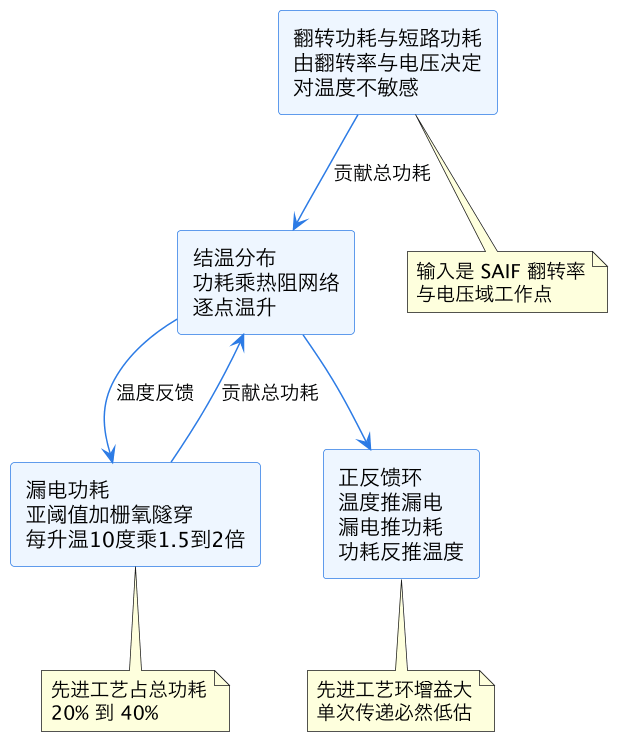
这张图是全文的核心模型:动态功耗只进不出(温度不影响它),漏电功耗和结温互相咬住。分析的任务就是把右边这个环迭代到不动点,而不是把左边的动态功耗算得多精细——动态功耗算错是输入问题,环不收敛是方法问题。
二、功耗分布图:耦合分析的输入精度
功耗-热耦合分析的第一块输入是逐区域功耗分布图(power map):把芯片划分成网格(典型 50μm 到 200μm 一格),每一格给出该区域的平均功耗密度,单位 mW/mm²。热仿真的网格粒度直接跟随它,所以功耗图的精度决定了整条链的精度上限。
功耗图有三个数据源,精度依次递升。其一是 RTL 级估算:综合后网表加 RTL 仿真导出的 SAIF 翻转率,用功耗分析工具报出各层次实例的功耗再摊到布局区域——此时还没有真实布局,摊法粗糙,只适合做架构期的热可行性判断。其二是布局后估算:placement 已定,单元位置真实,翻转率可以来自门级仿真或概率标注,精度上一个台阶,是中期热分析的主力。其三是布线后签核级:寄生参数抽完、时钟树真实、翻转率来自真实工作负载的门级仿真,功耗图连同 IR drop 分析共用同一套数据,这是最终签核口径。三个阶段的翻转率来源质量差异极大,标注覆盖率不到 90% 的 SAIF 会让功耗图整体失真,这个话题在 SAIF 翻转率与功耗精度 里有完整讨论。
还有一个容易漏的维度:工作场景。同一颗芯片在跑 CPU 满载、GPU 满载、待机漏电三个场景下的功耗图完全不同,热点位置会搬家——CPU 场景热点在大核簇,GPU 场景热点搬到图形簇,待机场景整片均匀但漏电主导。热设计必须按场景各算一套,取各场景包络,而不是只跑一个「典型」场景。
| 阶段 | 网表与布局 | 翻转率来源 | 典型用途 | 精度定位 |
|---|---|---|---|---|
| RTL 估算 | 综合网表,无布局 | RTL 仿真 SAIF | 架构期热可行性 | 定方向,误差可达 50% |
| 布局后 | placement 完成 | 门级仿真或概率标注 | 中期热分析、封装选型 | 主力口径 |
| 布线后签核 | 真实时钟树加寄生 | 真实负载门级仿真 | 最终签核、与 IR 共用数据 | 签核基准 |
三、封装与系统散热:热阻网络与边界条件
第二块输入是散热通路模型。热从晶体管结区出发,路径大致是:硅衬底 → 背面 TIM → 金属盖(lid)或直接到散热器 → 散热器 → 环境空气。工程上把它抽象成热阻网络:每一段材料用一个热阻(°C/W)表示,必要时加热容表示瞬态。结温就是环境温度加上总功耗乘以路径热阻——这个「电热类比」是整个热仿真的骨架,区别在于粗分析用集中参数(几个热阻),细分析用三维有限元网格把硅片切成几十万个体素逐格求解。
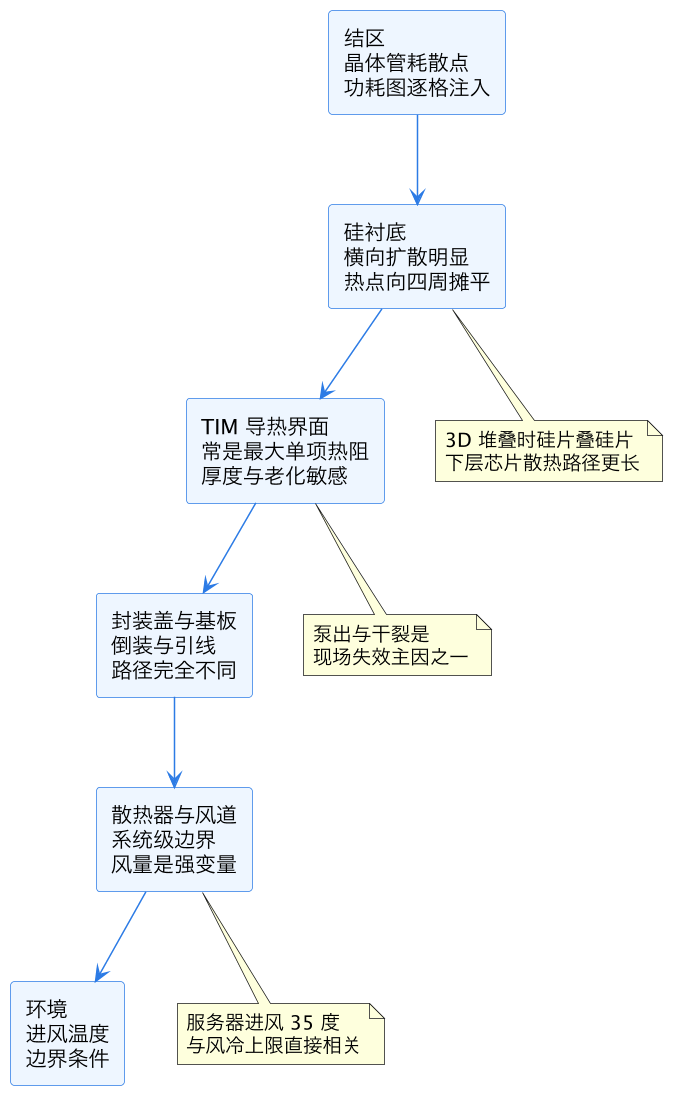
这张图是散热通路的热阻链。两个细节值得盯住。第一,硅衬底的横向热扩散是把功耗图「摊平」的过程:功耗图上一个尖锐的热点,传到盖板上已经抹开不少,所以热仿真不能只看热点正上方的纵向路径,横向扩散项是 3D 求解相对集中参数模型的主要价值。第二,3D-IC 堆叠(先进封装与 3D-IC)把热阻链变成了热阻网:下层逻辑芯片的热要穿过上层芯片或微凸点(micro-bump)阵列才能出去,层间功耗耦合让单独分析每颗 die 失去意义,必须整包联合求解——这也是功耗-热耦合分析在先进封装时代从「可选项」变成「签核必选项」的直接原因。
边界条件的设定同样决定结果。给热模型的环境温度不是室温 25°C,而是机箱进风温度(服务器典型规格 35°C,恶劣工况 45°C);散热器热阻不是 datasheet 上的理想值,要按实际风量曲线取工作点。边界条件乐观一档,结温结论就乐观一档,后面所有时序和可靠性账全部跟着偏。
四、迭代收敛:温度-漏电不动点怎么求
有了功耗图和热模型,进入本篇的核心算法:温度反馈漏电的迭代收敛。流程是一个定点迭代——先用初始温度(通常取 85°C 或标称结温)查库得到各单元的漏电功耗,加上动态功耗形成第一版功耗图;热仿真求解温度场;用新温度场逐格回查漏电功耗,更新功耗图;再热仿真,直到相邻两轮的温度场变化小于阈值(典型判据是最大格点温差小于 0.5°C,或全片平均温差小于 0.1°C)。
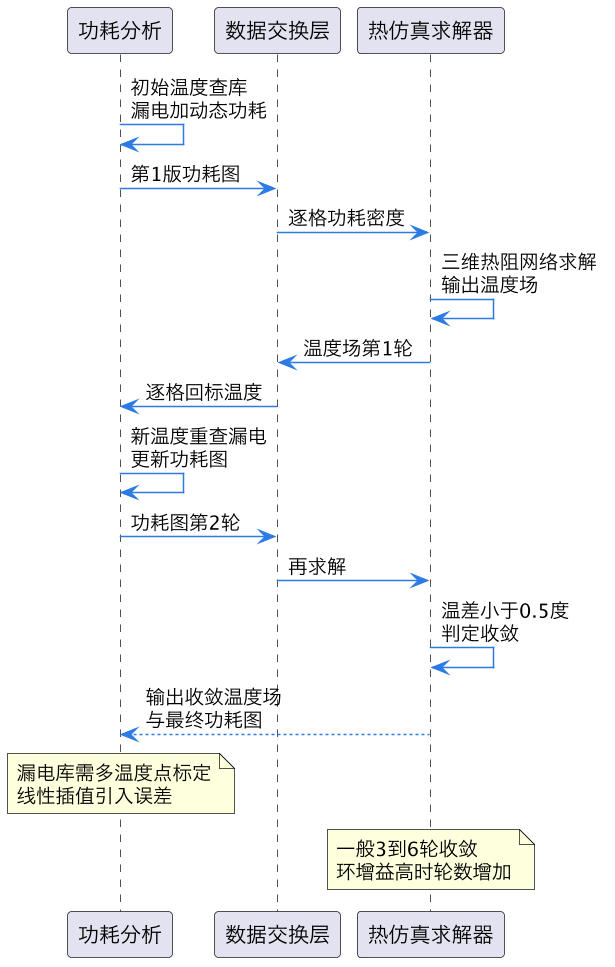
这张时序图是迭代的主循环。工程上有三个实操要点。第一,漏电模型必须有多温度点:.lib 库如果只有 25°C 和 125°C 两个角,中间靠线性插值,而漏电是指数曲线,线性插值在 60°C 到 100°C 区间系统性偏低,要求库表征至少三个温度点,或者直接用带温度项的电流方程模型(CCS/ECS M 漏电模型)。第二,收敛轮数与环增益相关:漏电占比高的设计 5 到 6 轮才稳,占比低的两三轮就够;可以用第一轮和第二轮的温差增量外推收敛值,少跑一轮热仿真(3D 有限元求解一次动辄小时级,省一轮是真金白银)。第三,不收敛的信号要认得:温度场来回振荡说明步长或数据交换有 bug;温度单调爬升不收顶说明环增益接近 1——这在物理上叫热失控边缘,真实芯片碰到这种工况(比如电压超规格加高温环境)就是设计红线,不能当成数值问题糊弄过去。
收敛之后的输出是两套数据:最终温度场(喂给时序和可靠性)和最终功耗图(喂给供电网络设计和 IR drop,见 去耦电容插入与 IR)。注意这两套数据必须是同一轮迭代的产物——温度场是第 6 轮的、功耗图还停在第 5 轮,下游账就对不平。
五、热点的下游账:时序与可靠性
热点不是热学问题,是时序问题和可靠性问题。先看时序。传统经验是「温度越高、延迟越大」,所以签核全用最高温度角。但先进工艺出现了温度反转效应(temperature inversion):低电压下(0.7V 以下),阈值电压随温度下降带来的驱动电流增益,超过迁移率随温度下降的损失,单元延迟反而随温度升高而减小。这意味着在低温低压角,热点区域的延迟可能比冷区更小,而冷区(离热点远的逻辑)反而变慢——按「全片同温」假设签核的 hold 时间,在真实温度梯度下可能不够。热感知时序签核的做法是把收敛后的温度场逐格回标到时序工具,单元按所在格点温度插值延迟(temperature-aware STA),热点周边的 setup 路径和冷区的 hold 路径各按真实温度检查。
再看可靠性,这里的账更重,因为老化机制全部是温度的强函数,而且时间尺度上以年计。电迁移(EM)的 Black 方程里电流密度的失效时间与温度呈 Arrhenius 指数关系,结温每高 10°C,金属线寿命大约腰斩;BTI(偏置温度不稳定,Negative/Positive Bias Temperature Instability)的阈值漂移同样随温度指数加速;HCI(热载流子注入)在低温下反而更凶,但高温叠加高占空比区域的总退化仍以热点为重。这些机制的建模与签核方法在 BTI 与 HCI 老化 里单独展开,本篇只强调一点:所有这些可靠性计算的输入温度,必须来自功耗-热耦合收敛后的温度场,而不是「标称结温 105°C」这种拍脑袋值——热点格点和平均温度差 15°C,对应 EM 寿命差近 3 倍,用平均温度签 EM 等于系统性放水。
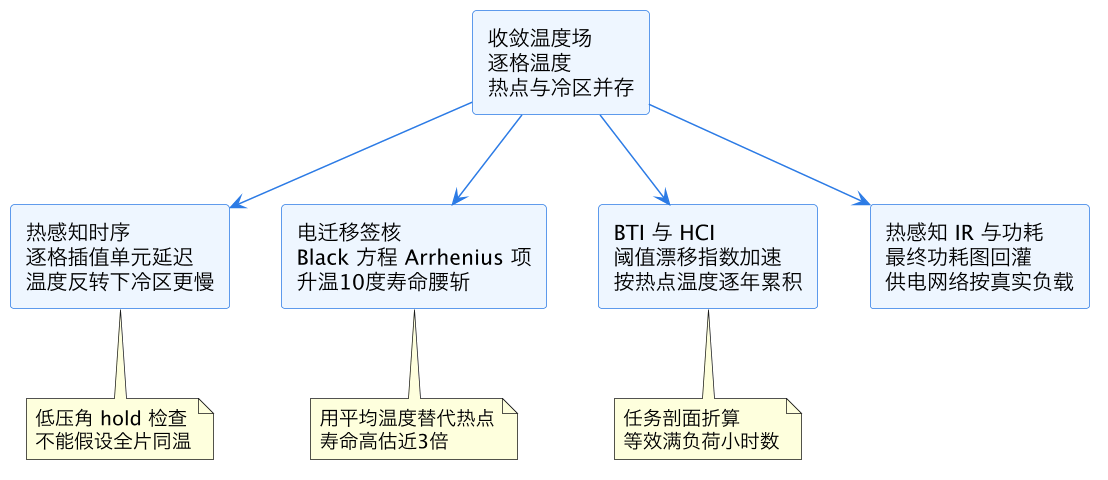
这张图是收敛温度场的四个下游消费者。核心信息是「一份温度场、四处复用」:时序、电迁移、老化、IR 各自拿同一份数据做各自的账,任何一处用了不同来源的温度(比如时序用角点温度、EM 用平均温度),签核结论之间就互相矛盾。流程上的对账方法是把温度场文件(通常是逐格 CSV 或专用格式)纳入版本管理,四份签核报告各自注明输入温度场版本号,评审时先对版本再对数据。
六、工程落地:流程集成与常见翻车
把前面所有环节串成流程,加上踩过的坑,收个尾。流程顺序是:场景定义(哪些工作负载、对应什么翻转率)→ 功耗分析出初版功耗图 → 热模型搭建(封装结构、TIM、散热边界)→ 迭代收敛 → 温度场分发到 STA、EM、老化、IR 四条签核线 → 报告对账。这个流程要按场景重复多遍,工程上通常固定跑三个场景:峰值性能场景(功耗最高,定热点与 EM)、典型应用场景(占空比最高,定老化累积)、待机场景(漏电主导,验证低温角时序)。
常见翻车模式有四个。第一,功耗图和热模型版本错位:后端 ECO 改了布局,功耗图重新出了,热仿真还跑在旧图上,热点位置整体平移而无人察觉——解法是功耗图文件带布局版本号,热仿真输入做校验。第二,边界条件乐观:用室温 25°C 而不是进风 35°C 当环境,结温结论直接低 10°C,下游 EM 寿命高一倍——评审时先问边界条件出处。第三,漏电库温度点不够,线性插值在高温段系统性低估,迭代收敛到一个偏低的假不动点——表现为收敛很快(两三轮就稳)但和硅后实测温度对不上,硅后反馈(硅后数据回灌)是抓这个问题的最终手段。第四,3D 堆叠设计里各 die 分开做热分析,层间耦合被切掉,下层 die 结温低估 10°C 到 20°C——先进封装必须整包联合求解,这条没有捷径。
这一篇在知识体系里的位置
本篇是 eda/ 目录功耗与可靠性交叉地带的一篇,处于「功耗分析」与「签核收敛」之间:上游接 SAIF 翻转率与功耗精度 的功耗图生成质量、先进封装与 3D-IC 的封装结构前提,同层与 去耦电容插入与 IR(共用最终功耗图)、corners 与 MMMC 配置(温度角的框架性安排)并列,下游落地到 BTI 与 HCI 老化 的可靠性签核、数据流 S5 签核收敛 的多线对账,以及 硅后数据回灌 的实测校准。读懂温度-漏电这条反馈环,你就明白为什么先进工艺的签核报告里「温度」从来不是一个角点数字,而是一张逐格分布的地图。
总结
功耗-热耦合分析的核心是温度与漏电功耗的正反馈环:结温每升 10°C 漏电乘 1.5 到 2 倍、漏电推高功耗又反推温度,先进工艺漏电占比 20% 到 40% 使环增益大到单次传递必然低估,必须用「功耗图 → 热阻网络求温度场 → 逐格回查漏电 → 再求解」的定点迭代收敛到最大格点温差小于 0.5°C;输入侧功耗图按 RTL、布局后、布线后三级精度递进且必须分场景出包络,散热侧封装 TIM 与 3D 堆叠层间耦合是模型关键;收敛后的同一份温度场要版本化地分发到热感知 STA(温度反转下冷区 hold 更紧)、电迁移(热点与均温差 15°C 对应寿命差 3 倍)、BTI/HCI 老化与 IR 四条签核线,任何一处用错温度来源就是系统性放水;工程翻车集中在版本错位、边界乐观、漏电库温度点不足与 3D 分 die 分析四类,最终靠硅后实测温度回灌闭环校准。