增量综合流程:小改动后增量编译的改动识别、QoR 与运行时间收益及适用边界
更新时间:2026-10-05。一次全量综合动辄几个小时到十几个小时,而 RTL 阶段晚期大多数改动只是修几行逻辑、调一条约束。增量综合流程(incremental synthesis / incremental compile)解决的就是这个问题:识别改动影响到的逻辑范围,只重跑那一小片,其余复用上次结果。本篇建立在 数据流 S2:综合交付 的全量综合语境之上,把增量这条快行道讲清楚——它怎么识别改动、能省多少时间、QoR 会不会变差,以及什么时候必须老老实实回全量。
本文要回答的问题
- 增量编译如何识别「这次改动影响了哪些逻辑」?
- 增量综合的运行时间收益和 QoR 代价分别有多大?
- 增量流程在整体迭代节奏里处于什么位置?
- 哪些改动类型会击穿增量边界,必须退回全量综合?
一、改动范围识别:从 diff 到逻辑锥
增量综合的第一步不是编译,而是回答「这次改了多少」。工具一般从两个层面识别改动。
第一层是网表级 diff:把新 RTL 快速 elaborate(细化展开,不做优化)成通用单元网表,与上一版同阶段网表做结构比对,找出新增、删除、改动的逻辑节点。这一步类似文本 diff,但比对的是逻辑结构而非源代码行号——改一个 if 条件的写法,只要展开后逻辑锥(logic cone,指某个输出端到其所有输入端之间扇入的逻辑集合)不变,就被视为无改动。
第二层是影响面扩散:改动点本身的逻辑锥要重编译,它的扇出方向也要跟进——因为下游逻辑的优化空间可能被新输入特性改变(负载、到达时间、驱动能力都变了)。扇入方向通常不用动,上游逻辑的输出特性没变。最终得到的「重编译集合」= 改动锥 + 受影响的下游锥,一般不超过全设计的 5%。
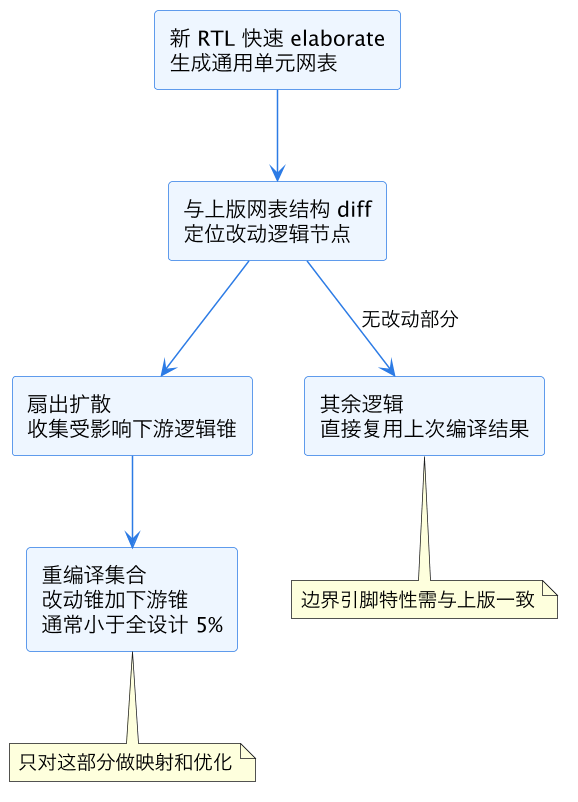
这张图的要点在分叉处:diff 之后设计被切成两块,增量编译只把算力花在左边那一小条路径上。右边复用部分有个隐含前提——它与重编译部分的边界接口(引脚到达时间、驱动单元)要保持一致,否则拼接处会出现时序不连续。主流工具的做法是把边界单元「冻结」或做有限的边界优化,这也是增量 QoR 略低于全量的原因之一。
二、运行时间与 QoR 收益
增量综合最直接的收益是时间。经验数字:改动占全设计 1% 到 5% 时,增量编译的运行时间约为全量的 20% 到 35%。一个全量要 10 小时的模块,增量常常 2 到 3 小时出结果,这意味着一天内可以多做一到两轮迭代——对 ECO 脚本化批处理流程 里那种「改 RTL、重综合、看时序」的循环,迭代密度直接翻倍。
QoR(Quality of Results,结果质量,通常指时序 WNS/TNS、面积、功耗的综合评分)方面要现实一点:增量结果通常略逊于同起点的全量重跑,典型差距是 WNS 差 1% 到 3%、面积差 1% 以内。原因是边界冻结限制了优化自由度——全量重跑时工具可以跨边界重构逻辑,增量不行。但这个差距在大多数迭代里完全可接受:增量轮的目标本来就不是追最后那点时序,而是快速验证「这个改法方向对不对」。到收敛末期,跑一次全量把边界的优化空间找回来即可。
| 维度 | 全量综合 | 增量综合 |
|---|---|---|
| 运行时间 | 基准(数小时至十几小时) | 约 20%–35% |
| WNS 差距 | 基准 | 差 1%–3% |
| 面积差距 | 基准 | 差 1% 以内 |
| 适用阶段 | 初版综合、收敛末期定稿 | 日常小改动迭代 |
| 改动占比容忍 | 任意 | 建议小于 5%–10% |
用这张表做决策很简单:改动小、要快速验证方向,走增量;改动大或者要出交付级网表,走全量。两者之间没有中间档值得纠结。
三、增量在迭代流程里的位置
增量综合不是孤立功能,它嵌在整个 ECO 节奏里。典型的日常循环是:RTL 小改 → 增量综合 → 增量布局布线(或快速 place-only 预估)→ 增量 STA → 看报告决定下一步。每一环都有增量模式,串起来才把「一轮迭代」从一天压到半天以内。约束改动同样走这条路:SDC 里调一个时钟不确定度或改一条多周期路径,通常不需要重综合,只需要增量重算时序——SDC 的生命周期管理见 数据流格式:SDC 生命周期。
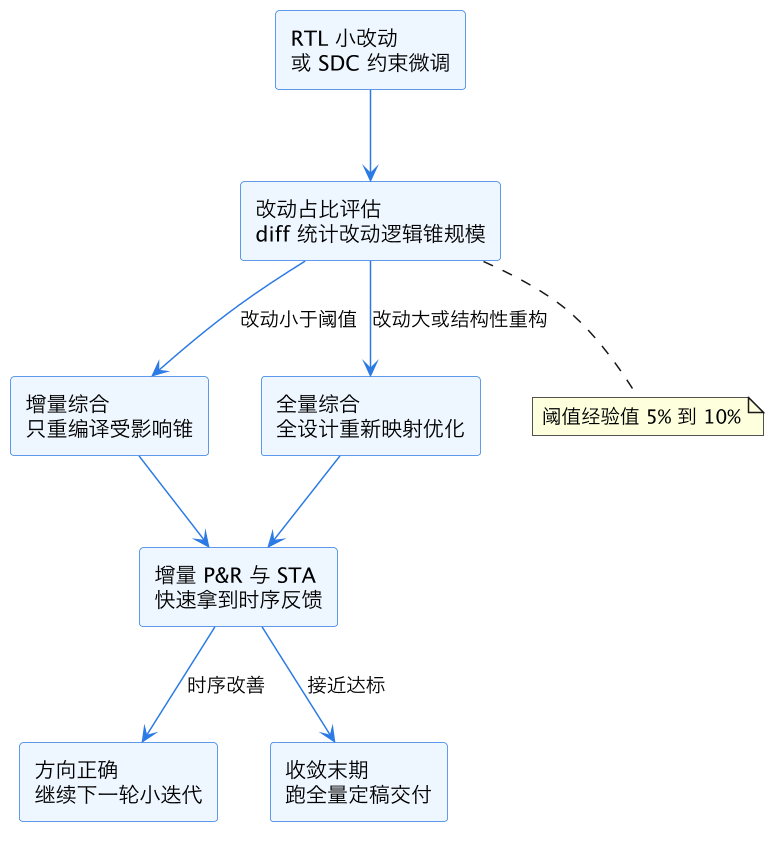
这张图的关键节点是「改动占比评估」:它是增量/全量的总闸门。评估不能凭感觉,要让工具报告 diff 统计——改动逻辑锥占全设计的百分比、涉及的关键路径条数。超过阈值硬走增量,往往跑出来的结果和全量差得离谱,反而浪费一轮。
四、适用边界:什么时候必须回全量
增量综合的边界可以归纳为四类。第一类是改动规模超标:单次改动涉及超过全设计 10% 的逻辑,重编译集合膨胀,增量省下的时间被识别和拼接开销吃掉,不如全量。第二类是结构性重构:模块拆分合并、层次边界变更、总线位宽调整——这类改动会让网表 diff 的节点对应关系大面积失效,影响面扩散几乎覆盖全设计,增量退化成全量还白付识别开销。第三类是物理感知优化需求:如果这次改动是为了配合 拥塞感知综合重构 或大幅调整 floorplan,物理信息全变了,基于旧物理假设的增量结果没有参考价值。第四类是交付与 signoff 节点:交给后端的网表、tapeout 前的最终版本,必须用全量综合产出,保证优化自由度完整、QoR 可追溯——这条是纪律,不是技术问题。批量回归场景下的取舍节奏可参考 ASIC CI/CD 回归 的做法:回归里跑增量保速度,里程碑节点跑全量保质量。
还有一个隐性边界值得单独提:增量编译依赖上一次编译的数据库快照。如果库版本(.lib / .db)、工艺角配置、工具版本任何一项变了,快照失效,只能全量。所以增量流程要求编译环境「冻结」——这和 数据流格式:PDK 版本基线 里强调的版本基线纪律是同一回事。
这一篇在知识体系里的位置
本篇属于 EDA 综合阶段的工程实践速查,向上承接 数据流 S2:综合交付 的全量综合交付口径,横向与 ECO 脚本化批处理流程、拥塞感知综合重构 互为参照,向下衔接 ECO 阶段的增量思路(见 数据流 X3:ECO 变更传播)——增量哲学贯穿全流程,综合只是第一站。
总结
增量综合流程的本质是「结构 diff 加扇出扩散」:把新 RTL 快速展开成网表与上版比对,只对改动锥和受影响下游锥重编译,其余复用快照,把运行时间压到全量的两三成,代价是边界冻结带来 1% 到 3% 的 QoR 损失。它适合改动占比 5% 以内、处于日常迭代阶段的场景;结构性重构、物理信息大变、库或工具版本变更、以及交付与 signoff 节点,必须退回全量综合。用一句话口诀记:小改验证走增量,定稿交付走全量,改多大让 diff 报告说了算。