AXI4 窄传输非对齐:lane 轮转、WSTRB 排列与拆拍规则
更新时间:2026-09-25。本文承接 AXI4 burst 类型与边界,专攻其中一笔带过的两件事:AxSIZE 窄于数据总线时字节在 lane 上怎么排,起始地址不对齐时拍怎么拆。握手细节见 VALID/READY 握手,协议骨架见 AXI4 完整协议。
本文要回答的问题
- AxSIZE 只有总线宽度的一半(比如 64 位总线上传 32 位)时,多拍数据在 lane 上怎么排?
- WSTRB 每一拍的图案由什么决定?FIXED 和 INCR 为什么不一样?
- 非对齐访问是怎么定义的?一笔非对齐传输要几拍,首拍屏蔽哪些字节?
- slave 想支持非对齐访问,接口和存储体要满足什么条件?
- RTL 里怎么从 beat 计数和地址直接算出 WSTRB?
一、窄传输:AxSIZE 窄于数据总线
先固定术语。数据总线宽度(data bus width)是 WDATA/RDATA 的位宽,单位换算成字节记为 BUS_BYTES(64 位总线即 8)。AxSIZE 描述每拍实际传输的字节数 beat_bytes = 2^AxSIZE。当 beat_bytes < BUS_BYTES 时就是窄传输(narrow transfer):一拍装不满总线,一笔 burst 必然要多拍。
关键点是 lane 的归属规则:某一拍数据放在哪些 byte lane,由这一拍的地址对总线宽度取模决定。即 lane = beat_addr % BUS_BYTES,该拍的 beat_bytes 个字节就落在 lane … lane+beat_bytes-1 上。地址随 INCR burst 推进,lane 就在总线上循环轮转。
先把三个层级的词分清楚,后面反复用到:一拍(beat)是时钟上一次 VALID/READY 成功握手;一笔传输(transfer)在协议文本里与 beat 同义;一个 burst 是共享同一组 Ax 控制信号的 AxLEN+1 拍。窄传输讨论的是「一拍内部字节怎么放」,burst 讨论的是「拍与拍之间地址怎么走」,两件事正交。
协议对 AxSIZE 还有一条硬约束:beat_bytes 不得超过 BUS_BYTES,即 AxSIZE 编码的传输不能比接口本身还宽。想传比总线宽的数据,正确做法是增加拍数,而不是放大 AxSIZE。常见组合见下表。
| 总线宽度 | 允许的典型 AxSIZE | 窄传输示例 |
|---|---|---|
| 32 位(4B) | 1、2、4B | 1B 访问寄存器,4 拍才填满总线 |
| 64 位(8B) | 1、2、4、8B | 4B 字访问,lane 高低半轮转 |
| 128 位(16B) | 1、2、4、8、16B | 8B 访问,轮转周期 2 拍 |
lane 的轮转周期也可以直接算出来:BUS_BYTES / beat_bytes 拍之后 lane 图案重复。64 位总线传 4 字节,周期 2 拍;传 1 字节,周期 8 拍。验证时 strobe 序列应当呈现这种周期性,周期提前或推后都说明地址推进有 bug。
下图是 64 位总线(8 条 lane)、AxSIZE=2(每拍 4 字节)、INCR、起始地址 0x04 的前四拍。注意 lane 从高半开始,下一拍绕回低半。
这张图纠正两个常见误解。第一,窄传输不是「数据永远放低 lane」——lane 跟着地址走,只有落在地址上的 lane 才有效。第二,主设备虽然可以把窄数据复制到所有等价 lane(协议允许的复制写法),但 WSTRB 仍必须严格按上述规则置位,slave 只认 strobe,不靠猜数据位置。
二、窄传输写波形:WSTRB 的节拍排列
把上图放到实际握手里。64 位总线,AW 通道给出 AWADDR=0x04、AWSIZE=2、AWLEN=3、AWBURST=01(INCR),共 4 拍;W 通道连续给拍,最后一拍 WLAST 拉高;全部收完后 B 通道回响应。
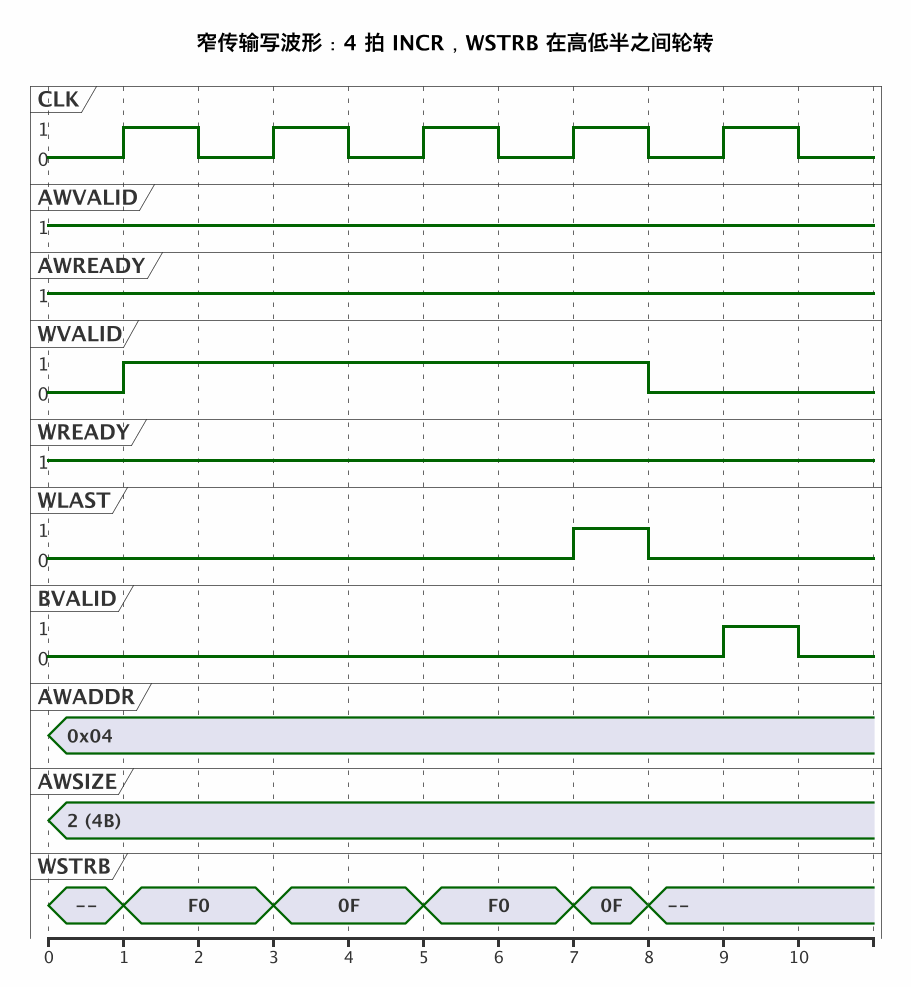
读图抓三点:AW 通道只在开头出现一次,slave 必须自己按拍推进地址并算出后续 strobe;WSTRB 依次为 F0 → 0F → F0 → 0F,与上一张 lane 图一一对应;BVALID 在 WLAST 拍之后才给出,响应顺序与 outstanding 与 ID 保序的规则一致。
FIXED burst 是个例外。 FIXED 每拍地址相同,所以窄传输时 lane 也相同:比如 64 位总线上对 0x04 做 4 字节 FIXED burst,每拍都是 lane7..4、WSTRB 恒为 F0。这正是 FIFO 访问想要的语义——每拍都写同一个端口位置。对比记忆:INCR 的 lane 轮转,FIXED 的 lane 不动。
顺带说明主设备「复制数据」的写法。协议建议主设备在窄传输时把同一份有效数据复制到总线上所有等价位置(比如 4 字节数据同时驱动到 lane3..0 和 lane7..4),这样某些只按固定 lane 取数的简单接口也能工作。但这只是宽容措施:WSTRB 仍然只在地址真正命中的 lane 上置位,合规 slave 必须按 strobe 选字节。因此复制数据改变不了 lane 排列,也不能让 strobe 变宽。验证主设备时 strobe 是硬检查,数据复制与否通常不作为判据。
三、非对齐访问:定义、拍数与首拍屏蔽
对齐(aligned)的定义:起始地址是每拍字节数的整数倍,即 AxADDR % beat_bytes == 0。不满足就是非对齐(unaligned)。注意对齐与否是相对于 AxSIZE,不是相对于总线宽度;窄传输本身完全可以是对齐的(上一节的例子起始 0x04 对 4 字节对齐,只是 lane 不在最低位)。
非对齐时,协议不增加任何握手,而是让首拍用 WSTRB(写)或 byte lane(读)屏蔽地址之前的无效字节,后续拍正常。总拍数由数据跨越的对齐窗数决定:
beats = ceil((AxADDR % BUS_BYTES + total_bytes) / beat_bytes)典型例子:32 位总线(4 lane)、AxSIZE=2、起始地址 0x01、传 6 字节。地址 1..6 跨越两个对齐窗,共 2 拍:
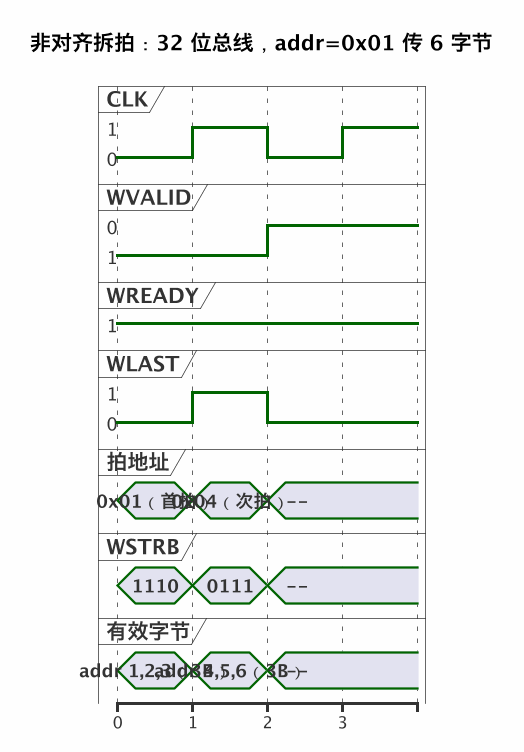
首拍 WSTRB=1110:lane0 对应地址 0x00,在请求范围之前,屏蔽;lane1..3 承载地址 1、2、3。次拍 WSTRB=0111:地址 4、5、6 落在 lane0..2,lane3 超出总长度也要屏蔽。也就是说非对齐传输的首尾两拍都可能是残拍,中间拍才是满 strobe。
再看一个窄传输与非对齐叠加的例子,把前面两张图的规则合并:64 位总线、AxSIZE=2(4B/拍)、起始地址 0x02、传 12 字节。逐拍展开如下表。
| 拍 | 拍地址 | 有效地址范围 | lane 窗口 | WSTRB |
|---|---|---|---|---|
| 0 | 0x02 | 0x02–0x03 | lane7..0 中的 2、3 | 0000_1100 |
| 1 | 0x04 | 0x04–0x07 | lane4..7 | 1111_0000 |
| 2 | 0x08 | 0x08–0x0B | lane0..3 | 0000_1111 |
| 3 | 0x0C | 0x0C–0x0D | lane4、5 | 0011_0000 |
四拍里只有中间两拍是满的 4 字节,首尾各只有 2 字节有效。这张表是 scoreboard 的标准参考模型:每拍同时受「lane 轮转窗口」和「总传输范围」两个条件约束,strobe 是两者交集。手工看波形时也按这两步走——先框 lane 窗口,再按总长度切头尾。
读侧虽然没有 RSTRB,但残拍规则同样适用。非对齐读返回时,slave 要把地址对应的字节放到正确 lane;lane 上不在请求范围的字节协议不做规定,可能是旧数据、相邻地址数据,也可能是常数。因此参考模型只能摘取 [AxADDR, AxADDR+len) 对应的 lane 比对,整字比较会产生大量假失败。
公式里用 AxADDR % BUS_BYTES 而不是 % beat_bytes,是因为窄传输下首拍数据起点按总线宽度定位;对齐与非对齐的判定仍按 beat_bytes。两个取模对象别搞混,这是初学时最容易绕进去的地方。若起始地址本身对齐,公式退化为 total_bytes / beat_bytes(向上取整),与普通 burst 完全一致——这也说明非对齐处理是对齐处理的超集,对齐只是特例。
若干边界规则要一并记住:
- 非对齐只影响 lane/strobe 排列,不改变 AxLEN——拍数仍由上述公式确定后写进 AxLEN,不能让 slave 靠 strobe 猜拍数。
- WRAP burst 的起始地址必须按突发总长对齐,因此 WRAP 不存在非对齐形式;独占访问的对齐约束见 AXI4 独占访问。
- 任何 burst 仍不得跨 4KB 边界,非对齐首拍也不例外,跨界要由 master 拆成多笔,规则见 AXI4 burst 类型与边界。
- 读通道没有 RSTRB:slave 把有效字节驱动到对应 lane,无效 lane 的内容不关心,master 按地址自行摘取。
四、slave 支持非对齐的条件
协议允许 slave 不支持非对齐——收到非对齐访问可回 SLVERR。但一个 slave 要真正支持,需要同时满足下面几个条件:
| 条件 | 原因 |
|---|---|
| 写数据通路有逐字节使能(WSTRB 进存储译码) | 残拍只写 lane 上的部分字节,不能整字覆盖 |
| 存储体按字节可写(SRAM 位写使能或读改写) | 窄传输/残拍不能破坏同字内其他字节 |
| 读数据按 lane 拼接返回 | 非对齐读的有效字节可能横跨存储字 |
| 内部能按拍推进地址并复算 lane | AW 只给一次起始地址,slave 自备节拍 |
| 对不支持的组合(如 WRAP 非对齐)回 SLVERR 而非静默 | 防止数据错位 |
典型反例是简单的 AHB/APB 风格寄存器组:内部只有 32 位整字写使能,无法按字节屏蔽,这类 slave 应声明只支持对齐访问,由软件或互连适配。Interconnect 也可以替 slave 做适配——把非对齐访问拆成若干对齐子事务、甚至做读改写合并,但这会增加延迟和缓冲,是否适配取决于具体 IP。
存储体这一条值得展开。SRAM 宏单元通常提供每字节一个的写使能(byte-write enable),这是最直接的实现:WSTRB 拍齐后直接接进宏单元。若手头的存储体只有整字写使能,接口就得退化为读改写:残拍到来时先读回原字,与新数据按 strobe 合并,再整字写回。读改写引入一拍以上的额外延迟,还要处理与其他在途写的先后关系,一般只用于配置寄存器等低带宽场景,数据通路上应坚持选字节可写的存储体。
还要区分「支持窄传输」和「支持非对齐」两个能力。窄传输只要求 slave 能按 lane 选字节,起始地址仍是对齐的;非对齐进一步要求残拍不踩坏相邻字节。一个 slave 可以支持窄传输但拒绝非对齐(对非对齐首拍回 SLVERR),集成时要查清楚接口声明,不能因为仿真里窄传输通过就默认非对齐也通。互连适配发生在 slave 之外时,slave 自身始终只看到对齐事务,这种情况下即使 slave 不支持非对齐,系统整体仍然可以支持——能力边界取决于谁在做拆拍。
窄传输与非对齐可以叠加出现:64 位总线上 32 位 AxSIZE、起始 0x02 传 8 字节,既跨 lane 又跨对齐窗,strobe 图案要同时考虑「lane 轮转」和「首尾残拍」。验证时这是必测点。
五、RTL 中 strobe 的生成
主设备侧 WSTRB 不需要逐拍手算,可以直接由 beat 计数推出。核心就三行关系:
// 参数:BUS_BYTES=总线字节数;beat_bytes=2^AWSIZE
// beat_cnt:当前拍序号(0..AWLEN)
logic [63:0] baddr;
logic [BUS_BYTES-1:0] wstrb;

baddr = AWADDR + beat_cnt * beat_bytes;          // 本拍地址
for (i = 0; i < BUS_BYTES; i++) begin
  // 落在本拍 lane 窗口内,且在总传输范围 [AWADDR, AWADDR+len) 内
  wstrb[i] = wvalid & wready
           & (i >= (baddr % BUS_BYTES))
           & (i <  (baddr % BUS_BYTES) + beat_bytes)
           & ((baddr - AWADDR + (i - (baddr % BUS_BYTES))) < total_bytes);
end
最后一个条件处理非对齐尾拍:lane 虽在窗口内,但地址已超出总长度时不置位。FIXED burst 只需把 baddr 恒等于 AWADDR,其余逻辑不变,lane 自然不动。
实现上有几个工程细节。第一,beat_cnt × beat_bytes 建议用移位和拼接完成(beat_bytes 恒为 2 的幂),避免真的例化乘法器。第二,total_bytes 要在 AW 拍锁存,strobe 全程引用这笔事务的长度,不能在 burst 中途变化。第三,地址加法位宽要覆盖到 4KB 拆 burst 的上限;主设备侧通常在更上层保证一笔 burst 不跨界,接口内只做推进和译码。
主设备侧还常犯一个错:WDATA 随 beat_cnt 节拍给出,但 WSTRB 用了另一套地址(比如软件视角的连续字节地址)直接译码。两套地址只要差一拍,数据和 strobe 就整体错位一拍,仿真表现为每拍数据都落在相邻 lane。稳妥做法是数据、地址、strobe 三者共用同一个 beat_cnt 产生,时序上天然同拍。
slave 侧还需要一套与主设备对称的地址推进逻辑:AW 拍锁存起始地址、AxSIZE、AxLEN,之后每成功接收一拍,地址加一个 beat_bytes,计数减一直至 WLAST。lane 译码与主设备完全相同,因此两端可以复用同一段组合逻辑,区别只在地址计数器的初装时刻。读侧同理:AR 拍之后 slave 按拍推进地址,把对应存储字读出、按 lane 拼回 RDATA,并在末拍置 RLAST。
slave 侧拿到 WSTRB 后转成存储体的位写使能:
for (i = 0; i < BUS_BYTES; i++)
  mem_we[i] = wfire & wstrb[i];   // wfire = wvalid & wready
下图是 slave 侧的节拍波形:beat 计数、本拍地址、strobe 三者严格同拍对齐,strobe 由组合译码产生,在 WREADY 拉低(反压)时整拍保持。反压语义见 AXI 反压与流水。
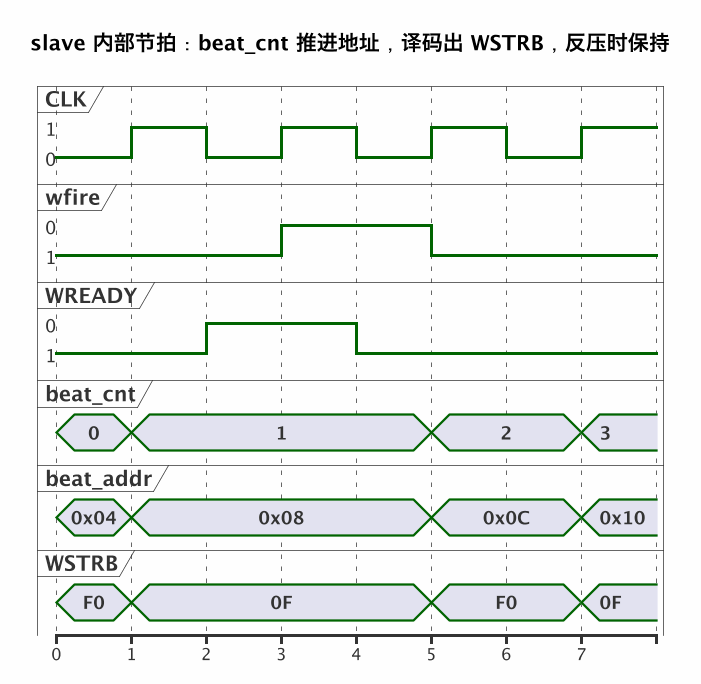
第 2、3 拍 WREADY 拉低,beat_cnt、地址和 strobe 全部冻结——slave 只在 wfire(VALID 与 READY 同时为高)时推进一拍。这是反压场景下最容易写错的地方:若用 WVALID 单端推进计数,反压期间就会丢拍或 strobe 错位。
六、验证中常见的坑
搭 testbench 时建议把 strobe 检查做成独立的参考模型组件:每收到一笔 AW,按起始地址、AxLEN、AxSIZE、AxBURST 预先生成完整的期望 strobe 队列,再逐拍与 W 通道比对。这样不用依赖 RTL 内部信号,也能同时覆盖对齐、非对齐、窄传输和反压。定向用例至少覆盖:1/2/4/8 字节四种 AxSIZE、对齐与偏移 1..beat_bytes-1 的起点、INCR 与 FIXED、burst 中途反压、以及恰好触及 4KB 边界的长 burst。
- 窄传输数据永远放低 lane:忽略地址取模,INCR 第二拍起全部错位。判据:把每拍 WSTRB 与
beat_addr % BUS_BYTES对拍检查。 - 把非对齐当对齐处理:首拍没有屏蔽低位 lane,整字写入踩坏相邻变量;尾拍漏判总长度,多写一个字节。
- FIXED 与 INCR 混淆:FIFO 窄传输用了 INCR,每拍写到不同 lane/地址;或 FIXED 时 lane 轮转。
- 反压丢拍:beat 计数用 VALID 推进而非握手成功推进,WREADY 拉低期间地址继续跑。
- slave 无字节写使能却宣称支持非对齐:残拍整字覆盖。集成前查存储体是位写使能还是读改写。
- 跨 4KB 不拆笔:非对齐 + 长 burst 最容易越过边界,scoreboard 要按页分段比对。
- 读通道假设全 lane 有效:非对齐读的无效 lane 内容无定义,检查器只能摘取地址对应 lane。
- 窄传输与非对齐混为一谈:二者正交,要分别施加激励;只测对齐窄传输或非对齐满宽传输都会漏掉叠加场景。
排查 strobe 问题有个实用顺序:先 dump AW 拍的四个控制信号确认配置,再逐拍列出 beat_addr % BUS_BYTES 的理论 lane 窗口,最后与波形上的 WSTRB 逐位对齐。错位方向也有规律——整体差固定拍数多半是地址推进或反压问题,首尾残拍异常则多半是总长度边界问题。按这个顺序定位,几分钟就能把问题归到具体逻辑。
这一篇在知识体系里的位置
地址推进与 4KB 规则见 AXI4 burst 类型与边界;协议信号骨架见 AXI4 完整协议;多笔并发见 outstanding 与 ID 保序;反压与流水插拍见 AXI register slice;DMA 侧对齐组织见 DMA burst 对齐与 cache。
总结
窄传输时 lane 由 beat_addr % BUS_BYTES 决定、随 INCR 轮转(FIXED 不动),WSTRB 逐拍只点中该拍的 beat_bytes 个字节;非对齐访问不增加握手,靠首尾拍 WSTRB/lane 屏蔽越界字节,拍数由跨越的对齐窗数决定;slave 必须有逐字节写使能和按拍地址推进才算支持,RTL 中 strobe 由 beat 计数加地址译码、只在 VALID/READY 同时有效时推进。