推理基准测试:vllm bench 与 genai-perf 口径差异、warmup 与稳态测量的可复现纪律
更新时间:2026-10-04。前面 LLM serving 的 TTFT/TPOT/SLO 定义了指标——首 token 延迟、逐 token 延迟、怎么换算成 SLO;batch 延迟吞吐曲线 讲了负载-延迟-吞吐三者怎么互相挤压。指标定义清楚了、曲线形状知道了,剩下的问题是:这些数字到底怎么测出来才算数? 同一个引擎、同一张卡,vllm bench 跑出 3200 tok/s、genai-perf 跑出 2400 tok/s,两个数都「对」,差的就是口径。推理基准测试(LLM inference benchmark)这个领域最大的陷阱不是工具不好用,而是口径差异常被当成性能差异对外传播。本篇把主流压测工具的口径差异拆开,给出一份能写进 runbook 的可复现测量纪律。
本文要回答的问题
- 为什么同一套系统,vllm bench 和 genai-perf 测出的吞吐能差 30%?
- 请求到达分布(固定并发 vs 泊松到达)为什么比引擎差异更能左右结果?
- 输入/输出长度的选取怎么悄悄改变 TTFT 和 TPOT 的相对权重?
- warmup 多久算够、稳态窗口怎么划,截断指标(goodput)怎么算?
- 一份「可复现」的 benchmark 报告必须记录哪些元数据?
一、先立靶子:一次测量到底在测什么
一次推理压测,本质上是四样东西的组合:一个负载发生器(按某种规律发请求)、一个被测系统(推理引擎 + 模型 + 硬件)、一个指标采集器(记录每个请求的时间戳)、一套口径定义(从原始时间戳算出报告数字)。大部分「数字对不上」的事故,出在第一样和第四样。
上图中两个黄色块是「口径重灾区」。负载发生器决定系统被压到什么状态——是排队论意义上的开放系统(请求按速率到达,可能堆积),还是闭环系统(固定 N 个客户端,一个回一个发,永不堆积)。口径定义决定原始时间戳被怎么折算——P50 还是 P99、包不包括排队时间、输出长度按请求数还是按 token 数归一。工具之间的真正差异,九成在这两处。
先把四个基础时间戳定义清楚,后面所有口径讨论都建立在它们之上:
| 时间戳 | 含义 | 派生指标 |
|---|---|---|
| t0 | 请求发出 | — |
| t1 | 收到首 token | TTFT = t1 - t0 |
| t2 | 收到末 token | E2E 延迟 = t2 - t0 |
| — | 输出 token 数 n | TPOT = (t2 - t1) / (n - 1) |
注意 TTFT 里混着三段时间:网络往返、队列等待(请求在调度器里排队等进 batch)、prefill 计算。大多数工具报的是端到端 TTFT(含排队),这正是 TTFT/TPOT/SLO 那篇 强调的「用户视角口径」——但在比较引擎内核效率时,你可能想要的是不含排队的纯 prefill 时间。口径不声明,这两个数混在一起,结论就会打架。
二、负载发生器:闭环并发和开放到达是两个世界
vllm bench(vllm bench serve,前身 benchmark_serving.py)和 NVIDIA genai-perf 最根本的分歧在请求怎么发。
vllm bench 的默认模式是开放系统:按指定 QPS(request rate)从泊松过程(Poisson process,到达间隔服从指数分布)采样发请求,--max-concurrency 只是一个上限闸。它也能退化成突发模式:--request-rate inf 时所有请求一拥而上。genai-perf 的默认模式是闭环并发:固定 N 个并发槽位,一个请求完成立刻补一个,等价于恒定压力。genai-perf 也支持开放模式(指定 QPS 或泊松到达),但社区报告里用它时多半是并发扫频(concurrency sweep)。
这两种模式测的不是同一个量。闭环 N 并发下,系统永远不会「过载崩溃」——队列长度被并发数天然封顶,你测到的是「系统在该压力下的均衡点」。开放 QPS 模式下,只要到达速率超过服务能力,队列无限增长,延迟爆炸,你测到的是「系统在崩溃边缘的 SLO 可达边界」。用闭环 64 并发测出的 TPOT,和用 8 QPS 开放到达测出的 TPOT,没有可比性——前者的瞬时 batch 恒定在 64 附近,后者的瞬时 batch 随泊松起伏、平均可能在 30 上下。
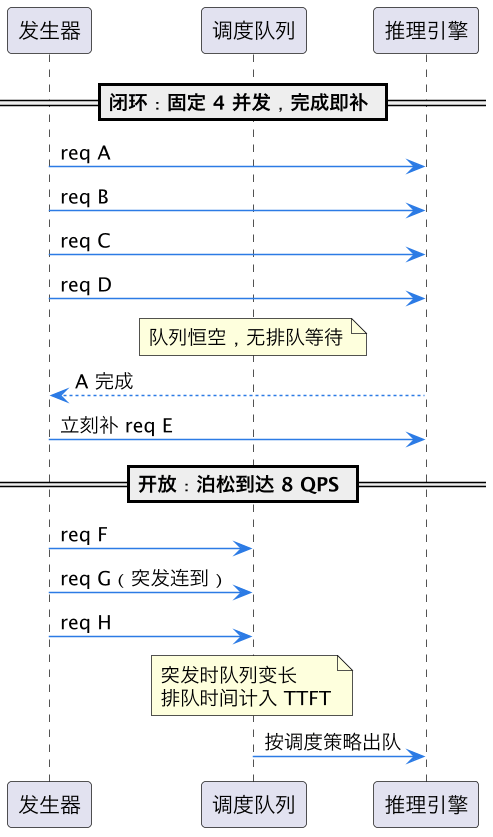
图中下半段就是开放模式的要害:泊松到达的方差让「平均 8 QPS」在秒级窗口里常常表现成 15 QPS 的瞬时冲击。一次诚实的容量评估必须用开放模式,因为真实流量就是开放的;而引擎之间的「同压力内核效率对比」用闭环反而更干净——它把调度变量固定住,只留计算差异。两种模式都要跑,但报告里必须大字标明用的是哪种。
三、输入输出长度:被低估的第一公民
第二个口径雷区是长度。vllm bench 用 --random-input-len / --random-output-len(或 ShareGPT 数据集的自然分布),genai-perf 用 --synthetic-input-tokens-mean / --output-tokens-mean,都支持均值加标准差。看起来差不多,坑在三个地方。
其一,定长 vs 分布。vllm bench 的 random 数据集默认给每条请求完全相同的输入长度(除非显式指定 range),genai-perf 默认按正态分布抖动。定长负载下所有请求几乎同时完成 prefill、同步进入 decode,batch 构成异常整齐,TPOT 会偏乐观;带抖动的分布里长短请求混排,continuous batching(见 continuous batching 调度器)的插队、换入换出都被触发,数字更贴近线上也通常更难看。
其二,ISL/OSL 组合决定测的是哪段曲线。输入 3500 token、输出 150 token 是典型的 RAG 摘要负载,TTFT 权重高、prefill 是瓶颈;输入 100、输出 2000 是长文生成负载,TPOT 和 decode 显存带宽是瓶颈。拿 ISL 3500 的吞吐数字去回答一个聊天产品的容量问题,等于用短跑成绩报马拉松。选型时至少要覆盖「真实线上分布」加「两个极端角点」三组长度。
其三,输出长度的截断语义。--ignore-eos 是否开启差别巨大:不开时模型可能提前吐 EOS,实际输出远短于设定值,吞吐虚高;开了则强制生成满长度。比较两份报告前先对齐这个开关。
| 口径维度 | vllm bench serve | genai-perf | 对结果的影响 |
|---|---|---|---|
| 默认到达模式 | 开放(泊松 QPS) | 闭环(固定并发) | 队列行为完全不同 |
| 输入长度 | random 定长 / ShareGPT 分布 | 合成正态分布 | 定长偏乐观 |
| 输出控制 | --ignore-eos 可选 | 类似开关 | 不开则吞吐虚高 |
| TTFT 口径 | 端到端含排队 | 端到端含排队 | 一致,但都非纯 prefill |
| 流式要求 | 必须流式才测得到 TTFT/TPOT | 同左 | 非流式模式只有 E2E |
| goodput | 原生 --goodput 支持 | 需自行后处理 | SLO 达标吞吐 |
四、warmup 与稳态:曲线前半段全是噪声
即使发生器、长度全部对齐,测量窗口选错照样翻车。一个推理服务从冷启动到稳态,中间至少有三个预热阶段,每个都会污染数据。
第一阶段是编译与图捕获预热:CUDA graph 捕获、torch.compile 或 TensorRT 引擎的 autotune,头几个 batch 尺寸第一次出现时慢得离谱(秒级)。vLLM 启动时的 precompile 只覆盖它枚举的 batch 档位,运行时出现没见过的 batch 形状仍会触发即时编译。第二阶段是缓存与内存池预热:KV cache 池(见 KV cache 推理显存)的分页分配器、prefix cache 的 radix tree,都要跑一阵才进入稳定复用状态。第三阶段是负载本身的爬坡:从 0 并发爬到目标 QPS,瞬时 batch 在涨,TPOT 自然在降——这段不是稳态。
经验值:warmup 至少跑到「目标负载下 3-5 分钟,或累计 500 个请求以上,两者取大」,然后用滑动窗口验证稳态——把 TPOT 按每分钟聚合,连续三个窗口均值波动小于 5% 才算进入稳态,之前的数据全部丢弃。genai-perf 的 --warmup-request-count 和 vllm bench 的 ramp-up 思路都是在处理这个问题,但默认值经常不够。

上图划分了五个阶段,只有阶段 4 的数字有资格进报告。两个实操细节:其一,压测时长别太短,10 分钟以下的稳态窗口几乎必然漏掉周期性扰动(比如后台的 KV cache 整理、NCCL 心跳重传);其二,报告要附上完整的逐分钟吞吐曲线,而不只是一个均值——均值可以掩盖双峰(系统在两个 batch 档位间震荡),曲线藏不住。
五、从原始数据到报告数字:goodput 与截断口径
拿到稳态窗口的逐请求时间戳后,最后一步是聚合。这里还有三个口径要说死。
吞吐的分母。output token throughput(输出吞吐,tok/s)有两种算法:总输出 token 数除以墙钟时间(含爬坡和尾部),或除以稳态窗口时间。前者系统性偏低。同样,「per-request 吞吐」(单请求视角的 decode 速度)和「aggregate 吞吐」(整机总产出)是两个量,容量规划用后者,用户体验看前者。
分位数而不是均值。TTFT 和 TPOT 都呈长尾分布,均值会被少数超快请求拉低。报告至少给 P50/P90/P99 三档;P99 之外建议再看 max,max 经常暴露 preemption(请求被换出重算)这种均值看不见的灾难。
goodput(达标吞吐)。这是近几年最重要的口径进步:不再问「系统能跑多快」,而是问「在 TTFT < 2s 且 TPOT < 100ms 的 SLO 约束下,系统能扛多少 QPS」。做法是按 QPS 梯度做开放模式扫频,每个点位统计达标请求占比,取达标率 ≥ 90%(或 99%)的最高 QPS。vllm bench 的 --goodput ttft:2000 tpot:100 直接支持这个口径。goodput 把延迟和吞吐拧成了一个数,是唯一能直接回答「要买几张卡」的指标。

上图的扫描流程其实就是 batch 延迟吞吐曲线 里那条「膝盖曲线」的实测版:拐点之前加负载只涨吞吐不涨延迟,拐点之后队列开始堆积、TTFT 以排队时间形式爆炸。goodput 就是把拐点的横坐标量化出来。
六、可复现纪律:一份报告的最小元数据清单
把前面所有坑合起来,一份能被别人复现(也能被三个月后的自己复现)的推理基准测试报告,必须钉死以下元数据。缺任何一项,数字都只能当轶事看。
| 类别 | 必须记录的字段 |
|---|---|
| 系统 | 引擎及精确版本 commit、模型及权重格式(FP8/AWQ 等)、GPU 型号与数量、并行策略(TP/PP/EP) |
| 负载 | 到达模式(开放 QPS / 闭环并发)及参数、ISL/OSL 均值与分布、ignore_eos 与否、数据集来源 |
| 窗口 | warmup 时长与判定方法、稳态窗口起止、总请求数 |
| 口径 | 吞吐分母、是否含排队、分位数档位、SLO 阈值(goodput 时) |
| 环境 | 驱动与 CUDA 版本、NUMA/频率锁定、是否独占机器、同时段有无其他负载 |
最后三条纪律,来自真实翻车现场。第一,原始数据落盘:所有请求的 t0/t1/t2 和长度存 CSV/JSON,报告只放聚合值——任何「再换一个口径看看」的需求都不该重跑压测。genai-perf 的 profile_export.json 和 vllm bench 的 --save-result 都支持,默认打开。第二,至少三次重复:同配置跑三轮,报均值加离散度;GPU 频率、邻居租户、NCCL 拓扑探测都会带来 5% 级波动,单轮数字没有统计意义。第三,对照组同炉测:比较两个引擎或两个版本时,必须在同一时段、同一台机器、同一负载脚本下交替跑(A-B-A-B),隔夜的「之前测过一次」不作数——机器状态漂移比引擎差异还大是常有的事。如果三轮交替结果的方向一致、幅度稳定在噪声之外,结论才算站得住;方向都摆动的对比,宁可报「测不出差异」,也别挑最好看的那轮写进报告。
这一篇在知识体系里的位置
本篇是 LLM serving 观测线的方法论地基:上游是 LLM serving 的 TTFT/TPOT/SLO(指标定义——本篇测的就是那几个数)和 batch 延迟吞吐曲线(负载-延迟关系——goodput 扫频的理论骨架);同层对照 continuous batching 调度器(被测系统内部的调度行为,决定开放/闭环口径差异为何这么大)、KV cache 推理显存(稳态预热要等的那个资源池)、LLM 推理可观测性栈(压测之外线上持续盯同一批指标)、vLLM V1 调度器设计 与 TensorRT-LLM inflight batching(做引擎对比时的对照双方);下游延伸是 LLM serving 成本模型 TCO(goodput 换成钱的最后一步)。
落地顺序建议:先按 SLO 定 goodput 口径,再设计覆盖真实分布与极端角点的负载,然后钉死 warmup 与稳态窗口,最后把元数据清单做成压测脚本的强制参数——口径代码化,而不是靠人记。
总结
推理基准测试的可靠性九成在口径不在工具:vllm bench 默认开放泊松到达、genai-perf 默认闭环并发,两者测的根本是不同系统状态;长度分布、ignore_eos、warmup 是否覆盖编译/缓存/爬坡三段、吞吐分母取不取稳态窗,每一项都能让数字差出几十个百分点——可复现的纪律只有三条:用开放模式 goodput 扫频回答容量问题、用闭环并发对比引擎内核、把到达模式/长度分布/窗口口径/环境版本全部钉进报告并留存逐请求原始数据,缺一项的数字都不要拿去做决策。