STA hold 修复:setup 收敛后的最后一道时序硬关
GBA 与 PBA 分析模式讲过 setup/hold 违例是怎么被报出来的,Derate 与 POCV讲过悲观度怎么加;但报告里那几千条 hold violation 最终要靠物理手段一条条修掉——这就是本篇的主题。STA hold 修复不是「插几个 buffer」一句话的事:修早了会被后续优化冲掉,修错了会把刚收敛的 setup 打破,修狠了功耗和面积双双超标。本篇按工程实战顺序讲:为什么 hold 必须排在 setup 之后修、修复手段的优先级怎么排、buffer 和 inverter 对怎么选、LVT/HVT 在这场戏里各演什么角色,以及修完之后的回归纪律。
本文要回答的问题
- hold 违例的物理本质是什么?为什么它不像 setup 那样可以靠「降频」蒙混过关?
- 为什么工程上铁律是「先 setup 后 hold」?反过来修会怎样?
- 修 hold 的手段有哪些?从调时钟树到插 buffer,优先级顺序怎么排?
- buffer 和 inverter 对(inverter pair)做延迟填充各有什么优劣?VT 类别(LVT/SVT/HVT)怎么选?
- 修完 hold 之后要做哪些回归,才能确认 setup、DRC、功耗没有被回马枪打翻?
一、hold 违例的物理本质:数据跑得太快
setup 检查问的是「数据能不能在一个周期内赶到」;hold 检查问的是相反的问题——「数据会不会跑得太快,把上一个周期的旧数据提前冲掉」。触发器的 hold 时间要求:时钟沿到来之后,D 端数据必须再稳定保持一小段时间(先进节点典型值 20-60ps)。如果发射触发器的时钟到得早、数据路径又特别短,新数据就会在捕获触发器还「没抓稳旧数据」的时候冲到 D 端,功能直接出错。
关键区别在于:hold 违例与工作频率无关。setup 过不了可以降频(周期拉长,数据就有更多时间到达),而 hold 检查的两个时钟沿是同一个沿(或相隔零周期的沿),周期再长也救不了。这意味着 hold 违例是「流片即废片」级别的硬问题——芯片回来跑任何频率都是错的。所以 signoff 阶段 hold 必须清到零,一条不剩,这是 PrimeTime/Tempus 签核的底线。
hold slack 的计算式可以简化记成:数据路径延迟(发射时钟延迟 + 触发器 clk→q + 组合逻辑延迟)减去捕获时钟延迟,再减去 hold 时间要求,结果必须大于零。注意这里每个量都取「让数据更快」的那个角——所以 hold 的最坏角通常是 ff 工艺角 + 低压高温(先进节点温度反转,见 SPEF 寄生提取)+ cbest 寄生角,和 setup 最坏角几乎处处相反。这决定了修 hold 的天然矛盾:你加的任何延迟,都在往 setup 最害怕的方向走。
二、铁律:先 setup,后 hold
几乎所有 P&R 流程(Innovus、ICC2 以及 时序收敛 ECO)都把 hold 修复安排在 setup 基本收敛之后,这不是习惯,是因果关系决定的:
- setup 修复会缩短数据路径:换更大的驱动单元、逻辑重组、插 pipeline——这些操作都会让路径变快,把原本不违例的 hold 变成违例。先修 hold 再修 setup,等于白修一遍还得返工。
- hold 修复会拉长数据路径:插延迟单元、换慢速 VT——这些操作消耗 setup 余量。setup 没收敛时插一堆 hold buffer,setup 修复又得绕开这些新障碍,迭代永远收不了尾。
- 时钟树还没定型前修 hold 是浪费:CTS(时钟树综合,见 CTS 时钟树)阶段的 skew 调整会整体改变发射/捕获时钟延迟差,post-CTS 之前报出来的 hold 违例一大半是假的。
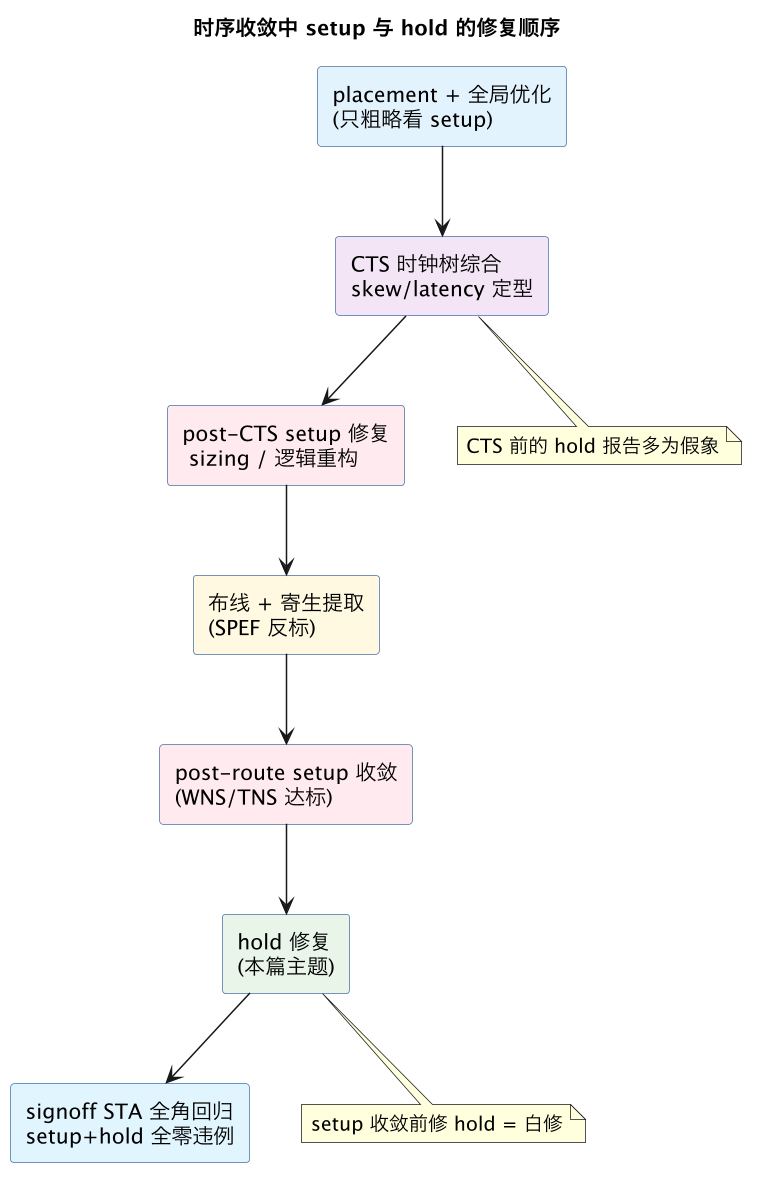
这张流程图里最值得记住的是 hold 修复的位置:它在 post-route setup 收敛之后、signoff 回归之前,是时序物理修改的「最后一刀」。位置上它是收尾工序,但工作量未必小——短路径密集的设计(比如寄存器堆、移位链、扫描链)hold 违例动辄几千条,修复插入的单元数量可能占设计总面积的 2%-5%。
三、hold 修复手段的优先级:从「不花钱」到「花大钱」
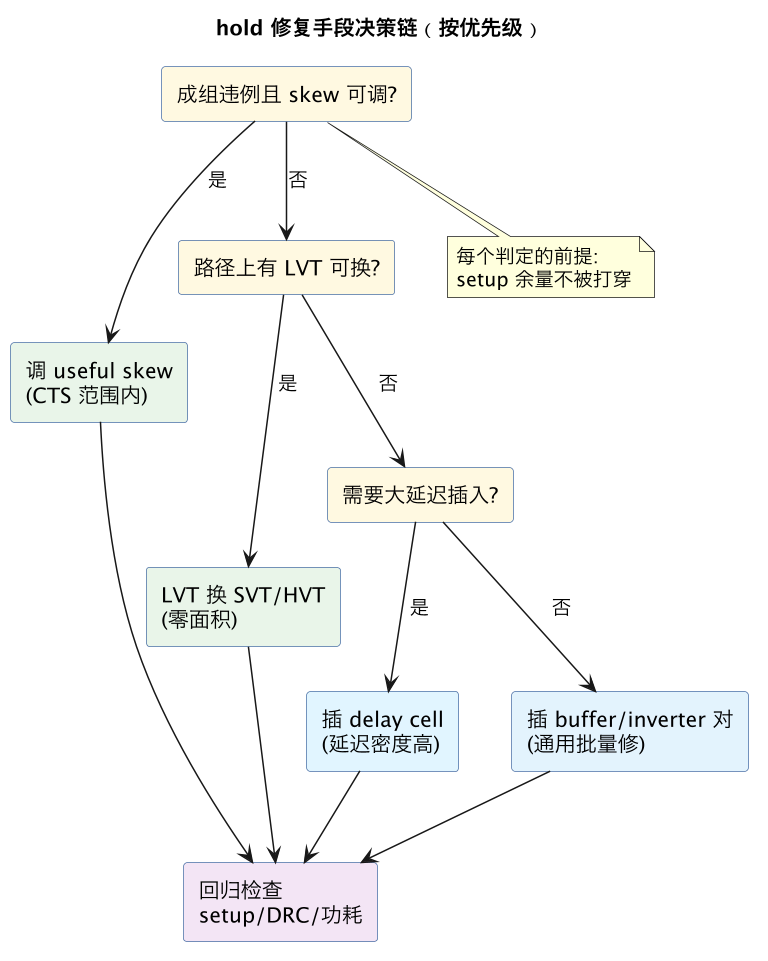
修 hold 的本质是给数据路径加延迟,但「在哪加、用什么加」代价差别巨大。工程上的优先级从高到低排:
| 优先级 | 手段 | 代价 | 适用场景 |
|---|---|---|---|
| 1 | 调时钟树 skew(useful skew) | 零面积,只动时钟 | 发射时钟太晚、捕获时钟太早的成组违例 |
| 2 | 换慢速 VT(LVT→SVT→HVT) | 零面积,功耗反而降 | 路径上已有 LVT 单元,且 setup 余量够 |
| 3 | 插专用延迟单元(delay cell) | 面积小,延迟密度高 | 需要加几十到几百 ps 的局部违例 |
| 4 | 插 buffer / inverter 对 | 面积中等,延迟灵活 | 大批量通用修复 |
| 5 | 换小驱动 / 降 sizing | 零新面积但削弱驱动 | 配合前面手段微调 |
第一优先级的 useful skew 常被忽视。hold slack = 数据延迟 − 时钟延迟差,把发射触发器的时钟推迟、或把捕获触发器的时钟提前,slack 就凭空变正了,不用在数据路径上加任何东西。代价是它把压力转嫁给了相邻路径的 setup——推迟发射时钟意味着这条路径的 setup 时间变少。所以 useful skew 只在「这条路径 setup 余量厚、相邻级 hold 紧」的场景用,且必须由 CTS 工具在时钟树范围内做,不能手动乱改。
第二优先级换 VT 是性价比之王:把路径上的 LVT 单元换成 SVT 甚至 HVT,延迟上升 15%-40% 不等,面积不变、漏电还降了。限制同样来自 setup——只有 setup 余量足够的路径才换得起。这也是为什么综合阶段被反复告诫「不要一上来全用 LVT」:LVT 用光了,hold 修复阶段手里就没有换 VT 这张牌了。
四、buffer、inverter 对与 delay cell:延迟填充三件套
当换 VT 和 skew 都不够用时,就得真往网表里加单元了。三种可插的东西行为完全不同:
Buffer(缓冲器):两级反相器串联,输入输出同相,插在哪里逻辑都不变,是最通用的延迟填充单元。一个中驱动 buffer 在先进节点大约提供 15-40ps 延迟(视负载而定)。缺点明显:延迟密度低(两级管子换来这点延迟),而且 buffer 对输入斜率敏感,插在斜率差的 net 上延迟会飘。
Inverter 对(inverter pair):两个反相器背对背,逻辑上同样等效直通,延迟和 buffer 相当,但有一个独特优势——可以把两个反相器拆开放。数据路径中间有一根长线时,把一个 inverter 放线头、另一个放线尾,长线的 RC 延迟也被「顺便利用」起来,等效白赚一段延迟。代价是物理实现麻烦(两个单元的位置要配对管理),P&R 工具的自动 hold 修复默认不这么干,需要脚本化 ECO。
Delay cell(专用延迟单元):标准单元库里专门提供的「就是为了慢」的单元,内部用弱驱动管子加容性负载堆延迟,单级能提供 50-200ps,延迟密度是 buffer 的 3-5 倍。大批量修 hold 时面积账差很多:同样加 1ns 延迟,buffer 方案可能要 40 个单元,delay cell 只要 8 个。代价是 delay cell 延迟的 PVT 散布大(弱管子对角和电压敏感),在 hold 最坏角下它的延迟也会缩水——POCV 建模里 delay cell 的 sigma 往往比普通 buffer 大 20% 以上,签核时会吃掉一部分你名义上加进去的延迟。
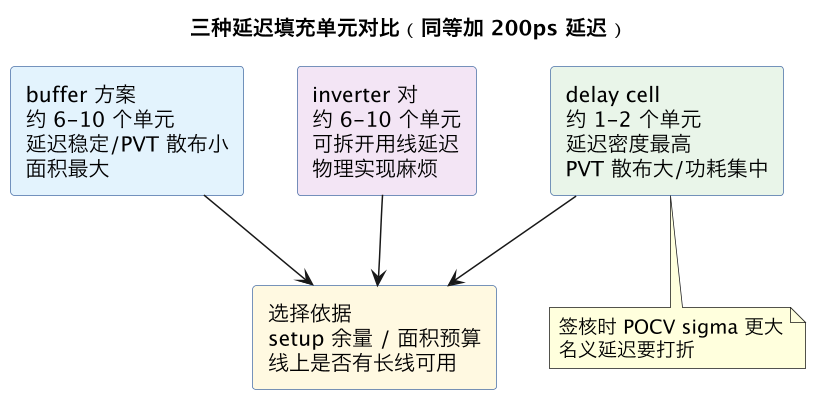
工程经验数字:一个百万实例级模块修 hold,典型插入量是全设计的 1%-3% 单元数;其中 delay cell 占大头时面积增长可压到 1% 以内,纯 buffer 方案可能到 3%。修之前先跑一次「仅换 VT」的 dry run 看能消掉多少违例——经常 30%-50% 的违例在这一步就没了,剩下才轮到插单元。
五、VT 类别的另一面:hold 修复里的 LVT/HVT 博弈
VT(阈值电压)类别是 hold 修复里贯穿始终的暗线。三个基本事实:
- HVT 单元慢、漏电低:同样的逻辑门,HVT 比 SVT 慢约 15%-25%,比 LVT 慢 30%-40%。修 hold 时「慢」正是我们要的——换 HVT 是免费的延迟。
- LVT 是 hold 的重灾区:setup 收敛阶段为了救关键路径,LVT 往往被集中用在路径末端,而这些路径的很多分支恰恰短,于是一个 LVT 单元既在救一条 setup 长路径,又在制造三条 hold 短路径。修 hold 时优先排查 LVT 密度高的区域。
- VT 替换不改变 footprint:同族单元(比如 BUF_X2 的 LVT/SVT/HVT 版)版图尺寸完全相同,互换不需要重新布局布线,是最干净的 ECO 操作,见 metal-only 与 spare 单元的互换纪律。
这里有个反直觉的坑:hold 最坏角下 VT 差距会缩小。低温(如果它是你的 hold 角之一)抬高所有单元的 VT,LVT 和 HVT 的延迟比值变小;温度反转节点的高温 ff 角下,HVT 的「慢」反而更显著。所以换 VT 的收益必须在所有 hold 角下分别验证,不能只看一个角——某个角下换 HVT 修了 100ps,另一个角可能只修了 40ps,那条路径在第二个角仍然违例。
多 VT 库混用时的工程配比也有讲究。常见的健康比例是 LVT 占比控制在 5%-15%:超过这个数,hold 修复量和漏电都会失控;低于这个数又说明 setup 收敛潜力没榨干。hold 修复结束时顺手出一份 VT 分布报告,LVT 占比异常高的模块通常是下一轮迭代里逻辑结构有问题的信号,值得回到综合侧追查。
六、修完之后:回归纪律与回马枪防御
hold 修复动了数据路径,必须证明四件事没被打破:
- setup 全角回归:每一条被插了延迟的路径,其 setup slack 要在所有 setup 角下重算。工具的 hold 修复器有 max transition / setup margin 保护参数(比如只允许吃掉 setup 余量的 50%),但保护参数不是保险丝——回归必须跑全,不能只跑修复时用的那个角。
- max transition / max capacitance DRC:插进去的 buffer 如果驱动不够、或者放在了长线中段,可能引入新的电学 DRC 违例。修 hold 引入 transition 违例是常见翻车,尤其 delay cell 驱动能力弱,后面挂的负载必须先检查。
- 功耗增量:几万个新单元的动态功耗加漏电,典型增量 1%-3%,功耗预算紧张的设计要跟 Voltus/RedHawk IR 签核对一遍账——新单元集中在某个区域时还会造成局部 IR drop 热点。
- 时钟路径不被误伤:hold 修复只能动数据路径。工具的 dont_touch 清单里时钟网络必须齐全,曾经出过修复器把 clock gating 单元的使能端当数据路径插 buffer、结果引入新 hold 违例的事故(使能路径本身是半周期检查,更脆弱)。
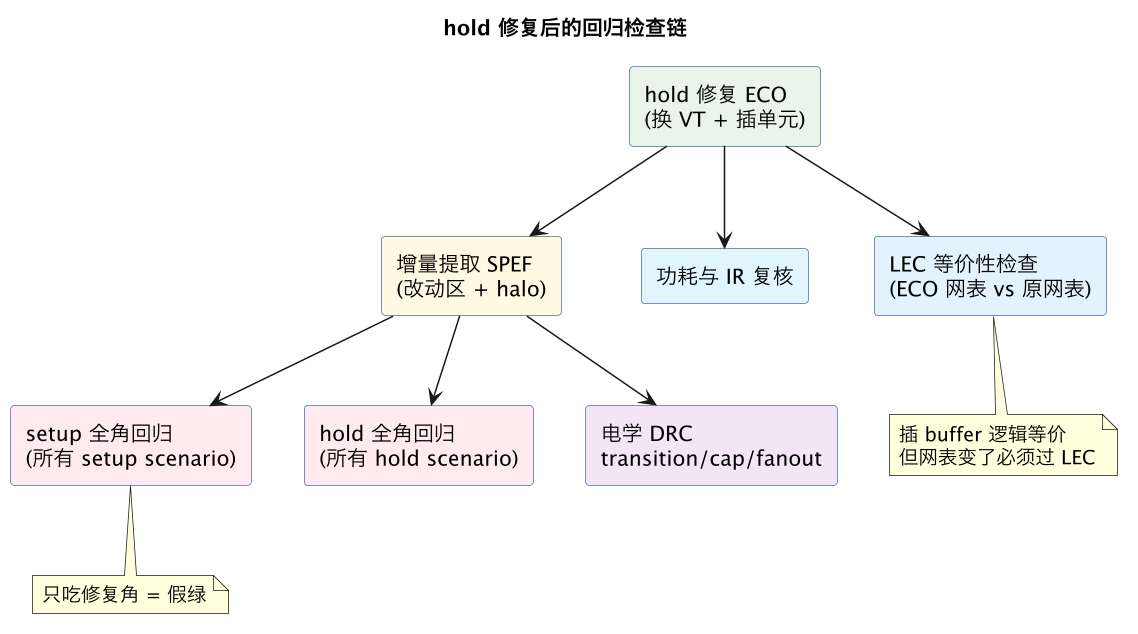
最后一项 LEC(逻辑等价检查,见 Formality LEC)容易被省略:插 buffer 逻辑上当然等价,但 ECO 过程中手工脚本出错(接错 net、层级拼错)并不罕见,LEC 是唯一能兜住「修时序把功能改坏」这类低级但致命错误的网。整个回归链走完,才能进入 签核收敛的下一轮迭代。
还有两个实战细节值得记下。先说一个数量级直觉:先进节点上一次典型的 post-route hold 修复轮次,违例端点数从几百到上万不等,修复器平均每修一条端点插入 1-3 个单元,整轮 ECO 的网表改动量常常超过布线阶段的任何一次优化——这也是为什么 hold 修复必须留足运行时间窗口(大设计一次全角修复加回归要跑到以天计),临近流片才发现成片 hold 违例的项目基本都死在排期上而不是技术上。其一,修 hold 的单元放置位置有讲究:插在靠近发射端还是捕获端,setup 影响不同——靠近捕获端插入,延迟只加在被检查的那一段;靠近发射端插入会同时影响所有扇出路径。工具的自动修复默认偏向捕获端,手工 ECO 时要想清楚。其二,扫描链(scan chain)是 hold 修复的第一大户:扫描模式下寄存器直接首尾相连,中间零组合逻辑,hold 天然紧张。DFT 工具在插扫描链时通常已经按物理邻近排序(见 Tessent ATPG),如果你的设计扫描链 hold 违例成片,先查链排序而不是盲目插 buffer。
这一篇在知识体系里的位置
- 上游:hold 违例的分析口径见 GBA 与 PBA 分析模式(为什么 PBA 下违例更少)、Derate 与 POCV(悲观度怎么吃掉你加的延迟)、时钟延迟与 skew(hold slack 的另一半变量)。
- 同层:寄生数据来自 SPEF 寄生提取(hold 角为什么是 cbest 加温度反转);修复所在的迭代框架见 时序收敛 ECO 与 签核收敛 ECO;时钟侧手段见 CTS 时钟树。
- 下游:修完之后的网表变更走 X3 ECO 变更传导 与 netlist 交接与门级仿真,功能等价性由 Formality LEC 兜底,功耗账由 Voltus/RedHawk 复核。
总结
STA hold 修复的本质是在不打穿 setup 余量的前提下给过快的数据路径补延迟:铁律是先收敛 setup 再修 hold,手段按「调 skew → 换慢 VT → 插 delay cell → 插 buffer/inverter 对」的代价顺序出招,修完后 setup 全角回归、电学 DRC、功耗与 LEC 四道闸一道都不能省——hold 修好了不算完,四道闸全绿才算收工。