FPGA 进阶 11:流水线与资源优化——扇出、关键路径与资源-速度权衡
本文是
fpga/进阶层第 15 篇。时序收敛方法 讲的是「WNS 负了怎么用工具策略和流程救」,这篇往设计层走一步,系统讲 RTL 层面**「快」(流水线/关键路径)和「省」(资源)这对矛盾**的原理与取舍。配合 DSP48、BRAM 的资源推断一起看。
本文要回答的问题
- 什么决定了 FPGA 的最高频率?关键路径是什么?
- 流水线为什么能提速?latency 和 throughput 差在哪?
- 高扇出为什么拖慢时序、怎么治?
- LUT/FF/BRAM/DSP 各被什么占用,怎么省?
- 「面积换速度 / 速度换面积」怎么决策?
一、关键路径:频率的天花板
同步电路最高频率由**关键路径(critical path)**决定——两个寄存器之间延迟最大的那条组合路径。时钟周期必须 ≥ 关键路径延迟 + 寄存器建立时间 + 时钟歪斜,否则数据赶不到(STA)。
关键路径通常来自:
- 大算术:宽加法/比较/乘法的长进位链;
- 大 MUX:宽
case/多层if-else优先级逻辑; - 高扇出信号:一个使能/状态广播到成百上千负载,布线绕远(Net Delay 大);
- 跨模块长路径:数据源和目的逻辑布得远。
report_timing 最坏路径就是关键路径,优化它最直接提 fmax。
二、流水线:插寄存器切短关键路径
在长组合逻辑中间插寄存器,把「一个周期走 N 级 LUT」切成「两段、每段半周期」:
// 流水前:一条长路径(y = (a+b)*c 后再比较,单周期)
wire [17:0] s = a + b;
wire [35:0] p = s * c;
always @(posedge clk) y <= (p > threshold);   // 关键路径:加→乘→比较

// 流水后:切两级,每周期都能进新数据
always @(posedge clk) begin
    s_r   <= a + b;          // 第 1 级
    th_r  <= threshold;      // 并行信号一起打拍对齐
end
always @(posedge clk) begin
    p_r   <= s_r * c;        // 第 2 级(乘法进 DSP)
end
always @(posedge clk) begin
    y     <= (p_r > th_r);   // 第 3 级
end
latency vs throughput:
- 打拍后单个数据走完全程要多几拍(latency ↑);
- 但每一级同时处理不同数据,理想情况每周期吞/吐一个新样本(throughput = 1 sample/cycle,最高);
- DSP/网络/视频应用通常要吞吐、不在乎几拍延迟。
打拍最有效的位置:大 MUX 之后、长进位链(加法/比较/乘法)中段、跨模块边界。注意:
- 所有并行路径要打相同拍数对齐(上面
threshold跟着打拍); - 有反压的数据通路用 Skid Buffer(valid/ready);
- 反馈回路无法简单流水:下一拍依赖当前结果(IIR、累加反馈),环路延迟决定频率,要靠算法变换或多周期;
- 切到满足目标频率即可,打太碎收益归零还增 FF/布线。
retiming 让工具自动在组合逻辑间搬寄存器平衡每级延迟(见 #06),零 RTL 改动、适合分布不均的路径;但要增加流水级仍需手动打拍。
三、高扇出:Net Delay 的元凶
一个信号带几百~几千负载(复位、使能、状态机状态、广播 valid),布线成大网、skew 和延迟大。治法:
- 逻辑复制:
(* MAX_FANOUT = 200 *) reg enable;让工具复制多份、各带一部分负载; - 精简作用域:复位只给必要寄存器(复位策略);
- 走全局网络:时钟/复位让工具推上 BUFG;
- 用时钟使能代替门控、把宽广播拆成局部使能。
四、资源优化:让硬核干活、别浪费通用逻辑
| 资源 | 被什么浪费 | 优化手段 |
|---|---|---|
| LUT | LUT 搭乘法、大存储用 FF、宽位宽、重复运算 | 乘法→DSP、存储→BRAM、位宽收窄、资源共享 |
| FF | 无必要打拍、大计数器/移位 | 移位用 SRL/BRAM、流水线适度 |
| BRAM | 小数组占整块、位宽过宽 | 小存储用分布式 RAM、位宽按带宽选 |
| DSP | 乘法没用上 / 位宽过宽拆多个 | 有符号 signed、位宽匹配、输出打拍 |
核心手段:
- 资源共享/时分复用:同一时刻只用一个的运算器,用 mux 分时复用——一个乘法器轮流算多路(代价是多周期、要调度),省 DSP/LUT;
- 位宽收窄:用够的最小位宽、有符号
signed、别默认 32 位; - 状态机编码:状态多用独热码(one-hot,次态逻辑简单、省 LUT、跑得快)、状态极少用二进制;
- 避免意外锁存器:
if要有else、case补default、组合逻辑所有分支赋值;
五、面积换速度 vs 速度换面积
FPGA 设计的核心权衡:
| 方向 | 做法 | 收益 | 代价 | 何时用 |
|---|---|---|---|---|
| 面积换速度 | 多复制处理单元、深流水、展开循环并行 | fmax/吞吐↑ | LUT/DSP/BRAM↑ | 高速数据通路、器件余量足 |
| 速度换面积 | 时分复用、串行、降并行、多周期运算 | 资源↓、能塞小器件 | 吞吐↓、延迟↑ | 资源吃紧、带宽要求不高 |
决策依据:目标频率/带宽、器件利用率(>70~80% 时序难收敛,必须省资源给布线留余量)、延迟容忍度。
六、优化顺序建议
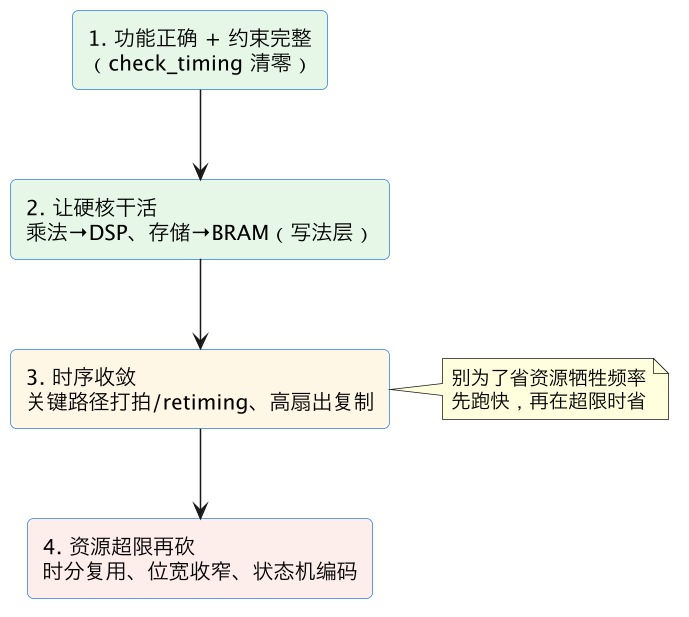
经验:先让工具用对资源(DSP/BRAM)→ 时序收敛 → 利用率超限时才按「换实现资源→时分复用→位宽收窄」顺序砍。一上来过早优化面积,容易把结构写死、后面提频困难。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| 一条长组合逻辑不打拍 | fmax 被关键路径卡死 | 在大 MUX/进位链/跨模块处插寄存器 |
| 打拍不打齐并行信号 | 数据错位 | 所有并行路径打相同拍数 |
| 反馈环硬流水 | 数据依赖、没法插拍 | 算法变换/多周期/接受环延迟 |
| 高扇出使能不复制 | Net Delay 大、时序差 | MAX_FANOUT 复制 |
| 乘法/存储用 LUT/FF | 资源爆、频率低 | 推断 DSP/BRAM |
| 位宽默认 32 位 | 浪费资源 | 用够的最小位宽、signed |
| 组合分支不补全 | 意外锁存器 | if 带 else、case 带 default |
| 过早面积优化 | 结构写死、提频难 | 先跑快再按顺序省资源 |
相关与延伸
前置/配套:时序收敛方法(工具策略/流程)、静态时序分析(关键路径怎么读)、DSP48、BRAM、复位策略(高扇出复位)。 资源优化实战见规划 #48、时序收敛实战案例见 #47、RTL 复用参数化见 #40。
一句话总结
最高频率由关键路径(最长寄存器间组合路径)决定,优化它最提 fmax:在长进位链/大 MUX/跨模块边界插寄存器流水把长路径切短——虽然 latency 增加,但每级并行处理不同数据、throughput 提到 1 sample/cycle,打拍要对齐并行信号、反馈回路无法简单流水(下拍依赖本拍),切到满足目标频率即可别打太碎;高扇出网(复位/使能/广播状态)是 Net Delay 元凶,用 MAX_FANOUT 复制 + 走全局网络治。资源上记住「让硬核干活」:乘法给 DSP、大存储给 BRAM/URAM、小缓冲用分布式 RAM/FF,再配合时分复用资源共享、位宽收窄、one-hot 状态机、补全组合分支防锁存。核心权衡是面积换速度(并行/流水提吞吐、费资源)与速度换面积(复用/串行省资源、降吞吐),按目标带宽和利用率(>70~80% 必须省资源给布线留余量)决策;优化顺序:功能对+约束全 → 写法让 DSP/BRAM 落地 → 时序收敛 → 超限再砍资源,别过早面积优化把结构写死。