虚序列句柄复用:virtual sequence 跨 test 复用时的 sequencer 句柄绑定模式
更新时间:2026-10-08。虚序列句柄复用是 UVM 环境从「一个 test 一种激励」走向「激励库跨 test 复用」时第一个撞上的工程问题:virtual sequence 自己不产生事务,它只是编排多个子 agent 的 sequence,所以它必须拿到各子 sequencer 的句柄才能 start。句柄拿错——拿到 null、拿错实例、在错误的时机拿——轻则仿真报空句柄崩溃,重则激励悄悄发到了错误的 agent 上,波形看着在跑、实际验了个寂寞。这一篇讲清三种主流绑定模式、各自的失效场景和调试入口。virtual sequence 的启动机制本身见 UVM virtual sequence 的 start 之旅,多 agent 协调的宏观视角见 virtual sequencer 多 agent 协调。
本文要回答的问题
- virtual sequence 为什么不能像普通 sequence 那样直接跑?句柄到底缺在哪?
- 跨 test 复用时,sequencer 句柄有哪三种绑定模式,各自怎么写?
- 「句柄为 null」的崩溃现场怎么按图索骥定位到绑定环节?
- 垂直复用(block 到 subsystem)时句柄绑定要做哪些改动?
- 三种模式混用时,有没有一条公共的编码纪律能少踩八成的坑?
一、为什么 virtual sequence 天然缺句柄
普通 sequence 跑在某个具体 sequencer 上,start(sqr) 调用一进来,UVM 就把 m_sequencer 设好,sequence 体内 start_item/finish_item 都走这条暗线。virtual sequence 的定位不同:它是「编排者」,职责是按顺序、按并发关系拉起若干个子 sequence,让它们分别跑到 axi_sequencer、apb_sequencer、int_sequencer 等不同的执行者上。编排者自己不挂执行者——UVM 允许 virtual sequence start(null),也允许挂在 virtual sequencer 上,但无论哪种,子 sequencer 句柄都得 sequence 自己想办法拿到。
这就是虚序列句柄复用问题的本质:句柄不是框架自动给的,是环境搭好后由人接线的。同一个 virtual sequence 在 test_A 里跑得好好的,搬到 test_B 就崩,九成是 test_B 的 env 结构变了(agent 实例名不同、某 agent 被配置成 passive、层级多包了一层),而 sequence 里的句柄获取路径还按 test_A 的结构写死。复用的所有技巧,归结起来就是一句话:让句柄获取路径与具体 env 结构解耦。
先补一个容易混淆的点:virtual sequence 和普通 sequence 一样都是从 uvm_sequence 派生,框架并不区分「虚」与「实」——「虚」纯粹是使用方式上的约定(不发送 item、只编排子 sequence)。因此也就没有任何框架机制替它准备子 sequencer 句柄,uvm_do_on 宏展开后用的就是你传进去的那个句柄实参,是 null 就在 item 发送到 sequencer 的接口调用上炸开。理解了这一点,三种绑定模式就可以统一看成「在 start 之前把句柄实参准备到位」的三种时序安排:build 阶段准备(config_db)、connect 阶段准备(vseqr 成员)、start 前一刻准备(成员赋值),区别只在准备的时机与责任人。
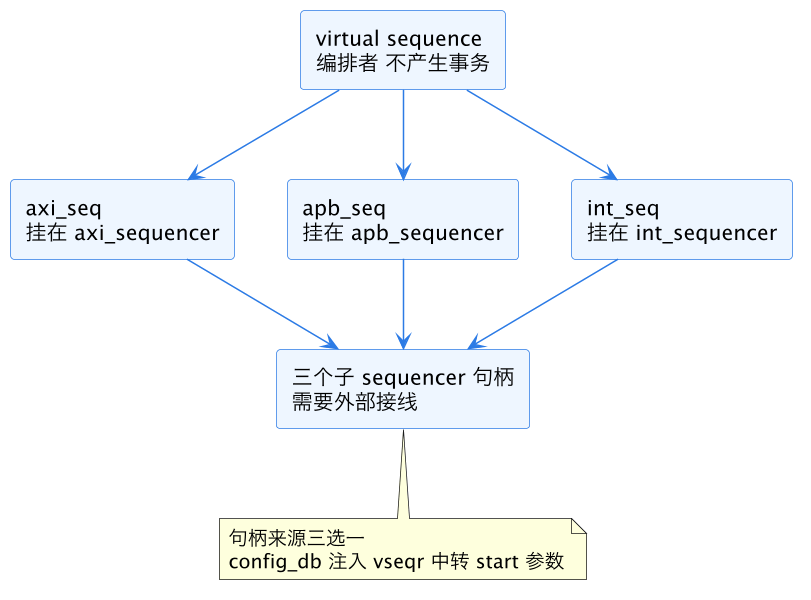
上图把问题结构画清楚了:virtual sequence 站在编排层,三条出边各指向一个子 sequence,而每条子 sequence 都要落到一个具体 sequencer 上——「落到哪」这个信息不在 sequence 内部,必须由外部接线进来。下文三种模式就是三种接线走法,差异集中在接线的时机、责任人和与 env 结构的耦合方式这三个维度上。
二、模式一:config_db 注入,test 在 build 阶段摆好资源
第一种模式把句柄当成配置资源:test 在 build_phase 拿到 env 里各 agent 的 sequencer 句柄,用 uvm_config_db#(uvm_sequencer_base)::set 摆进资源库;virtual sequence 在 body 开头用 get 取出来。写法的典型骨架:
// test 侧:build_phase 里摆句柄
function void my_test::build_phase(uvm_phase phase);
  super.build_phase(phase);
  uvm_config_db#(uvm_sequencer_base)::set(this, "env.axi_agt", "sqr", env.axi_agt.sequencer);
endfunction

// virtual sequence 侧:body 开头取
task my_vseq::body();
  uvm_sequencer_base axi_sqr;
  if (!uvm_config_db#(uvm_sequencer_base)::get(get_sequencer(), "", "sqr", axi_sqr))
    `uvm_fatal("VSEQ/NOHDL", "axi sequencer handle not configured")
  ...
endtask
这个模式的好处是绑定发生在 build 阶段,比 run 阶段早一整段——句柄缺失在仿真起跑前就以 uvm_fatal 形式暴露,而不是跑到 body 中途才崩。代价是 test 侧要逐 agent 写 set,agent 一多就是一片样板代码;而且 set 的 inst_name 必须对准 test 自己的层级路径,env 改名、加壳就要同步改。config_db 常见的取不到值排查路径见 config_db 拿到 null 句柄调试。
还有两个细节决定这个模式在复用场景下稳不稳。其一是 get 的上下文:上面骨架里 get 的第一个实参写 get_sequencer(),意思是沿着 sequence 所挂执行者的组件层级向上找资源;如果 virtual sequence 是 start(null) 裸跑的,这个上下文是 null,get 的作用域就退化成全局,set 侧写的 "env.axi_agt" 实例路径就匹配不上。裸跑场景下更稳的写法是用 uvm_root::get() 或干脆在 set/get 两侧都用 null 上下文加全路径通配。其二是类型宽度:uvm_sequencer_base 是基类,set 侧塞的是参数化后的具体 sequencer 类型,UVM 的 config_db 按精确类型匹配,set 用具体类型、get 用基类类型是取不到的——两侧必须都用 uvm_sequencer_base(或都用同一个具体类型),这是复用搬运时最容易被静默改坏的一处。
三、模式二:virtual sequencer 中转,p_sequencer 直达子句柄
第二种模式是让 virtual sequence 老老实实地 start 在 virtual sequencer 上,virtual sequencer 作为 env 的成员在 connect_phase 里持有各子 sequencer 的句柄,sequence 体内通过 $cast(p_sequencer, m_sequencer) 拿到这个中转站,再访问 p_sequencer.axi_sqr 这样的成员。m_sequencer 与 p_sequencer 的分工细节见 m_sequencer 与 p_sequencer 之别,这里只讲对复用关键的两点。
第一,绑定时机挪到了 connect_phase,由 env 一次接好,test 不再参与——同一个 virtual sequence 在任何 test 里启动,句柄接线都一样,这正是跨 test 复用最想要的性质。第二,sequence 代码与具体 sequencer 类型耦合在 $cast 那一行:cast 失败说明 start 时挂错了执行者(比如直接 vseq.start(null),m_sequencer 是 null,cast 出来 p_sequencer 也是 null),这是该模式唯一的崩溃高发点。
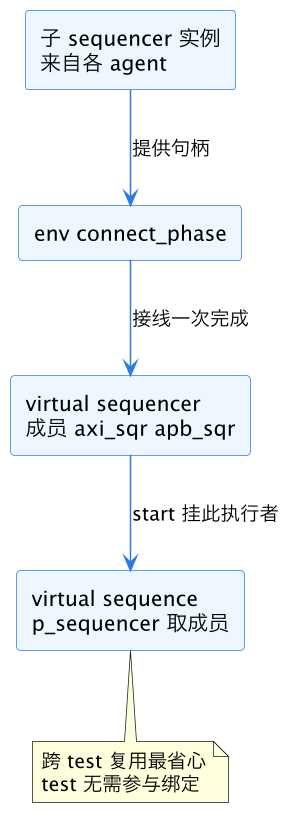
上图的核心信息是「接线一次完成」:connect_phase 把子 sequencer 句柄焊进 virtual sequencer 的成员里,之后无论哪个 test 拉起这条 virtual sequence,走 $cast 取的都是同一份接线。模式二因此是大多数环境模板(含 vendor 提供的环境)的默认选择。
四、模式三:start 参数或句柄直传,sequence 自己声明需要什么
第三种模式最显式:virtual sequence 把需要的子 sequencer 句柄声明成自己的成员,由调用方(test 或上层 sequence)在 start 之前逐个赋值:
class my_vseq extends uvm_sequence;
  uvm_sequencer_base axi_sqr, apb_sqr;
  task body();
    if (axi_sqr == null || apb_sqr == null)
      `uvm_fatal("VSEQ/NOHDL", "sub-sequencer handle not assigned before start")
    `uvm_do_on(axi_wr_seq, axi_sqr)
    `uvm_do_on(apb_cfg_seq, apb_sqr)
  endtask
endclass

// 调用侧
my_vseq vseq = my_vseq::type_id::create("vseq");
vseq.axi_sqr = env.axi_agt.sequencer;
vseq.apb_sqr = env.apb_agt.sequencer;
vseq.start(null);
这种模式把依赖写成了类的公开接口——读 sequence 代码第一行就知道它需要哪些句柄,不依赖 config_db 的作用域约定、也不依赖 virtual sequencer 的存在,单元级调试时甚至可以给它塞 mock sequencer。代价是调用侧每次都手写赋值,忘了赋就要靠 body 开头的 null 检查兜底(这个检查一定要写,别省,否则崩溃点在 uvm_do_on 深处,报文完全不提是谁的句柄空)。sequence 嵌套叠层时上层把句柄继续往下传的写法见 sequence 分层堆叠。
模式三还有一个变体值得一提:把句柄塞进 sequence 的构造函数或一个 init(axi_sqr, apb_sqr) 方法,而不是裸成员赋值。变体的好处是调用点少一次「先 create 再赋值」的两步操作,漏赋直接编译不过(构造函数参数个数不符)而不是运行时才崩;坏处是 UVM 的 factory create 约定构造函数只收 name 参数,句柄参数走不了 factory override——要用 factory 覆盖激励行为的团队就别用这个变体,退回裸成员赋值。这个取舍在 IP 级激励库交付时很现实:交付方希望依赖显式、接收方希望保留 override 能力,通常的折中是保留裸成员加 null 检查,把「必须赋哪些句柄」写进交付文档的接口清单。
五、三种模式对照与选型
| 维度 | config_db 注入 | virtual sequencer 中转 | start 参数直传 |
|---|---|---|---|
| 绑定时机 | build_phase | connect_phase | start 调用前一刻 |
| test 是否参与 | 是,逐 agent set | 否,env 内自闭环 | 是,逐个赋值 |
| 失效暴露点 | body 开头 get 失败 | cast 后 p_sequencer 为 null | null 检查(若写了) |
| 对 env 结构耦合 | 路径字符串耦合 | 成员名耦合 | 无框架内耦合 |
| 适用场景 | 老环境改造、test 差异大 | 标准 env 模板默认 | 激励库、IP 级复用交付 |
选型上一条经验法则:环境内复用用模式二,交付出去的激励库用模式三,历史包袱重的老环境用模式一过渡。真实项目里三种混用很常见——比如 virtual sequencer 中转做主链路,个别可裁剪的 agent 用 config_db 按 test 覆盖,判断标准是「这条句柄是否会随 test 变化」:会变就放 test 侧(模式一或三),不变就焊死在 env(模式二)。
还有一个跨模式的公共纪律:无论用哪种绑定,virtual sequence 拿到句柄后的第一件事是判空并给出带上下文的报错。报错信息里至少写清三件事——哪个子 sequencer、当前 sequence 名字、用的是哪种绑定来源——回归几十上百个 test 同时跑时,一条「axi_sqr is null in my_vseq, bound via vseqr member」能让定位从半小时缩到三十秒。别嫌啰嗦,句柄绑定是跨文件协作的暗线,暗线断的时候报错就是唯一的路标。
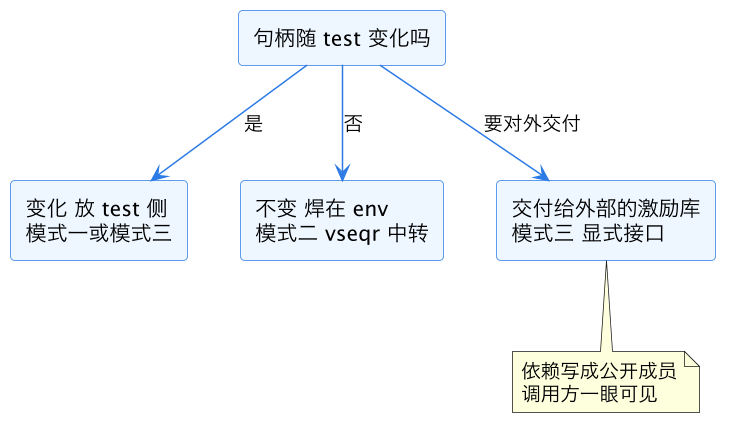
上图把选型收敛成一个判断:句柄绑定信息会不会随 test 变、sequence 要不要跨团队交付。两个维度一叠,三种模式各归其位,不存在「哪种最优」的绝对答案。
六、垂直复用时句柄绑定的改动点
block 级验证通过的 virtual sequence 搬到 subsystem 级,是虚序列句柄复用最真实的压力测试。三个高频改动点。其一,实例变多:subsystem 里同型 agent 有多个实例,原来一个 axi_sqr 变成数组或按 ID 索引的句柄表,模式二的成员声明要改成 uvm_sequencer_base axi_sqr[string] 这类关联数组,sequence 里按场景名取。其二,层级变深:模式一的路径字符串全部失效,建议趁机切到模式二或三,不要在更深的路径上继续打补丁。其三,passive agent:复用后某些 agent 被切成 passive,sequencer 根本不存在——sequence 取句柄前要先判 agent 的 is_active,passive 分支里跳过对应子 sequence 而不是崩掉。env 垂直水平复用的整体框架见 UVM env 垂直与水平复用,agent 主被动切换机制见 UVM agent active 与 passive。
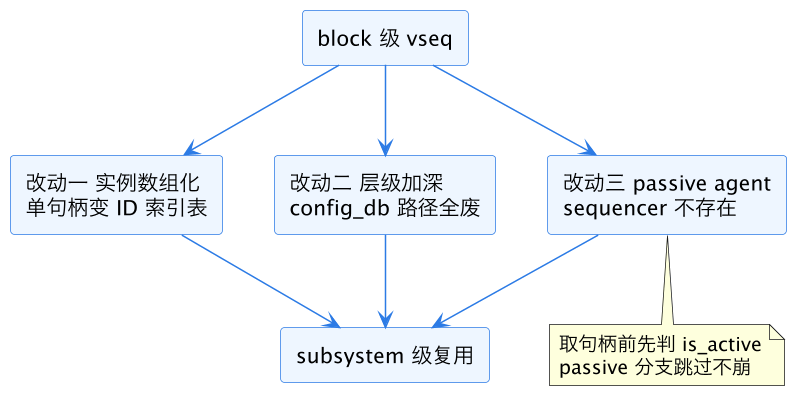
上图三条改动线汇到同一个终点:subsystem 级复用能不能平滑落地,取决于当初 block 级写 vseq 时有没有给这三件事留余地——句柄获取集中在一个 init 函数里、不硬编码实例数、对 passive 分支有判空。反过来说,这三个约束也是 block 级阶段就该守的编码纪律。
实例数组化这一条值得再展开半步:句柄表用关联数组后,键名(比如 "axi_mst0"、"axi_mst1")最好直接复用 env 里 agent 的实例名,而不是 sequence 自定义的一套别名。复用实例名的好处是报错信息和波形上的层级路径能直接对上,排查时不用在脑子里做一层名字映射;同时 virtual sequencer 侧可以写一个 get_sqr(string name) 小函数统一查表,查不到就 fatal——把「键名写错」也从运行时崩溃提前成显式报错。
七、null 句柄崩溃的定位流程
前面三种模式各自的失效点不同,真碰上「vseq 跑到一半空句柄崩溃」的现场,可以按固定顺序排查,每一步对应一种模式的典型坏法。第一步看 sequence 是怎么 start 的:挂的是 virtual sequencer 还是 null——挂了 null 而代码里有 $cast(p_sequencer, m_sequencer),崩因基本坐实,要么改挂 vseqr 要么改取句柄方式。第二步看取句柄的语句有没有返回值检查:config_db 的 get 返回 0、$cast 返回 0 都必须当场处理,没处理就让错误穿透到了使用点,排查距离被拉远了一整个调用栈。第三步看绑定侧是否真的执行了:test 的 build_phase 里 set 语句在不在、env 的 connect_phase 里接线在不在,可以用 +UVM_CONFIG_DB_TRACE 或 +UVM_RESOURCE_DB_TRACE 把 set/get 全过程打出来对照。第四步看类型与作用域:set/get 两侧参数化类型是否一致、实例路径是否对得上当前 env 层级。
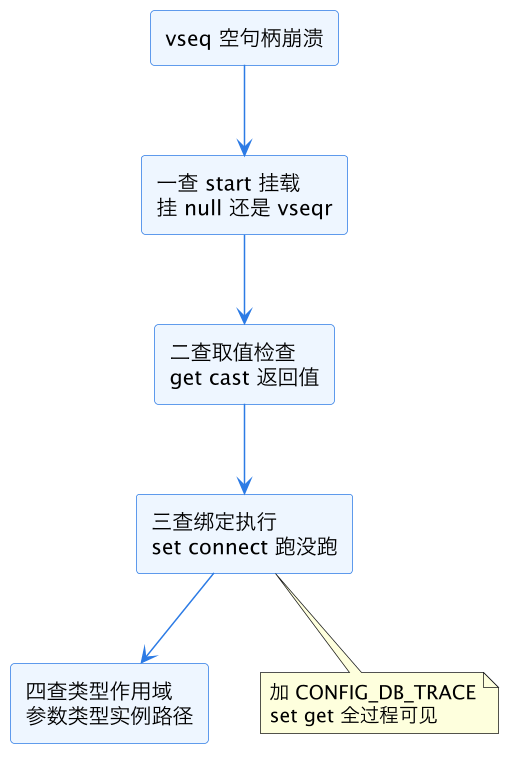
上图的排查顺序按「离崩溃点由近及远」排列:越靠前的步骤成本越低、命中率越高,实际项目里八成以上的 null 句柄崩溃在前两步就能定位——要么是挂错了执行者,要么是返回值没检查让错误穿透。走完全部四步还没定位的,通常是多 test 回归里个别 test 的 env 裁剪差异(比如某个 agent 被 plusarg 关掉),这时对照组选「同 vseq 在别的 test 里能跑」的那一个,diff 两边的 env 配置即可。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录的一篇 S 层标准篇,主关键词虚序列句柄复用。它向上承接 UVM virtual sequence 的 start 之旅 的启动机制与 virtual sequencer 多 agent 协调 的编排框架;横向与 m_sequencer 与 p_sequencer 之别(模式二的 cast 细节)、sequence 分层堆叠(句柄逐层下传)、UVM env 垂直与水平复用(复用宏观框架)同属激励复用族;失效调试入口见 config_db 拿到 null 句柄调试,sequence 与 driver 的基础交互见 UVM sequence、driver 与 scoreboard。
总结
虚序列句柄复用的核心是让 virtual sequence 的子 sequencer 句柄获取路径与具体 env 结构解耦:环境内复用走 virtual sequencer 中转(connect_phase 一次焊好、test 零参与),对外交付的激励库走 start 参数直传(依赖写成公开成员、body 开头必做 null 检查),老环境过渡用 config_db 注入(build 阶段暴露缺失);从 block 搬到 subsystem 时盯死三个改动点——句柄数组化、路径字符串废弃、passive agent 判空跳过——绑定模式选对了,同一条 virtual sequence 才能在几十个 test 里不崩、不跑偏地复跑。