Yosys synth_ecp5 综合到 JSON 流程:read、Trellis 原语与 write_json 对账
更新时间:2026-11-22。Yosys synth_ice40 流程 已经走完从 RTL 到 iCE40 比特流的链路,Yosys 网表输出流程 则比较了通用门设计的几种落盘格式。本篇换一个问题:当目标改成 ECP5、交付物停在 JSON 时,怎样确认文件里真的是 Trellis 器件原语,端口与连接关系又能否完整回读。全文不依赖布局器,综合阶段就能完成这套验收。
本文要回答的问题
read_verilog → synth_ecp5 → write_json每一步分别改变什么,哪一步才引入 ECP5 专属原语?- 同一份 RTL 在 ECP5 与 iCE40 下得到 35 和 51 个 cell,能否据此判断哪种芯片更省面积?
- JSON 中的
ports、cells、connections和整数 bit 编号如何对上 RTL 端口? - 为什么只读 RTL 就
write_json会报“contains processes”,加proc后的文件又能说明什么? - 不运行 nextpnr,怎样用
read_json + stat + check给综合产物做一个最小交付闭环?
先把操作主线和验收点放在一起。这里的 stat 是只读观察,write_json 是序列化,真正改变电路表示的是 synth_ecp5。
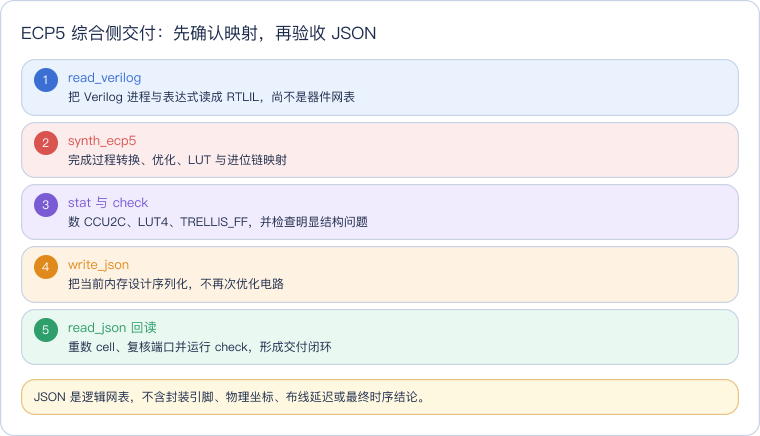
读这张卡要分清两类命令:synth_ecp5 决定电路由哪些 ECP5 单元组成;write_json 只把这个决定写成文件。若 JSON 内容不对,优先回查综合脚本与导出时机,而不是在 JSON 文本里手工修补。
一、实验设计:Yosys synth_ecp5 综合到 JSON 流程看什么
实验 RTL 是一个 12 位累加器。load 把外部初值装入寄存器,en 控制是否累加,step 只有两位,at_max 对 12 位计数值做归约与。这一小段电路同时包含位宽扩展、加法进位、两级选择、寄存器使能和组合归约,足以观察两族专用映射,又不会被存储器或复杂状态机分散注意力。
module accumulator (
    input  wire        clk,
    input  wire        load,
    input  wire        en,
    input  wire [1:0]  step,
    input  wire [11:0] initial_value,
    output reg  [11:0] count,
    output wire        at_max
);
    always @(posedge clk) begin
        if (load)
            count <= initial_value;
        else if (en)
            count <= count + step;
    end

    assign at_max = &count;
endmodule
这里没有异步复位,也没有给整个设计强加初始化值,目的是让本次对照集中在 load/en 与算术路径。复位极性、全局置位和 IO 寄存器都有各自的映射条件,不应从这一例推广出通用结论。
两条主脚本只有目标宏不同,随后都显式执行 stat 和 write_json:
# ice40.ys
read_verilog accumulator.v
synth_ice40 -top accumulator
stat
write_json build/ice40.json

# ecp5.ys
read_verilog accumulator.v
synth_ecp5 -top accumulator
stat
write_json build/ecp5.json
synth_ecp5 -json build/ecp5.json 也能在一个宏调用里要求 JSON 输出。本篇拆开写,是为了把“综合结束时的统计”和“导出当前设计”变成两个清楚的观察动作;两种方式不应被理解为两次不同综合。若脚本在两者之间又插入 opt、techmap 或其他命令,导出的自然是后来那份状态。
二、同一份 RTL 如何在两个目标族分叉
两族流程在读取与通用优化阶段共享许多概念,分叉发生在目标相关映射:iCE40 使用 SB_CARRY、SB_DFFE 与 SB_LUT4,ECP5 使用 CCU2C、TRELLIS_FF 与 LUT4。下图中的颜色只区分输入、两族映射和最终结构化产物,不表示性能等级。
日志还提供了映射发生的具体位置。ECP5 宏在第 2.1 步读入 ecp5/cells_sim.v,LUT4、CCU2C 和 TRELLIS_FF 的模块定义这时已经进入设计库;它们此时只是可供映射的模型,不代表累加器已经使用了这些资源。随后多次 techmap 把通用触发器和内部结构拆到可映射形态,第 2.42 步 abc 做组合逻辑工艺映射,第 2.43 步再套 ECP5 的 cells_map.v,第 2.44 步 opt_lut_ins 删除无用 LUT 输入。最后 autoname 只重命名对象,hierarchy 再确认顶层。
这个顺序说明两处容易误判的日志。第一,开头出现几十种 ECP5 模块名并不等于设计占用了几十种资源,最终数量只能看顶层 stat 或 JSON 的 modules.accumulator.cells。第二,abc 不是最后唯一决定结果的阶段,其后仍有目标模板展开和 LUT 输入清理;只摘 ABC 的一段中间统计,可能与最终 JSON 对不上。评审脚本时应把最后修改设计的命令、最后一次统计和导出命令作为一组保存,而不是从不同运行里拼数字。
图里的 51 和 35 只是对象计数,不是统一面积单位。一个 CCU2C 内含两位切片相关逻辑,一个 SB_CARRY 表示一位进位;LUT 输入的删减、控制逻辑吸收方式与寄存器打包规则也不同。把 cell 总数相减再推出“ECP5 省 16 个单元”或“面积少 31%”,在计量对象上已经错了。
真正有用的是分项问三个问题:12 位状态是否仍由 12 个触发器保存,算术是否进入目标族进位结构,组合控制与归约是否都落成 LUT。下面用原始统计回答。
三、stat 结果:看原语角色,不做跨族面积排名
ECP5 综合末尾同时给出进程数、cell 分类与 check。这里保留完整统计段,不截取单行数字,便于核对它确实是宏执行后的结果。
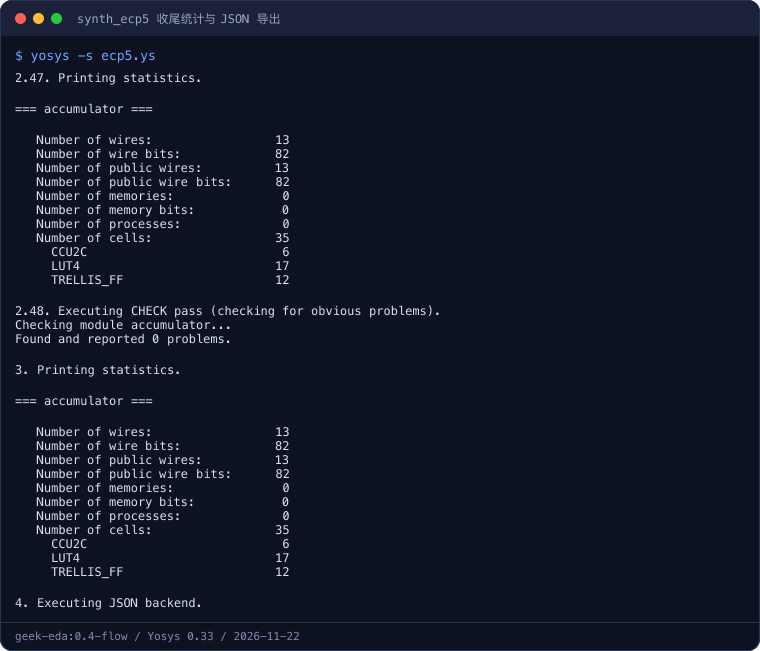
两次统计完全相同,因为中间没有修改设计的命令;Number of processes: 0 表明行为进程已经转换,0 problems 是结构检查通过。最后的 JSON backend 没有打印 cell 数,它只负责写文件。两条 iCE40/ECP5 结果与执行 proc 后的早阶段结果汇总如下,所有数字都由脚本直接解析 JSON,并可在综合日志的 stat 中复核。
| 设计状态 | cell 构成 | 总数 | 能回答的问题 |
|---|---|---|---|
proc 后、目标综合前 | $add×1、$dff×1、$mux×2、$reduce_and×1 | 5 | 高层运算与过程已转成 RTLIL cell |
synth_ice40 后 | SB_CARRY×11、SB_DFFE×12、SB_LUT4×28 | 51 | 已映射成 iCE40 原语 |
synth_ecp5 后 | CCU2C×6、LUT4×17、TRELLIS_FF×12 | 35 | 已映射成 ECP5 原语 |
早阶段的 $dff 是一个 12 位字级单元,综合后两族都变成 12 个单比特触发器,因此不能拿“1 变 12”判断膨胀。加法方面,iCE40 有 11 个 SB_CARRY,ECP5 有 6 个 CCU2C;数量关系主要反映原语位宽和最低位处理方式,不是简单的优化倍率。LUT 数量还受 load、en 和 at_max 如何与其他逻辑合并影响。
iCE40 原始统计同样以 0 problems 收尾,SB_CARRY=11 / SB_DFFE=12 / SB_LUT4=28 与 JSON 解析逐项一致。这组对照的价值是确认目标宏确实生效,而非评选器件。若工程要做真实选型,至少还需要同族物理资源占用、目标频率下的布线结果、IO 与封装条件,以及功耗或成本约束。
四、JSON 里有什么:从端口 bit 追到 LUT 连接
write_json 生成的文件以 creator 标记工具版本,主要设计位于 modules.accumulator。ports 给出方向和 bit 列表,cells 给出每个实例的类型、参数与连接,netnames 把具名线网映射到 bit。以下是从实际 ECP5 文件提取的内容,省略号只用于缩短展示,不改写数值。
{
  "creator": "Yosys 0.33 (git sha1 2584903a060)",
  "ports": {
    "clk": { "direction": "input", "bits": [2] },
    "step": { "direction": "input", "bits": [5, 6] },
    "count": { "direction": "output", "bits": [19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30] },
    "at_max": { "direction": "output", "bits": [31] }
  },
  "cell_type_counts": { "CCU2C": 6, "LUT4": 17, "TRELLIS_FF": 12 },
  "at_max_LUT4_Z": {
    "type": "LUT4",
    "parameters": { "INIT": "1100000000000000" },
    "connections": { "A": ["0"], "B": [32], "C": [33], "D": [34], "Z": [31] }
  }
}
at_max 对应 bit 31,而示例 LUT 的 Z 也连接 31,因此这个实例直接驱动该输出。A 的字符串 "0" 是常量 0,不是编号为零的普通线网;结合 INIT 可以看出,未使用输入被接成常量后,LUT 实现的是剩余三路输入的归约关系。B/C/D 则接到中间 bit。脚本分析连接时要把整数、字符串常量和总线顺序都处理好,不能只按名称猜连线。
这个片段也解释了为什么 JSON 适合程序验收:不需要解析 Verilog 表达式,遍历 cells 就能统计类型,沿 connections 就能追到端口。netnames 数量在早阶段、iCE40 和 ECP5 分别为 14、12、13,这不是功能端口变化——三份文件都保留 7 个顶层端口,差异来自内部自动命名与公开线网保留情况。
五、失败边界:write_json 不能替代 proc 或综合
第一次尝试在 read_verilog + hierarchy 后直接导出,Yosys 明确失败。这个边界值得保留,因为“JSON 是通用格式”不意味着它接受任意时刻的内存状态。
3. Executing JSON backend.
ERROR: Module accumulator contains processes, which are not supported by JSON backend (run `proc` first).
原因是 always 仍以 process 对象存在,JSON backend 不支持序列化这种进程。加入 proc 后导出成功,得到前述 5 个高层 cell;但这份 early.json 仍含 $add、$dff 等 Yosys 内部类型,不能因此当成 ECP5 后端可直接消费的目标网表。
| 导出时机 | 本次结果 | 正确用途 | 不能据此声称 |
|---|---|---|---|
read_verilog + hierarchy 后 | 报 contains processes,导出失败 | 定位进程尚未转换 | JSON 工具或文件损坏 |
再加 proc 后 | 成功,5 个 RTLIL cell | 教学、检查早期结构、自定义 pass 调试 | 已完成 ECP5 映射 |
synth_ecp5 后 | 成功,35 个目标原语 | 交给后续 ECP5 流程或程序分析 | 已完成布局布线与时序收敛 |
因此排查空文件或错误类型时,先打开脚本看 write_json 的位置,再看日志最后一次修改设计的命令。把 write_json 往后移动并不总能解决问题:如果移动到另一个目标宏之后,文件就会属于另一个器件族。
六、不跑布局器的交付闭环:read_json 回读再对账
最后的验收脚本只含四行:
read_json build/ecp5.json
hierarchy -top accumulator
stat
check
回读日志显示 ECP5 黑盒定义与顶层模块被导入,最终仍是 CCU2C=6、LUT4=17、TRELLIS_FF=12,共 35 个 cell,Found and reported 0 problems。综合末尾与回读后的 wire bits 也都是 82,进程数也都是 0。这证明本次写盘、解析和重新建立设计的链路没有丢失这些可统计结构。
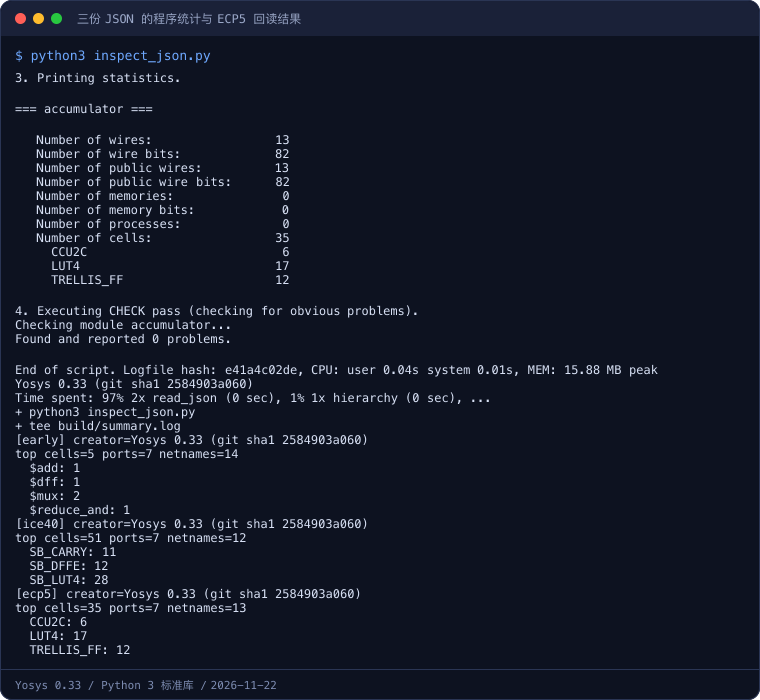
终端卡上半段是回读后的原始 stat 和 check,下半段是脚本遍历 JSON 得到的分类计数。两者一致,比只看文件存在或文件大小可靠。实际项目可把这个闭环固化为四条验收:文件能被严格 JSON 解析;指定顶层存在且端口方向、位宽符合接口;cell 类型属于目标族允许集合;回读统计与综合统计一致。
边界也要写清:check 通过不等于功能等价,不代表布局可行,更不代表满足时序。位流生成仍需要器件、封装、引脚约束和后端流程;若遇到存储器没有按预期进入 DP16KD,应在综合日志与接口时序上排查,Yosys ECP5 BRAM 推断失败 给出了同步读与异步读的对照。JSON 网表本身的读写异常则见 Yosys JSON 网表读写回环报错。
七、把一次实验变成工程检查:四项决策与可复现脚本
本次 inspect_json.py 没有使用正则去数类型字符串,而是用 JSON 解析器读取 modules.accumulator.cells,再按每个实例的 type 归类。这一点很重要:源码路径、属性或信号名里也可能出现 LUT4,简单搜索会把描述文字算成单元。程序同时读取 ports 与 netnames,因此输出的“7 个端口”和“13 个具名线网”有明确结构来源,不是根据 RTL 手工填写的第二份数据。
要把这个方法用于自己的项目,建议按下面顺序决定检查强度,不必一开始追求大而全的网表平台。
| 当前任务 | 最小检查 | 发现异常后的动作 |
|---|---|---|
| 综合脚本刚跑通 | stat 无进程残留、目标原语分类符合预期 | 回查宏是否执行、顶层是否选对 |
| JSON 要交给自己脚本 | 严格解析、顶层存在、端口方向和位宽匹配 | 对照 RTL 接口与 connections,不要手改 JSON |
| JSON 要交给另一段流程 | 再做 read_json,比较 cell 分类并运行 check | 保留写出与回读两份日志,定位格式或版本差异 |
| 准备进入物理实现 | 补器件、封装、引脚与时序约束 | 到后端重新看利用率和时序,不沿用综合结论 |
版本管理也有实际价值。JSON 的 creator 能指出文件由哪个 Yosys 版本生成,单元名称、参数编码和映射策略却可能随版本变化。持续集成里若写死“必须恰好 17 个 LUT4”,一次合理优化也可能让检查误报。更稳妥的分层是:接口与禁止项做严格断言,例如顶层端口不能少、不能出现未知目标类型;资源数量先保存为趋势,只有超出项目预算才失败。若研究对象正是某次映射差异,再像本篇一样固定版本、固定 RTL、固定命令并保存完整日志。
复跑时可以主动做三个小改动来验证自己读懂了流程。先把 step 改成常数 2'd1,观察加法与进位结构如何收缩;再给 count 增加同步清零,检查寄存器控制如何变化;最后把 write_json 移到 synth_ecp5 之前,确认导出文件退回哪种抽象层级。每次只改一个变量,并重新比较 stat 与 JSON,而不是沿用本次数字。这样得到的结论才可迁移到自己的设计。
还要避免一种看似方便的“修复”:为了让下游接受文件而手工把 $add 替换成 CCU2C。目标原语不仅是名称,还涉及端口方向、参数、进位连接与初始化语义,文本替换无法建立这些约束。正确做法是回到综合器完成映射,再用回读和功能验证检查产物。JSON 的可读性是为了审计与自动化,不是邀请人工作网表编辑器。
实验环境
- 机器/系统:macOS(Apple Silicon),Docker 容器
geek-eda:0.4-flow - 工具版本:Yosys 0.33 (git sha1 2584903a060),由容器内
yosys -V输出;JSON 统计使用 Python 3 标准库 - 日期:2026-11-22
- 完整命令:
docker run --rm -v "$PWD":/work -w /work geek-eda:0.4-flow bash ./run.sh - 执行内容:依次运行
yosys -s ice40.ys、yosys -s ecp5.ys、预期失败的early-fail.ys、加入proc的early.ys、readback.ys,最后执行python3 inspect_json.py。预期失败由脚本检查退出状态,其他步骤任一失败都会停止。
代码获取
完整 RTL、两族综合脚本、早阶段失败与修复用例、回读脚本、统计程序及结果摘录位于公开仓库:geek-doc.cn/experiments/flow-yosys-synth-ecp5-json。准备同名容器镜像后进入该目录执行 make run,即可生成三份 JSON 并复核本文全部计数。
这一篇在知识体系里的位置
- 想从 ECP5 的相邻开源流程理解 iCE40 到比特流的完整链路,读 Yosys synth_ice40 流程;本篇刻意停在综合 JSON,不重复布局布线。
- 想比较 JSON、门级 Verilog 与 BLIF 的消费者和导出选项,读 Yosys 网表输出流程。
- 想理解宏内部 pass 顺序以及何时需要手工插桩,读 Yosys 手工 pass 链。
- 更多开源 FPGA 综合、网表与报错主题见 EDA 工具实践目录。
总结
Yosys synth_ecp5 综合到 JSON 流程的正确验收顺序是:先由 synth_ecp5 完成目标映射,再用 stat 核对 Trellis 原语,用 write_json 导出,最后以 read_json + stat + check 回读对账。本次同一累加器在 ECP5 下得到 6 个 CCU2C、17 个 LUT4、12 个 TRELLIS_FF,回读计数不变且检查为零问题;iCE40 的 51 与 ECP5 的 35 采用不同原语口径,不能直接当作面积优劣。只读 RTL 就导出会因 process 未转换而失败,补 proc 只能得到高层 RTLIL JSON,仍不等于 ECP5 网表。JSON 能证明逻辑结构可交接,不能替代功能验证、引脚约束和布局布线。