sink 聚类:时钟树几何聚类算法对 skew 与 wirelength 的影响深讲
更新时间:2026-10-02。时钟树综合(CTS)是物理设计里最「几何」的一步:几万个触发器的时钟引脚散布在版图上,工具要把它们连成一棵从时钟根出发、到达时间尽量一致的树。本站 CTS 时钟树综合 讲过整棵树的构建流程,useful skew 与 CTS 优化 讲过 skew 预算怎么花。这一篇往树根的方向再走一步:在建任何一级缓冲器之前,工具做的第一件事是把所有 sink(时钟接收端,主要是触发器的 CK 引脚)按位置分成一堆一堆——这就是 sink 聚类。聚类这一步看起来只是「分组」,但它实际上决定了树的拓扑骨架:哪些 sink 共享末梢缓冲器、树往哪些方向长、最长的线绕多远。聚类分得好,后面的 buffer 插入和绕线只是执行;分得不好,多少优化迭代都补不回来。
本文要回答的问题
- sink 聚类在 CTS 流程里处于什么位置,它的输入输出到底是什么?
- 主流的三类聚类算法(k-means、层次聚类、平衡二分)各自的目标函数是什么?
- 聚类的「堆大小」和「堆形状」怎么定量影响 skew 与 wirelength?
- 为什么不能只用几何距离聚类,还要考虑 skew group、功耗域和拥塞?
- 实战中怎么评估和调整聚类质量,有哪些典型的调参手段?
一、聚类在 CTS 里的位置:先分堆,再长树
先把坐标系建立起来。一颗中等规模 SoC 的某个时钟域,sink 数量从几千到十几万不等。CTS 的任务可以拆成两个子问题:一是拓扑生成——决定树的层次结构,即哪些 sink 先被同一个末梢缓冲器(leaf buffer)驱动,哪些末梢缓冲器再被上一级驱动,一直收到时钟根;二是嵌入与绕线——给每个缓冲器找物理位置,把线连出来。sink 聚类解决的就是第一个子问题的最底层:把几何上靠近的 sink 分成若干簇(cluster),每簇交给一个 leaf buffer。
这一步为什么必须先做?因为不聚类就没有「局部性」。时钟树的全部价值建立在空间局部性上:位置近的 sink 共享尽可能多的上游路径,它们的到达时间天然接近(走同一段线、过同一串缓冲器),skew 自然小;同时共享路径意味着总线长短。聚类就是在用算法把「局部性」显式地划出来。
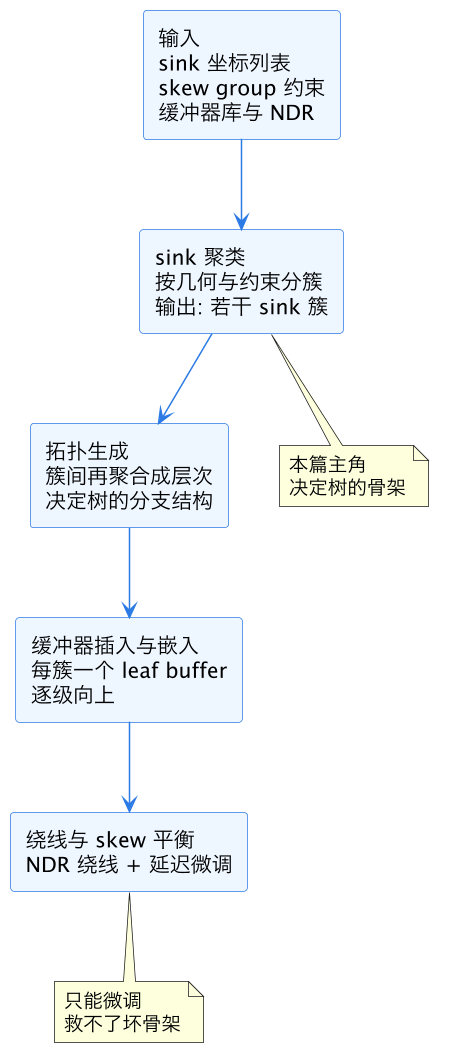
上图的关键信息在注记里:聚类处在整个流程的最上游,后面所有步骤都在它划定的框架内做局部优化。绕线阶段的 skew 微调手段(加 detour、调缓冲器尺寸)动态范围有限——典型工具能给单点补的延迟在几十皮秒量级。如果聚类阶段把两个相距 800 微米的 sink 分进同一簇,leaf buffer 到两者的线长差带来的 skew 可能直接吃掉大半个微调预算,后面只能被迫插延迟缓冲器,功耗和面积一起涨。所以业内的共识是:CTS 质量七分在聚类,三分在平衡。
二、聚类的目标函数:到底在优化什么
聚类不是「随便把近的点圈起来」就行,它有明确的优化目标,而不同目标之间互相拉扯。把目标函数摊开看,主要有四项。
第一项是簇内线长,常用 Half-Perimeter Wirelength(HPWL,半周线长,即包围盒半周长)来估计:一个簇内所有 sink 的包围盒宽加高,近似等于把这些 sink 连到一起所需的 Steiner 树线长。簇的包围盒越小,leaf buffer 到各 sink 的线越短,线延迟越小,线延迟的「散布」也越小——这对 skew 是双重利好。
第二项是簇的负载均衡。每个 leaf buffer 能驱动的扇出和总电容有上限(库单元的 max_cap、max_fanout 约束),所以簇内 sink 数量和总输入电容必须落在缓冲器的能力圈里。簇太大,要么缓冲器驱动不够导致 slew 恶化,要么被迫在簇内再插一级,凭空增加树的深度;簇太小,缓冲器数量膨胀,功耗和面积浪费。
第三项是簇间均衡。树的对称性要求同一层的簇「规模相当」:如果东边一簇 30 个 sink、西边一簇 6 个,两簇的 leaf buffer 负载差 5 倍,线长也差得远,到达时间天然差出一截,要靠后段硬拉平。聚类算法因此普遍带「容量约束」或「平衡惩罚项」。
第四项是总簇数与树深。簇数决定第一层分支数,层层向上决定树的深度。深度每加一级,就多一级缓冲器延迟和一级 OCV 暴露(关于片上偏差对时钟的影响,见 STA derate 建模与 POCV 入门 的时钟路径讨论)。聚类粒度因此直接和 latency 预算挂钩。
| 目标 | 度量 | 偏好的聚类形态 | 冲突对象 |
|---|---|---|---|
| 簇内线长小 | HPWL / 包围盒 | 小而紧凑的簇 | 缓冲器数量 |
| 负载均衡 | 簇内电容、扇出 | 大小均匀的簇 | 几何紧凑性 |
| 簇间对称 | 同层簇规模方差 | 各向均匀的划分 | 不规则的 sink 分布 |
| 树深浅 | 簇数 → 层数 | 大簇少层 | 簇内线长 |
这张表要读的是「冲突列」:四个目标两两互怼,不存在同时最优的聚类。所有实用算法本质都是在做加权折中,差别只在折中的数学形式。这也是为什么不同 EDA 工具、同一工具不同 effort 档位跑出来的树形态差异很大——权重不同。
三、三类主流算法:k-means、层次聚类、平衡二分
知道了优化什么,再看具体怎么算。工业界和学术界沉淀下来的 sink 聚类方法大体三族。
k-means 及其变种。这是最直觉的一族:选 k 个簇心,迭代执行「每个 sink 归入最近簇心、簇心移到簇内质心」两步直到收敛。优点是快,O(n·k·迭代次数),十几万 sink 也能秒级出结果;缺点同样明显——k-means 的簇天然趋向等大球状,对 sink 分布不均的版图(比如 CPU 核内部触发器密、外圈稀疏)会切出不合理的簇,而且它不带容量约束,需要后处理把超容簇拆开。实用流程里常用 k-means 做初始划分,再交给带约束的细化阶段。
层次聚类(agglomerative / divisive)。自底向上版从每个 sink 自成一簇开始,反复合并「距离最近且合并后不超容」的两簇,直到簇数达标;自顶向下版则递归地把大簇切成两半。合并距离的定义(单链、全链、质心距离)直接决定簇的形状偏好:全链距离偏好紧凑球状簇,单链容易拉出细长簇。层次聚类的好处是天然产出一棵树状的嵌套结构,和时钟树本身的层次天然契合——事实上经典的 DME(Deferred-Merge Embedding)类算法就是把自底向上合并和自顶向下嵌入配成一对。
平衡二分(balanced bipartitioning / geometric matching)。这一族的代表做法是在每一层用一条几何分割(比如中位数切割或最小割)把 sink 集合分成规模相等的两半,递归下去直到每份小到可被一个缓冲器驱动。它的杀手锏是「平衡」被写进了算法骨架:每层严格对半分,同层簇的规模方差趋近于零,树的对称性有数学保证。代价是几何上可能切穿密集区——一条直切线可能把本来紧挨着的一群 sink 劈到两棵树里,局部线长变差。所以现代工具多在二分的切线选择上引入方向交替(横竖轮换,类似 k-d 树)和拥塞感知。
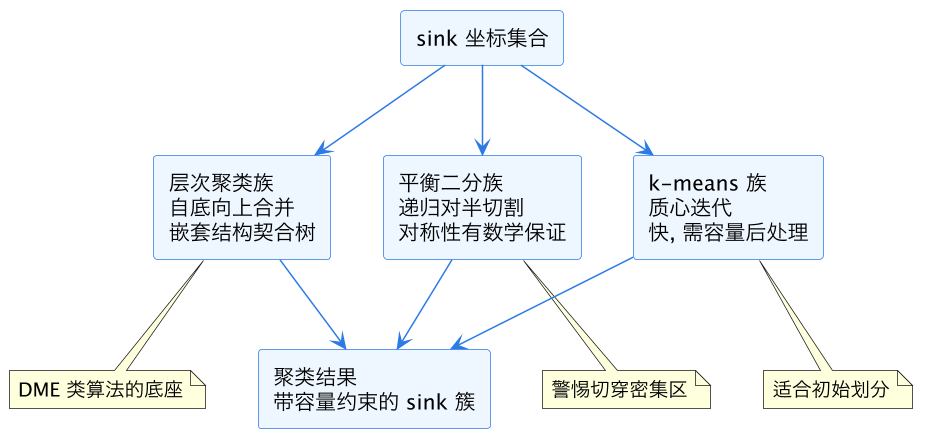
三族算法没有绝对的胜负。工程实践中常见的组合是:平衡二分定树的宏观骨架(保证对称),层次聚类做中观归并(尊重局部密度),k-means 或局部交换做微观 refine(修容量违例和离群点)。理解这一点很重要——当你在某个商用工具的报告里看到「clustering」阶段,它内部大概率是这种组合拳,而不是教科书里的单一算法。
四、聚类质量如何传导到 skew 与 wirelength
现在把因果链讲透:聚类的两个几何属性——簇的「散布半径」和簇的「规模均衡度」——分别怎么传导到最终 QoR。
先看 skew。一个簇内,leaf buffer 到各 sink 的线长不尽相同,最远的 sink 和最近的 sink 之间的到达时间差是簇内 skew 的主项。用 Elmore 延迟的直觉:线延迟随长度近似平方增长(RC 乘积),簇的散布半径 r 翻倍,簇内最大线延迟差大约变四倍。经验数字是:28nm 节点上,簇散布半径从 50 微米涨到 150 微米,簇内 skew 能从十几皮秒恶化到五六十皮秒——而 setup 检查里时钟 skew 是直接从周期里扣的。再看簇间:同层簇规模不均,leaf buffer 的负载和走线不对称,到达时间的均值就会漂移,这部分 skew 必须在更高层用延迟补偿吃掉。skew 的系统背景见 STA clock uncertainty 与 jitter,那里讲的 uncertainty 预算里,CTS 残留 skew 是大头。
再看 wirelength。总线长可以粗分为「簇内线长」和「簇间干线线长」。聚类把散布控制得越紧,簇内线长越短,但代价是簇数变多、干线分支变密。数学上存在一个最优点:簇太大时簇内线长主导浪费,簇太小时干线膨胀主导浪费。大量论文和工具实测给出的甜点区是每个 leaf buffer 驱动 8 到 32 个 sink(视节点和驱动能力浮动)。wirelength 又反过来影响 skew:线越长,对工艺偏差和串扰越敏感,统计意义上的 skew sigma 越大——这又和 LVF/SOCV 统计时序 讲的时钟路径 sigma 传播接上了。
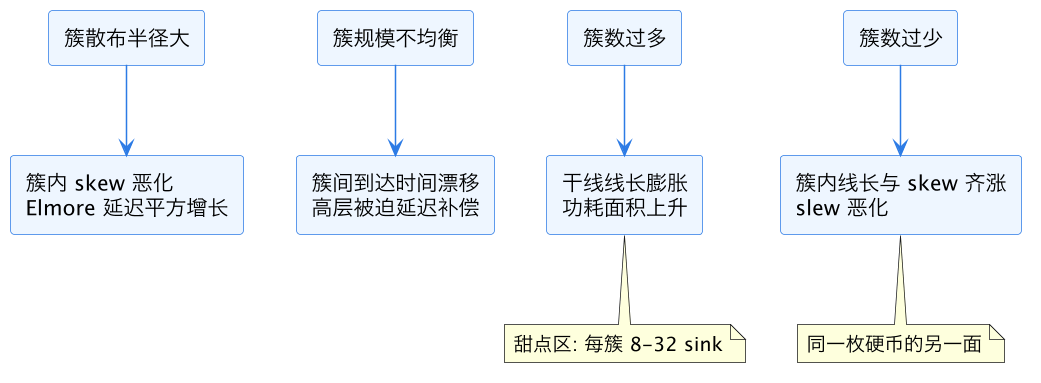
这张图把四种「坏聚类」的代价并排摆开,注意左下和右下是一对矛盾——簇数在两头都扣分,这就是第四节开头说的甜点区的几何来源。实战里评估聚类质量,最直接的两个体检指标就是:簇散布半径的分布(看长尾,长尾簇是 skew 杀手)和同层簇规模的直方图(看方差,方差大说明对称性崩了)。
五、纯几何不够:约束感知聚类
到这一步讲的都是几何,但真实芯片里的 sink 聚类从来不是纯几何问题。至少四类非几何约束必须进算法。
第一类是 skew group。不是所有触发器都要求彼此同时到达——不同 skew group 之间允许有意的相位差(useful skew 正是利用这一点)。如果把分属两个 skew group 的 sink 聚进一簇,工具会在树内硬做延迟差,既浪费缓冲器又恶化功耗。所以聚类必须先按 skew group 分区,区内再几何聚类。这和 useful skew 与 CTS 优化 讲的是同一枚硬币的两面。
第二类是功耗域与电压域。跨电压域的时钟路径需要电平转换和特殊的缓冲器放置位置,聚类若把不同电压域的 sink 混在一起,leaf buffer 放哪边都不对。
第三类是物理障碍与拥塞。宏单元(memory、硬核 IP)上方不能放标准单元,聚类产出的簇如果横跨宏边界,leaf buffer 会被合法化推到远处,线长和平滑性一起崩。先进节点下绕线拥塞同样致命——布局拥塞与 cell padding 讲的拥塞热点区,时钟干线要尽量绕行,聚类阶段给簇加「避开热点」的代价项比事后绕线便宜得多。
第四类是时钟门控结构。带 ICG(integrated clock gating)的域,sink 其实挂在 ICG 后面,聚类的对象应该是 ICG 的输出节点而不是最终触发器,否则树会失去门控粒度的层次。clock gating 的 STA 检查 有门控结构的时序视角。
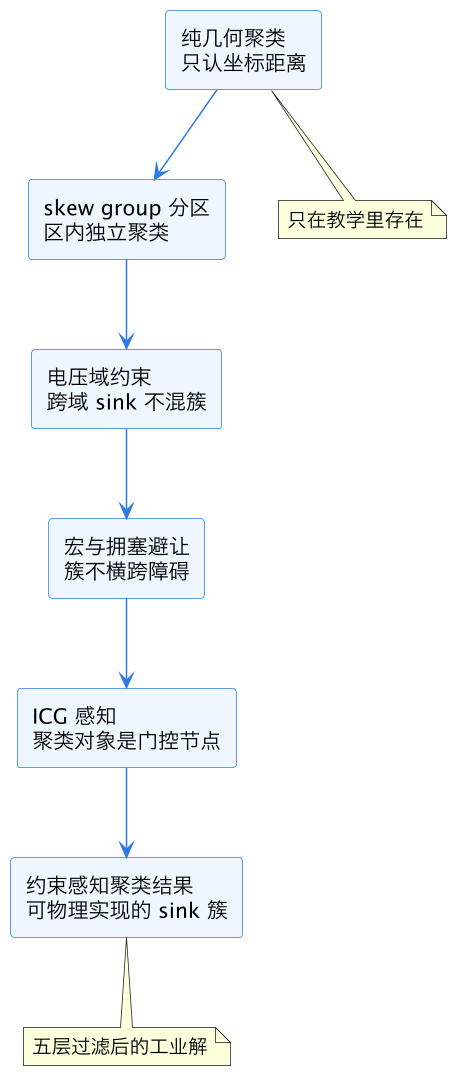
这张图按「过滤管道」来组织:几何聚类出的粗结果,逐层被套上 skew group、电压域、障碍、门控四层约束,最后才是能落地的簇。忽略其中任何一层,CTS 后段都会以十倍代价还债——比如跨 skew group 混簇的债,是用 delay buffer 堆出来的虚假平衡,功耗报告会替它记账。
六、实战:怎么评估和调聚类
落到日常 CTS 调优,sink 聚类层面的可操作手段有这几样。
一是看报告里的簇统计。主流工具在 CTS log 或专门的 clustering 报告里给出簇数、簇规模分布、平均散布半径、最大散布半径。重点关注散布半径的长尾——P99 簇往往是 skew 违例的重灾区。发现长尾后,针对性手段是收紧 max_fanout/max_cap 约束或调小聚类半径参数(有的工具叫 cluster size、有的叫 sink proximity),让算法把大簇拆小。
二是用 skew 报告反推聚类问题。CTS 后的 skew report 如果呈现「空间聚集性」——某片区域的 sink 集体偏早或偏晚——几乎可以断定是那片区域的聚类或拓扑出了问题,而不是绕线问题。空间聚集的 skew 用微调救不回来,应该回到聚类阶段重做,比如对该区域加 max transition 约束迫使簇变小,或手工划定 clustering region。skew 的空间分析可以结合 CTS 时钟树综合 里的树结构可视化一起看。
三是和 mesh/混合结构的接口。高频设计常在树干用 mesh、树下用 tree(见 clock mesh 与 tree 混合结构),此时 tree 部分的 sink 聚类是在「mesh tap 点已经给定」的边界条件下做的,聚类目标从「到根对称」变成「到各自 tap 对称」,算法上等价于带锚点的聚类。
四是别忘了规则侧的联动。聚类再小,绕线如果不用 NDR(双倍线宽加屏蔽),skew 的 sigma 照样压不住,规则侧见 NDR 与时钟屏蔽规则。而公共时钟段越长,CRPR 能抵消的偏差越多——CRPR 时钟重汇聚悲观度移除 讲的抵消机制,本质上也受益于聚类带来的路径共享。聚类、绕线规则、签核抵消,三件事是同一个 skew 预算的三种花法。
这一篇在知识体系里的位置
本篇属 eda/ 目录时钟树专题线,向上承接 CTS 时钟树综合 的流程总览,把其中「第一步分堆」展开成算法专题;横向关联 skew 预算的分配方(useful skew 与 CTS 优化、STA clock uncertainty 与 jitter)、结构替代方案(clock mesh 与 tree 混合结构)、绕线规则(NDR 与时钟屏蔽规则);向下接签核侧的偏差分析(CRPR 时钟重汇聚悲观度移除、LVF/SOCV 统计时序)与时序视图(clock latency 之源与网络延迟)。数据流视角下,本篇是 数据流 S4:CTS 与绕线 阶段的算法层补充。
总结
sink 聚类是时钟树综合的第一步也是决定成败的一步:它把几何上靠近、约束上兼容的时钟接收端分成大小适中的簇,k-means 管速度、层次聚类管密度、平衡二分管对称,三族算法常在工业工具里组合使用;簇的散布半径经 Elmore 平方律直接放大成簇内 skew,簇数与规模的均衡度决定干线线长与簇间漂移,甜点区在每簇 8 到 32 个 sink 之间;实战中先用簇散布长尾和同层规模方差做体检,再配合 skew group、电压域、宏障碍与 ICG 四层约束做约束感知聚类,才能让后段的缓冲器插入和 skew 平衡有得可救。