暗硅与功耗墙:晶体管塞得下,为什么不敢同时通电
更新时间:2026-11-13。本文是「集成电路大类 · 芯片设计」入门层(beginner) 的一篇概念文。芯片功耗从哪来 给出了动态功耗 α·C·V²·f 与漏电的公式,低功耗设计直觉 讲了时钟门控、电源门控和 DVFS 怎么省,AI 加速器入门 讲了 NPU 为什么比 CPU 快。这一篇补上它们共同的上游背景:工艺进步让晶体管越塞越多,但芯片却越来越不敢让它们同时工作——这就是暗硅(dark silicon)与功耗墙(power wall)。
本文要回答的问题
- 工艺还在进步、晶体管还在变多,为什么芯片频率在十多年前就撞了墙?
- 「功耗墙」具体卡在哪几件事上:供电、IR drop 还是结温?
- 暗硅是坏掉的晶体管吗?它和普通闲置、时钟门控、电源门控是什么关系?
- 暗硅比例怎么逼出了大小核、GPU、NPU 这些异构结构?DVFS 和电源域在其中扮演什么角色?
- 评估一颗芯片时,为什么峰值 TOPS 和晶体管数量会误导人?
先给一张三种架构路线的对比卡,它是全篇的结论前置:面对同一块硅面积和同一个功率预算,通用同构多核、异构多核与专用加速器给出的答案完全不同。
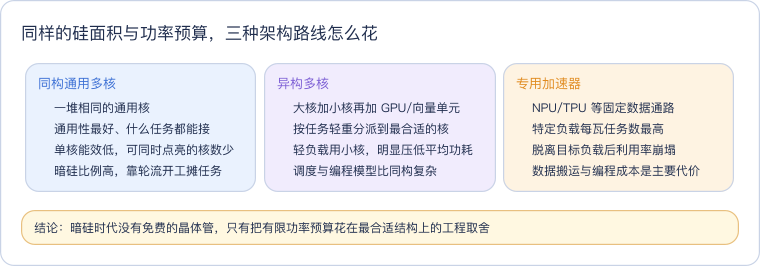
这张卡先记住一个读法:三栏不是谁淘汰谁,而是灵活性从左到右递减、目标负载下的能效从左到右递增。后面六节会先讲功耗墙怎么形成,再讲暗硅的准确含义,最后回到这些路线的权衡细节。
一、Dennard 缩放失效:密度还在涨,电压降不动了
理解暗硅要从一条没能持续下去的缩放规律讲起。1970 年代到 2000 年代初,行业遵循 Dennard scaling(登纳德缩放):晶体管尺寸缩小一代,Vdd 和 Vth 也近似等比例下降,单位面积功耗密度大致恒定。于是晶体管变多的同时每只管更省电,整片硅可以同时跑在高频上——频率从 MHz 一路抬到 GHz,靠的就是这条规律护航。
这条规律在 2005 年前后断掉了。原因在 摩尔定律与工艺节点 里有工艺侧的铺垫,这里只取与功耗相关的直觉:Vth 不能再往下降,否则晶体管关断时的亚阈值漏电会大到不可接受;Vdd 为了保证过驱动电压(Vdd−Vth)也降不下去。结果是晶体管密度继续按摩尔节奏翻倍,单位面积能承载的功率却不再跟着缩小。
读这张图抓住两侧夹击的结构:上排是需求侧——密度涨、电压降不动,单位面积想耗的功率越来越高;下排是供给侧——封装引脚能送进来的电流、电源网络能承受的压降、散热器能带走的热量,都受物理约束缓慢增长。两侧剪刀差张开的交点,就是功耗墙。蓝色表示工艺给出的前提,红色表示失效与后果,灰色表示被物理封顶的供给,橙色表示最终撞上的约束。
一个常见误解是把功耗墙等同于「电池不够大」。插电的数据中心同样有墙:机架供电、散热、封装电流密度都有上限。增大板级电源只能放宽供电链路中的一环,封装引脚、片上 PDN、结温和散热器仍可能先成为瓶颈,所以功耗墙通常需要芯片、板级和系统协同处理。
二、功耗墙的三道具体卡口:供电、压降与结温
「超功耗预算」不是一个抽象数字,而是会在三个具体环节出故障。
第一道是封装供电能力。芯片从板级取电靠封装引脚和电源分配网络,电流越大,对金属线宽、焊球数量、VRM(电压调节模块)档位的要求越高。峰值电流如果全部逻辑同时翻转,需求可能超出封装设计的最大供电电流。
第二道是 IR drop(电源压降)。电源网格本身有电阻,大电流流过产生压降,落到晶体管两端的实际电压低于名义 Vdd。动态翻转越集中,局部 IR drop 越严重,时序裕量被吃掉,极端情况下触发器直接采集失败。功耗分析与电源完整性 的签核工作主要就是在算这件事。
第三道是结温与热设计功耗(TDP, Thermal Design Power)。功耗最终几乎全部变成热,热量要从结区经封装、散热器传到环境。结温超过器件允许值会加速老化、触发漏电与温度的正反馈(越热漏电越大、漏电越大越热)。TDP 是散热设计和持续功耗规划常用的基准,并不等于芯片瞬时功耗的绝对上限;系统还会结合温度传感器做动态热管理(DTM),温度越线就降频或迁移负载。
| 卡口 | 物理量 | 全部逻辑同时高频翻转时的后果 |
|---|---|---|
| 封装供电 | 最大电流、VRM 档位 | 瞬时电流超供电能力,电压轨被拽塌 |
| 电源网络 | IR drop | 局部供电电压不足,时序违例甚至功能错误 |
| 散热路径 | 结温、TDP | 结温越限,老化加速,触发热降频 |
这张表的三行对应三种不同性质的约束:供电是「送不进来」,IR drop 是「送进来也分不均」,结温是「耗散不出去」。任何一道卡口先到,都会先于晶体管数量决定芯片能同时跑多少逻辑,暗硅的定义也就顺理成章。
三、暗硅是什么:不是坏晶体管,是预算下必须沉默的硅面积
**暗硅(dark silicon)指的是:在任一给定时刻,为了满足功率与热预算,芯片中必须保持时钟关闭或电源关闭的那部分硅面积。这些晶体管制造完好、功能正常,只是当下不被允许通电工作。与之配套的暗硅比例(dark silicon ratio)**指暗硅面积占比;行业普遍趋势是先进工艺上该比例持续走高,但具体数值随工艺、封装、场景和负载差异很大,不存在可到处套用的固定百分比。
先要把暗硅和三个相邻概念分清楚。
- 普通闲置(idle):模块没任务,但时钟和电源都还接着,触发器随时待命。若时钟树仍在翻转,它会继续贡献这部分动态功耗,模块漏电也仍然存在;在没有关钟或断电前,严格说不算暗硅。
- 时钟门控(clock gating):主动停掉闲置模块的时钟,动态翻转停止、动态功耗大幅下降,但电源仍在、漏电仍在。被关钟的区域有时称「暗」的浅形态,细节见 低功耗设计直觉。
- 电源门控(power gating):切断目标电源域的供电路径,动态功耗被消除,关断域漏电也降到接近零,是最彻底的暗形态,代价是唤醒要恢复状态、处理隔离,设计方法学依托 低功耗设计与 UPF 描述的电源域。

这张分层图表达一个关键认知:暗硅是预算管理的结果,不是制造缺陷。绿色活跃区的大小由当前功率预算反推,灰色关钟区与紫色断电区共同构成暗硅,两者的比例取决于漏电严重程度、状态保持需求和空闲时长——常见策略是短空闲优先关钟、长空闲再评估电源门控。任务随时间变化时,哪些硅区「暗」是动态轮换的,今天暗的是这块加速器,明天可能轮到那组大核。
学术界还常提 **utilization wall(利用率墙)**这个近义说法:受功耗墙限制,芯片的平均晶体管利用率被迫持续下降,名义上集成了几百亿管,任一时刻真正在翻转的比例却越来越小。暗硅是从面积角度描述同一件事,利用率墙是从活动比例角度描述,二者互为表里。
四、一笔面积与功耗预算账(示例参数,非实测)
抽象定义不如算一笔账直观。以下数字全部为自设的示例参数,非任何真实芯片实测,只用来演示预算约束如何推出暗硅。
假设一颗面向移动场景的 SoC,封装与散热给定的持续功率预算是 10 W;同等面积内可以放下 8 个通用核,每个核跑满频的功耗是 2 W。如果 8 个核同时满频,需求是 16 W,超出这个简化预算 60%。这笔账只能确定持续功率预算被突破,具体先撞封装供电、局部 IR drop 还是结温,还要看封装、电源网络和散热设计。在不降压降频、也不调整每个核功耗的前提下,10 W ÷ 2 W = 5 个核能同时满频,其余 3 个核需要关钟、断电或以更低性能点运行;按最保守的关钟/断电口径,仅 CPU 部分就出现 3/8 的暗硅面积,这还没算 GPU、NPU 和外设抢同一份预算。
| 计算结构(同等面积预算下的示例设定) | 跑同一批任务的相对能耗 | 说明 |
|---|---|---|
| 通用核 | 1.00(基准) | 取指、分支预测、缓存全套通用开销 |
| GPU/向量单元 | 0.30(示例值) | 宽并行数据通路,摊薄控制与取指开销 |
| 专用加速器 | 0.10(示例值) | 固定数据通路加数据复用,访存次数最少 |
表中 0.30、0.10 都是示意量级,用来说明行业普遍观察到的方向,不是实测比值。但方向本身是可靠的:专用结构砍掉了通用核为「什么都能算」付出的控制逻辑冗余,数据在阵列内部复用、少访存,单位任务的能耗可以显著低于通用核,这正是 AI 加速器入门 里 MAC 阵列省电的根因。
两笔账合起来,设计问题就换了提法:不再是「这片面积能塞多少晶体管」,而是「这 10 W 预算花在什么结构上完成的任务最多」。同样 3 个核的暗硅面积,换成平时断电、需要时才唤醒的专用加速器,回报可能高于再摆 3 个通用核——异构化与专用化的动力就从这笔账里长出来。
五、设计响应:一整族技术,而不是单一银弹
暗硅压力下的应对技术可以归成四族,先看全景。
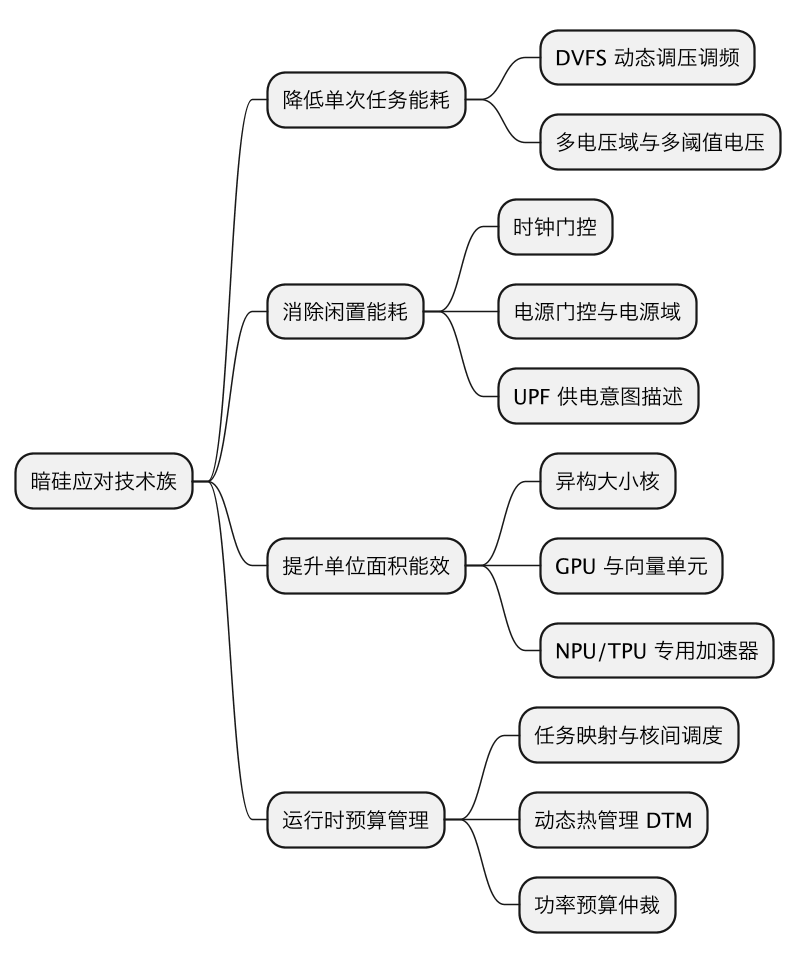
这棵树的切分标准是「钱花在哪个环节」:第一族让每次计算本身更便宜,第二族让不计算的部分不掏钱,第三族改变硅面积的构成,第四族在运行时决定此刻谁亮谁暗。四族不是替代关系,现代手机 SoC 通常四族全用。
第一族的主力是 DVFS:负载轻时同时降低频率和电压,由于动态功耗随 V²·f 变化,降压的省电效果是非线性的;重负载再抬回去。多电压域让不同模块各跑各的电压点,多阈值库让关键路径用快管、非关键路径用漏电小的慢管。
第二族就是第三节区分过的时钟门控与电源门控,工程上通过划分电源域、用 UPF 描述供电意图落地,低功耗大类导读 是这条线的系统入口。
第三族是结构层面的回答,也是暗硅最深远的后果:异构多核把通用核分成大小两档,轻任务派给小核、重任务才唤醒大核;GPU、NPU 这类加速器则占据固定面积,平时断电保持暗态,遇到匹配负载时整块唤醒,以高吞吐快速做完再回去睡觉。边缘场景的具体权衡可以参考 边缘 AI 加速器的选型与权衡。
第四族同样关键:任务映射决定负载放在哪类核上,热管理在温度越线时降频或迁移任务,功率预算仲裁在多个 IP 争抢高档位时按优先级分配——没有运行时管理,前三族的硬件能力协调不起来。
六、加速器不是万灵药:四个绕不开的代价
专用加速器能效耀眼,但如果它能解决一切,芯片里就不会还留着通用核。工程取舍至少有四个方面。
第一是利用率风险。加速器的高效以「负载匹配」为前提,NPU 跑矩阵乘极省,但遇到分支密集的串行逻辑效率崩塌;工作负载一旦偏离目标场景,这块面积就长期处于暗态,晶体管预算被白白占住。第二是 Amdahl 定律:系统加速比受串行部分限制,即使加速器把可并行部分做到无限快,串行比例仍决定上限,通用核负责的那部分不会消失。
第三是数据搬运能耗。加速器算得省,但喂数据要过内存墙——在不少 AI 和内存密集型负载中,把权重和激活从片外搬进来的能耗可能超过计算本身,AI 加速器入门 对此有专门展开。第四是编程成本:专用数据通路需要编译器、驱动、算子库配合,异构调度还要处理核间同步与一致性,软件栈的工程投入通常高于同构多核。
| 维度 | 同构通用多核 | 异构多核 | 专用加速器 |
|---|---|---|---|
| 灵活性 | 最高,任意负载可接 | 较高,靠调度匹配核型 | 低,绑定目标负载 |
| 目标负载能效 | 低 | 中 | 高 |
| 平均利用率 | 任务多样时较稳 | 调度得当时较高 | 匹配时极高,错配时极低 |
| 编程成本 | 低,模型统一 | 中,需感知核型调度 | 高,需算子库与编译支持 |
| 主要瓶颈 | 单核能效、暗硅比例 | 调度复杂度 | 数据搬运、Amdahl 串行段 |
| 典型角色 | 控制面、通用计算底座 | 手机/PC 主 SoC | NPU/GPU/多媒体 IP |
这张表与封面卡呼应但维度更细:选型的本质是预测未来负载的形状。负载谱宽且不可预测的场景,同构底座仍有价值;负载谱稳定、热点突出的场景,把暗硅面积换成专用加速器才划算。真实芯片几乎都是混合体——通用核保底、大小核调档、若干专用 IP 吃热点,没有纯解。
七、对工程决策的意义:别只数晶体管和峰值 TOPS
暗硅视角直接改变芯片评估的问法。只看晶体管数量,会高估先进工艺的收益——在功耗和热预算受限的产品中,越来越多区域可能只在部分时间活跃;只看峰值 TOPS,会忽略峰值功耗下通常无法长期持续的事实;厂商参数中的峰值可能只对应很短的冲刺窗口,随后热管理就会降频。
更靠谱的评估要同时看四组指标:持续功耗与 TDP 决定能长期点亮多少硅;持续算力(sustained TOPS)而非峰值才是热稳态下更接近真实使用的产出;典型负载下的利用率反映暗硅面积有没有被有效轮换激活;数据通路能耗提醒搬数可能比算数更贵。架构评审中一句有效的追问是:这个新增模块在目标工作负载里多大比例的时间是亮的,亮的时候省下的能量能不能抵掉它暗态漏电和占用的面积。
对前端设计人员,这意味着功耗预算要在架构阶段就参与取舍:电源域怎么切、哪些 IP 可断电、DVFS 档位怎么设,都与任务剖面绑定,而不是后端签核时才补算,工具侧流程见 功耗分析与电源完整性。
这一篇在知识体系里的位置
- 想补功耗公式与漏电的物理来源 → 芯片功耗从哪来;
- 想看时钟门控、电源门控、UPF、DVFS 的具体落地 → 低功耗设计直觉、低功耗设计与 UPF、低功耗大类导读;
- 想看专用加速器为什么能效高、内存墙怎么应对 → AI 加速器入门、边缘 AI 加速器的选型与权衡;
- 想看 Dennard 缩放终结的工艺侧脉络 → 摩尔定律与工艺节点;
- 想看功耗预算怎么在签核中核算 → 功耗分析与电源完整性。
总结
暗硅与功耗墙是同一条因果链的两面:Dennard 缩放失效后密度继续涨、电压降不动,而封装供电、IR drop 与结温/TDP 三道卡口共同限制可用功率,在给定预算下需要关钟或断电的完好硅面积就是暗硅,从活动比例看即利用率墙;短空闲通常优先时钟门控、长空闲再评估电源门控,暗区随任务轮换。四族技术协同应对:DVFS 与多电压域降低单次计算能耗,门控与电源域减少闲置能耗,异构大小核与专用加速器把暗硅面积换成高能效结构,运行时的任务映射、热管理与功率仲裁决定谁亮谁暗。加速器受利用率、Amdahl 定律、数据搬运和编程成本四重约束,并非万灵药。评估芯片时,晶体管数与峰值 TOPS 会误导决策,持续功耗、热稳态持续算力、典型负载利用率与数据通路能耗才是硬指标。