DMA Scatter-Gather 验证:描述符链表遍历、错误注入与数据一致性记分板
更新时间:2026-10-06。本文是「集成电路大类 · 数字验证」实操序列的 intermediate 标准篇,讲 scatter-gather DMA(聚散直接存储器访问)控制器的端到端验证。普通 DMA 一次搬一块连续内存,scatter-gather 则按软件准备好的描述符链表(descriptor chain)逐个描述符搬运散落在各处的 buffer,是网卡、存储、加解密引擎里最核心的搬运工。单个描述符取指的验证点在 DMA 描述符取指验证 里讲过,本篇聚焦「链」:遍历的正确性、断链与环的鲁棒性、多描述符间的数据完整性。记分板队列的基础写法见 SystemVerilog 队列实现 scoreboard。
本文要回答的问题
- scatter-gather 描述符链表的遍历语义是什么?next 指针、结束位、环回三种终止方式各要验什么?
- 描述符在内存里、DMA 用总线去读它,testbench 该怎么建「内存里的链表」并同步给参考模型?
- 非法 next 指针、中途断链、自环、越界 buffer 这些错误注入场景怎么系统构造?
- 几十个描述符拼出的一次传输,数据一致性 scoreboard 怎么按字节流比对?
- 背靠背提交多条链、传输中途更新链表、中断聚合(每 N 个描述符一次中断)各有什么坑?
一、SG DMA 的结构与验证对象
一个典型的 scatter-gather DMA 通道包含:寄存器接口(软件写首描述符地址、启动位)、描述符取指引擎(通过主端口到内存读描述符)、数据搬运引擎(按描述符给的源地址、目的地址、长度搬数据)、状态与中断逻辑(完成/错误上报)。每个描述符通常是一条 16 或 32 字节的记录,包含源地址、目的地址、长度、控制位(结束位、中断使能、环回位)和 next 指针。
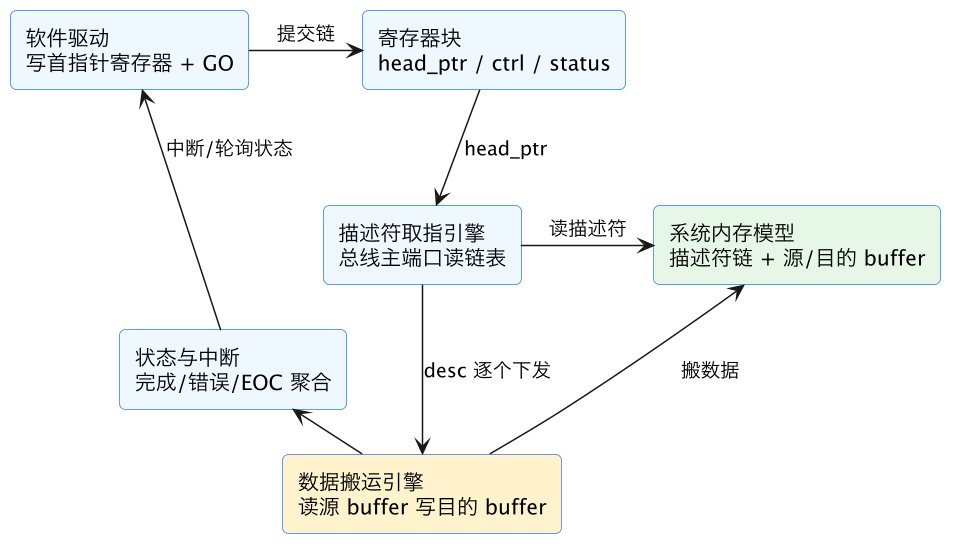
这张图框定了验证分工:寄存器层的读写按常规寄存器验证处理(方法见 UVM 寄存器验证方法学);本篇的主战场是三条——链表遍历语义(fetch 引擎对不对)、数据搬运正确性(move 引擎搬得全不全、对不对)、以及两者的交互(错误发生时停在哪、状态怎么报)。
先立一条贯穿全篇的心智模型:DMA 眼里的链表是一张内存快照。软件把描述符写进内存、写下首指针、拉 GO 之后,DMA 看到的是启动那一刻的链。启动后软件再改内存里的某个 next 指针,不同的实现语义不同(有的缓存整条链、有的逐描述符现取),testplan 第一件事就是问清规格:描述符是「启动时一次性预取」还是「边执行边取」。这个差异直接决定「运行中改链」场景的期望行为。
二、链表遍历语义:next 指针、结束位与环回
遍历的核心逻辑很朴素:从 head_ptr 取第一个描述符,执行完后看它的 next 指针——next 非零就跳到下一个,为零(或结束位置位)就结束整链,置通道完成状态。变体是环回模式(circular):到达链尾后自动绕回首描述符,常用于音频、网络收发这类持续流式场景,此时「结束」靠软件显式停通道。
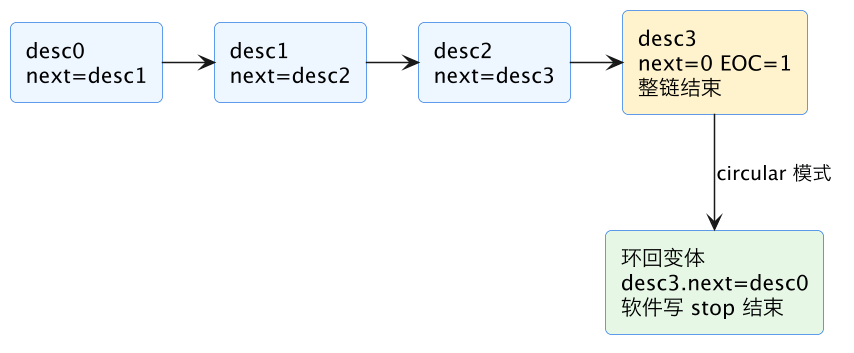
验证遍历语义至少要钉死这些点:
- 链长谱系:1 个描述符(最短链)、2 个、典型长度(8~32)、规格上限(如 256 或受描述符缓存容量限制)、上限加一(期望报错误或按规格截断)。
- 对齐与粒度:描述符地址是否要求 16/32 字节对齐;非对齐 next 指针是报错还是按低位截断处理,规格必须给出,断言必须检查。
- 结束语义:next=0 与 EOC 位同时存在时谁优先;EOC=1 但 next 非零(规格通常定义为继续还是错误)。
- 环回退出:环回模式下软件 stop 的生效点——当前描述符执行完才停,还是立即停?剩余数据算不算完成?
遍历正确性最顺手的验证工具是 SVA。把「每个被取指的描述符地址,必须等于上一个描述符的 next 或首指针」写成断言,挂在 fetch 引擎的取指事务上:
// 每次描述符取指地址必须来自 head_ptr 或上一个 desc 的 next
property p_chain_walk;
  logic [31:0] ld_next;
  @(posedge clk) disable iff (!rst_n)
  (desc_fetch_vld, ld_next = fetch_addr)
    ##1 (desc_exec_done [->1])
    ##0 (fetch_addr === head_ptr_q || fetch_addr === ld_next);
endproperty
a_chain_walk: assert property(p_chain_walk);
c_chain_walk: cover property(p_chain_walk);
实际写的时候用局部变量在 fetch 时记下地址,在下次 fetch 时比对「新地址 ∈ {head_ptr, 上一描述符 next}」。这类断言能抓住取指引擎状态机跳错描述符、burst 读跨描述符边界算错地址这类 RTL 级 bug。断言属性与 cover 的配对纪律见 断言覆盖密度指标,空真的断言等于没写。
三、内存模型与参考模型同步
SG DMA 验证平台的标准配置是一个行为级内存模型(通常是关联数组 bit [7:0] mem[longint]),描述符链和源/目的 buffer 都建在里面。driver 侧的流程是:sequence 先随机生成一条「逻辑链」(描述符个数、每个的长度、地址、是否带中断使能),然后由链构造器把它序列化进内存模型——这一步同时产出两份东西:DUT 看到的内存映像,和参考模型手里的「期望传输剧本」。
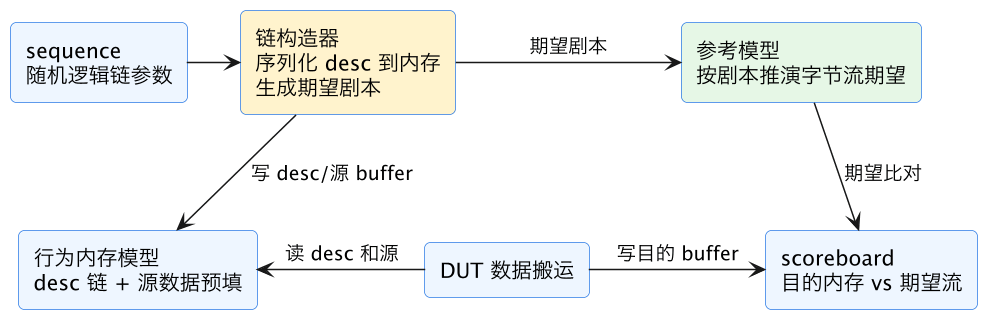
这里有几个实现要点。其一,源 buffer 要预填可辨识的随机数据,最省事的做法是给每个描述符一段带种子特征的伪随机流(比如以描述符序号和偏移为参数的可复现函数),这样 scoreboard 发现错字节时能立刻反推出它来自哪个描述符的哪个偏移。其二,目的 buffer 预填一个固定垃圾模式(如 0xA5),传输结束后扫描目的区间外的字节,确认 DMA 没有越界写——越界写是 DMA 最危险的一类 bug,只比对目的区间内的数据抓不到它。其三,地址映射要合法:所有描述符地址和 buffer 地址由约束求解保证落在内存模型的合法区间、buffer 之间按需重叠或不重叠(重叠本身就是一类场景:源和目的部分重叠时的行为规格)。
内存模型还要回答一个时序问题:DUT 读描述符时内存模型的响应延迟。真实 SoC 里描述符可能放在 DDR,几十上百拍延迟。内存模型应当支持可配的随机响应延迟,这样取指引擎的预取/缓冲逻辑才能在真实节奏下被压测;延迟配置与数据比对解耦的写法可参照 UVM scoreboard 时序错位与比对对齐。
四、错误注入:断链、坏指针、自环与越界
「链能走通」只是及格线,SG DMA 验证的含金量在错误路径。错误注入分两类:软件级错误(驱动给了非法的链)和硬件级错误(总线返回错误响应)。每一类都要在 testplan 里写清「期望的 DUT 行为」:停在哪个描述符、状态寄存器报什么、中断拉不拉、通道还能不能恢复再用。
| 注入场景 | 构造方法 | 期望行为检查点 |
|---|---|---|
| next 指向非法地址 | next 落到内存模型洞或未映射区 | 取指错误中断;error_desc_addr 寄存器记录当前描述符;通道停止 |
| 描述符内容非法 | length=0、地址非对齐、保留位非零 | 按规格报描述符错误或忽略,行为明确 |
| 中途断链 | 第 k 个描述符 next=0 但 EOC=0 | 按规格:视为正常结束还是异常,状态位必须可区分 |
| 自环 | desc.next 指向自己或链中前驱 | 看门狗/圈数上限触发,不得死锁挂死总线 |
| buffer 越界 | 源/目的地址加长度超出合法区间 | 总线错误中断,不得静默写穿 |
| 总线错误响应 | 内存模型对指定地址回 SLVERR | 错误重试或上报语义正确,数据区不被污染 |
| 运行中改链 | 启动后改写后续描述符内容 | 按「快照或现取」规格比对,行为确定 |
自环值得单独说。软件 bug 造出的环如果没有硬件防护,DMA 会无限循环占用总线。多数设计有描述符圈数上限或看门狗计数器,验证时要真的把环跑起来、等到上限触发,并确认触发后中断、状态位、通道可恢复性三者齐全。这是典型的「仿真要跑足够久」场景,回归里要保留长耗时版本。
错误注入的工程做法是让链构造器带「污点参数」:先随机生成一条合法链,再按注入类型对指定描述符动一刀。注入点位置也要随机——注在第一个描述符和注在第 50 个描述符,暴露的状态机路径完全不同。覆盖率上把「注入类型 × 注入位置分桶 × 通道当时状态」做 cross,方法见 covergroup 交叉与 illegal bins。
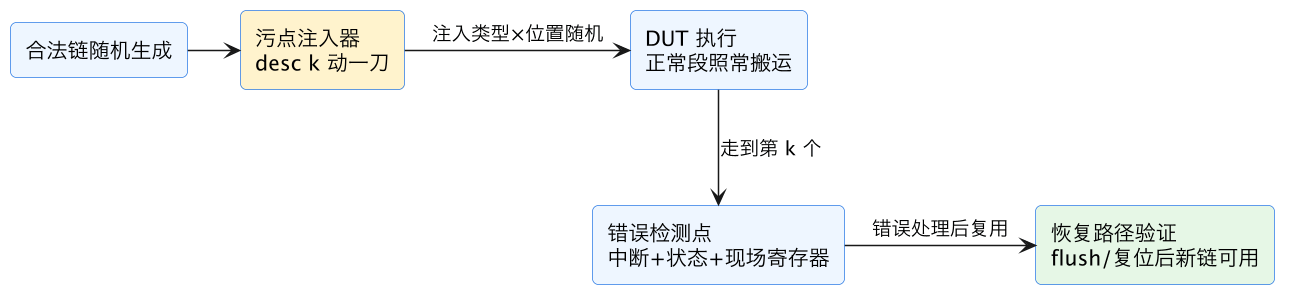
五、数据一致性 scoreboard:按字节流比对
几十个描述符拼出的一次传输,在 scoreboard 眼里应当化简成一条逻辑字节流:参考模型按剧本把各描述符的「源区间内容」依序拼成期望流,DUT 写入目的内存的实际内容拼成实际流,两者逐字节比对。比对不在事务粒度做(描述符边界只是软件视角,数据本身没有边界),而在整个链完成(或出错停止)后做一次终态比对,外加传输过程中的周期性快照比对用于早期定位。
终态比对分三段:
- 目的区间逐字节比对:
actual = mem[dst_base + i]对expected_stream[i],不等即报错并打印三元组(字节偏移、所属描述符号、描述符内偏移)——这就是源 buffer 用可复现函数的回报,反查零成本。 - 越界写扫描:目的 buffer 前后各留一段 guard band(预填 0xA5),比对结束确认 guard band 一字节未动。
- 源区间完整性(可选但推荐):确认 DMA 没写源 buffer,捕捉「读写方向接反」这类蠢但致命的 bug。
错误注入用例里比对逻辑要跟着剧本走:参考模型知道第 k 个描述符会触发错误,期望流就只拼到第 k 个描述符已完成的部分,scoreboard 按「部分完成」语义比对已完成段、确认未完成段未被触碰。这要求参考模型对「错误发生点之前到底完成了多少」有精确建模——有些实现保证描述符粒度原子性(错误描述符之前的全部完成、之后的一笔不动),有些实现可能搬了半个描述符,规格必须明确,scoreboard 才能给出确定期望。
背靠背提交是另一个比对难点:软件在前一条链还没走完时就写 head_ptr 提交新链。规格通常定义为「排队」(新链在前链结束后自动启动)或「拒绝」(busy 位保持,软件轮询)。排队语义下参考模型要维护链级 FIFO,scoreboard 按完成顺序逐链比对;中断聚合(每 N 个描述符或每条链结束才一次中断)则要求验证「中断次数 ≤ 描述符数」且「每个有中断使能的描述符最终都被某次中断覆盖」,用一个中断计数器和覆盖标记数组即可检查。
六、覆盖率与回归策略
SG DMA 的覆盖空间天然是多维的,建议按下表组织 covergroup,并用功能覆盖率闭环流程收敛(见 功能覆盖率闭环计划):
| 覆盖维度 | 分桶 |
|---|---|
| 链长 | 1 / 2 / 3-8 / 9-32 / 33-上限 / 上限+1 |
| 描述符长度 | 1B / 非对齐 / 奇数 / 页边界跨越 / 最大 |
| 地址关系 | 源<目的 / 源>目的 / 部分重叠 / 跨页 |
| 终止方式 | next=0 / EOC / 环回 stop / 错误终止 |
| 错误注入 | 类型 × 注入描述符位置(首/中/尾) |
| 背靠背 | 单链 / 双链排队 / 链满拒绝 / 提交即完成 |
| 中断模式 | 每描述符 / 每链 / 聚合 N |
回归分两层:快速层跑随机合法链加少量错误注入( nightly 几百个种子);压力层跑超长链、背靠背提交加随机内存延迟、环回长跑(周末回归)。出错时的定位效率取决于前面埋的钩子:可复现源数据模式反查描述符、断言钉住遍历顺序、错误现场寄存器检查——三者齐上,一个 fail 种子通常十分钟内能定位到是哪个描述符的哪个环节。
这一篇在知识体系里的位置
本篇与 DMA 描述符取指验证 是姊妹篇:那一篇讲单个描述符怎么取、怎么校验,本篇讲链怎么遍历、数据怎么端到端比对。记分板基础设施来自 SystemVerilog 队列实现 scoreboard 和 UVM scoreboard 时序错位与比对对齐;寄存器层验证接 UVM 寄存器验证方法学;覆盖率收敛用 功能覆盖率闭环计划 的流程;断言写法细节见 SVA 断言实践。
总结
DMA scatter-gather 验证的主线是「链遍历正确、字节流一致、错误路径可预期」:testplan 先问清描述符是启动快照还是边执行边取,用覆盖谱系打满链长、长度、地址关系、终止方式与环回退出;平台用行为内存模型同时承载 DUT 看到的链表和参考模型的期望剧本,源 buffer 预填可复现模式让错字节能反查到描述符;scoreboard 做终态逐字节比对加 guard band 越界扫描加源区间完整性三段检查,错误注入用污点参数化构造断链、坏指针、自环、越界并按「部分完成」语义比对;再用 SVA 钉住「取指地址必须来自 head_ptr 或上一描述符 next」的遍历不变量,背靠背排队与中断聚合单独建模——链级功能、数据完整性、错误鲁棒性三线都闭环,SG DMA 验证才算签出。