ViT 编码器推理:patch 批处理、动态分辨率与视觉-语言分离部署
更新时间:2026-10-03。前面 LLM serving 的 TTFT/TPOT 与 SLO 把纯文本大模型的服务指标讲透了,但多模态场景里,用户发一张图,模型在「看」这张图时花的算力常常不比「读」几百个文字 token 少。负责「看」的就是 ViT(Vision Transformer,视觉 Transformer)图像编码器:它把图片切成 patch、过一遍 Transformer,吐出一串视觉 token,再和文字 token 拼接进 LLM。这一段链路有自己的性能脾气——patch 数随分辨率平方增长、编码是 prefill 型负载、和 LLM decode 的资源画像完全不同。本文讲清 ViT 编码器推理的三件大事:patch 批处理怎么省算力、动态分辨率怎么平衡精度与成本、以及为什么成熟方案都把 ViT 和 LLM 拆开部署。底层的注意力 kernel 机制可对照 FlashAttention 显存分块 tiling。
本文要回答的问题
- ViT 把一张图变成 token 的过程里,算力和显存账怎么算?patch 尺寸为什么这么关键?
- 多张图、多个请求的 patch 怎么打包成批,才能既塞满 GPU 又不浪费在 padding 上?
- 动态分辨率(NaViT、any-resolution)相对固定分辨率省了什么、又牺牲了什么?
- 为什么 ViT 编码侧和 LLM 解码侧要分离部署?合并部署的坑在哪?
- 整条「图进 token 出」的流水线,瓶颈定位与调优的次序是什么?
一、从一张图到一串 token:ViT 编码的算力账
ViT 编码器干的事情可以浓缩成三步:切 patch、线性嵌入、过 Transformer。以 CLIP-ViT-L/14 这个多模态模型最常用的视觉塔为例:输入图先 resize 到 336×336,按 14×14 的 patch 切,得到 (336/14)² = 576 个 patch,每个 patch 拉平成向量后经一个线性层投到 1024 维,加位置编码,过 24 层标准 Transformer(每层一次多头自注意力加一次 MLP),输出 576 个 1024 维的视觉 token。
账很好算。设 patch 数 N = 576,隐藏维 d = 1024,层数 L = 24。每层 Transformer 的计算量约:自注意力部分 4·N·d²(QKVO 四个投影)加 2·N²·d(注意力矩阵乘),MLP 部分 8·N·d²(FFN 升维到 4d 再降回)。代入 N=576:每层约 2.4 GFLOPs 的「线性项」(随 N 线性)加 0.68 GFLOPs 的「平方项」(随 N 平方)。整张图约 80 GFLOPs——看起来不多,H100 理论上零点几毫秒就算完了。但注意平方项随 N 增长的速度:分辨率提到 672×672,N 变 2304,平方项涨 16 倍,线性项涨 4 倍,总算力约 540 GFLOPs;如果按 Qwen2-VL 那种原生分辨率思路处理一张 1344×896 的照片,token 数轻松破 4000,编码算力比 prefill 一段 4K 文本还贵。
显存账也有讲究。激活值大头是每层的注意力矩阵(N²)和 MLP 中间激活(4·N·d)。N=4096 时,单条样本的注意力矩阵按 FP16 算就要 4096²×2 字节 = 32 MB,乘 24 层、再乘 batch,activation checkpoint(激活重算)不开的话显存直接爆。所以 ViT 推理 kernel 同样离不开 FlashAttention 显存分块 tiling 那套在线 softmax 分块,把 N² 的显存压回 O(N)。

上图这张链路里,最值得盯的是最左边那个箭头:一切成本都由「分辨率 ÷ patch 尺寸」决定,而且注意力部分是平方关系。后面所有的优化——批处理、动态分辨率、分离部署——本质上都是在围绕这个平方项做文章。
二、patch 批处理:把不规则的视觉负载打包成规整的 GEMM
ViT 编码是典型的 prefill 型负载:一次前向、无 KV cache 跨步依赖、计算密度高。这种负载想跑满 GPU,靠的就是批处理(batching)。但多模态请求的批处理比纯文本难,难在每张图的 patch 数可能不一样(动态分辨率下尤其如此),而 GPU kernel 喜欢规整的矩形。
工程上有三代打法。第一代是「padding 补齐」:把一个批里所有图 pad 到同一个 N_max,塞进标准 batched GEMM。简单,但浪费一目了然——批里一张 4K patch 的大图配三张 500 patch 的小图,padding 浪费率超过 60%,白付的算力全是平方项放大的。第二代是「打包拼接」(packing):把所有图的 patch 沿序列维拼成一条长序列,用 cu_seqlens(累积长度数组)告诉 kernel 每段边界在哪,注意力只在段内做。这正是 varlen(变长)注意力的玩法,FlashAttention-3 的 Hopper 流水线 里讲的 cu_seqlens 打包格式在 ViT 侧同样是主力——跨图边界读到零、不串味,一个 kernel 服务整个批。第三代是「连续批调度」:ViT 服务自己跑一个 continuous batching 循环,新请求的图预处理完就插队进当前批,把 GPU 空隙填平,思路和 continuous batching 调度器 同源,只是调度单元从「请求」变成了「图片」。
批处理还有一层容易被忽略的优化:预处理流水化。图片解码(JPEG)、resize、归一化这些 CPU 活如果和 GPU 编码串行,GPU 会有肉眼可见的空泡。成熟实现用一组 CPU worker 异步预处理,pin memory 加 H2D 异步拷贝(机制见 CUDA pinned memory 传输),让「第 i 批在 GPU 上算」与「第 i+1 批在 CPU 上解码搬运」重叠。
| 批处理方式 | GEMM 利用率 | padding 浪费 | 实现复杂度 | 适用场景 |
|---|---|---|---|---|
| padding 补齐 | 中 | 高(30%~60%) | 低 | 原型、固定分辨率 |
| packing 拼接(varlen) | 高 | 近零 | 中 | 动态分辨率主流 |
| packing 加连续批调度 | 最高 | 近零 | 高 | 高 QPS 在线服务 |
三、动态分辨率:token 预算花在刀刃上
固定分辨率的 ViT(比如 CLIP 的 336×336)有一个结构性矛盾:小图被放大浪费算力,大图被缩小丢细节——一张 2000×1500 的文档照片缩到 336,字全糊了,OCR 类任务直接崩。动态分辨率的思路是让 token 数跟着图的内容需求走,主要三派:
- NaViT(Native ViT):完全按原始宽高比切 patch,不 resize,靠 packing 把不同形状的图拼进一个批。token 数与原图面积成正比,无失真、无浪费,代价是调度复杂——每批的序列组成都不同。
- 分块多尺度(tiling,LLaVA-OneVision、InternVL 路线):大图先全局缩略出一份低分辨率「概览」,再把原图切成若干 336×336 的 tile 各编一份,token 是「1 份概览加 K 份局部」。分辨率上限可控,工程上每块还是固定形状,kernel 友好。
- 原生分辨率加 2D RoPE(Qwen2-VL 路线):patch 按原图切,位置编码换成二维旋转位置编码(m-RoPE),模型直接消化任意形状的 token 网格,省掉了 tiling 的重复编码,但训练成本转移到位置编码的外推能力上。
从性能视角看,三派的分歧是「不规则性放在哪一层消化」:NaViT 放在批调度层,tiling 放在预处理层,2D RoPE 放在模型层。对推理侧工程师,选择标准很实际:批内形状方差大就用 packing 兜底,模型架构允许就优先原生分辨率。经验数字:文档理解类负载从固定 336 切到「上限 1344 的动态分辨率」,精度涨十几个点,token 成本平均涨 3~5 倍——所以动态分辨率必须配 token 预算策略,比如按请求类型设 N_max、对超预算的图先下采样再编码。

上图把三条路线的取舍摆在同一维度上:没有哪条路线在精度和成本上同时最优,工程选型本质是选「把复杂度推给哪一层」。这也解释了为什么生产系统里常见混合策略——普通请求走 tiling 保底,文档和高清图走原生分辨率通道。
四、分离部署:视觉塔和语言塔为什么要分家
ViT 编码和 LLM 解码是两种脾气完全不同的负载,放在同一个 serving 实例里会互相拖累:
| 维度 | ViT 编码侧 | LLM 解码侧 |
|---|---|---|
| 负载类型 | prefill 型,算力密集 | decode 型,带宽密集 |
| 单请求耗时 | 毫秒到几十毫秒 | 逐 token,几十毫秒一步、多步叠加 |
| 显存大头 | 激活值(N² 相关) | KV cache 与权重 |
| 批大小弹性 | 大(几十张图一批也塞得下) | 受 KV cache 容量硬约束 |
| 无状态性 | 完全无状态,随便扩缩 | 有状态(KV cache),迁移成本高 |
合并部署的痛点有三。其一,资源画像错配:decode 型 GPU 要的是大显存装 KV cache,ViT 要的是算力密度,一种机型难以两头都划算。其二,调度互相干扰:一个带 8 张大图的请求进来,ViT 编码瞬间吃掉整块 GPU 几百毫秒,同卡上 decode 请求的 TPOT(每 token 延迟)立刻抖动,SLO 直接破——这正是 chunked prefill 与 PD 分离 在纯文本场景解决过的同构问题。其三,扩缩容节奏不同:图文流量里「图」的占比波动大,ViT 容量该随图片 QPS 伸缩,LLM 容量随 token 吞吐伸缩,绑在一起只能按更贵的那个配。
分离部署(ViT 独立成服务,LLM 侧只管文本加视觉 token)成为主流方案:vLLM、SGLang 及各家自研引擎在生产环境多走这条路,更宏观的集群形态见 分离式 serving 集群。ViT 服务暴露一个「图进 token embedding 出」的 RPC 接口,内部跑 packing 批处理加连续调度;LLM 引擎收到请求后先调 ViT 服务,拿到视觉 embedding 拼进 prompt 的 embedding 序列,再走自己的 prefill/decode。
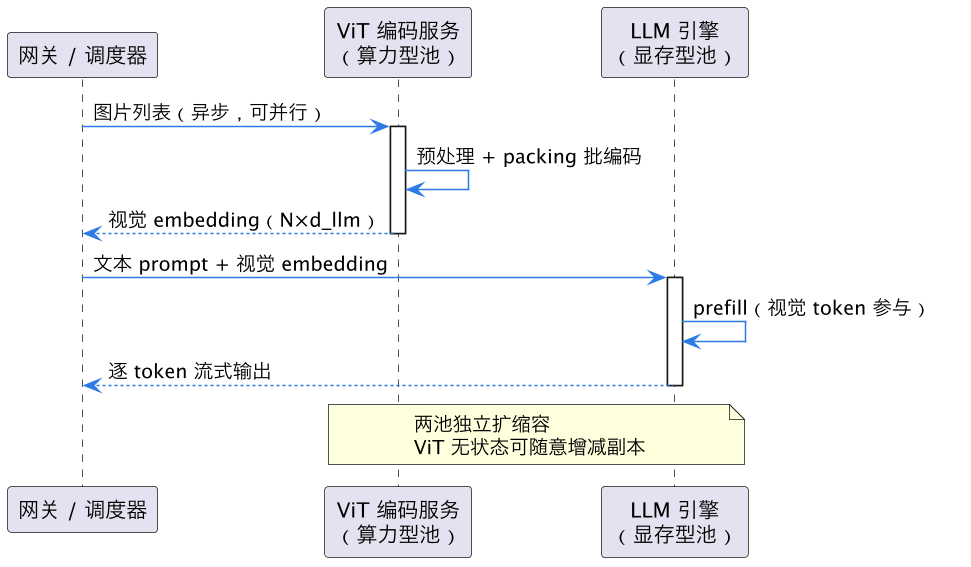
上图的时序里有个关键设计点:ViT 调用被画成独立的一段,它可以和 LLM 侧的其他请求 prefill 在时间上重叠,编码慢的图不挡 decode 的路。分离的代价是多一跳 RPC 和 embedding 传输——视觉 embedding 通常每图几百 KB 到几 MB,走 RDMA 或本机 NVLink 域内传输可以压到亚毫秒级,背景可对照 RDMA 与 GPUDirect 推理。和合并部署省下的 SLO 抖动相比,这点传输开销几乎总是划算的。
五、视觉 token 压缩:进 LLM 之前再砍一刀
即便 ViT 侧编码完毕,还有一道关口常被忽视:视觉 token 是要进 LLM 的,它们会挤占 prompt 长度、推高 prefill 成本、还占 KV cache 预算。一张原生分辨率照片编出 4000 个视觉 token,意味着每次对话 turn 的 prefill 都背着这 4000 个 token 的注意力成本——比 ViT 编码本身还贵。所以成熟方案在 ViT 和 LLM 之间加一层「视觉 token 压缩」:
- 池化/插值下采样:最简单的做法,把相邻 2×2 的 token 平均成一个,token 数直接除 4。LLaVA 系列的许多变体默认这么干,精度损失在通用问答上几乎测不出,文档小字场景会掉点。
- Q-Former / Perceiver 式重采样(resampler):用一小组可学习的查询 token 对全部视觉 token 做交叉注意力,不管输入多少 patch 都输出固定数量(比如 64 或 256)的摘要 token。BLIP-2 开创的路线,token 预算完全可控,代价是信息瓶颈——压缩比太高时细节丢失不可逆。
- token merge(ToMe):在 ViT 内部逐层把余弦相似度高的 token 合并,编码到一半序列就短了,ViT 自己的算力也省了。无需训练、即插即用,是对已有模型最友好的压缩方式。
压缩率的选择是个精度和钱包的权衡。经验区间:通用图文问答压到每图 256~576 token 性价比最高;OCR、表格、UI 理解这类细节敏感任务建议不低于 1024,或者干脆不压缩只设分辨率上限。另一个实用技巧是按层渐进压缩:浅层保持高 token 数捕捉细节,深层合并——因为深层特征语义化程度高、冗余大,合并损失小。

上图三条压缩路径可以叠加(比如先 ToMe 再池化),但要记住压缩是不可逆的信息丢弃:进 LLM 之前丢掉的小字和纹理,后面没有任何机制能找回来。所以压缩策略必须按业务负载的「细节敏感度」分级,而不是全局一刀切。
六、瓶颈定位与调优次序
补一句和第五节的衔接:token 压缩策略定下来之后,整条链路的成本模型就闭合成「分辨率决定编码算力、压缩率决定 LLM 侧成本」两个旋钮,剩下的就是工程调优。真把链路搭起来之后,性能问题大概率落在四个地方,按排查优先级排:
- 预处理拖后腿:CPU 解码 resize 跟不上,GPU 利用率曲线呈锯齿。对策是预处理 worker 池加 pin memory 异步流水,极端场景上 GPU 解码(nvJPEG)。
- 批内形状方差大:还在用 padding 方案,浪费率直接体现在算力账单上。换 packing 加 varlen 注意力,一般立刻省 30% 以上。
- token 预算失控:动态分辨率不设上限,个别大图把 batch 撑爆、显存 OOM。给 N_max 设硬顶,超了先下采样。
- 分离链路的 RPC 开销:embedding 传输走了 TCP 回环或跨机以太网。同机部署优先共享内存或 NVLink,跨机走 RDMA。
调优次序的经验法则:先让 GPU 别闲着(流水化预处理),再让 GPU 别白算(packing 消 padding),再让算力花在刀刃上(token 预算),最后才抠 kernel 和通信。ViT 侧的 kernel 级优化(算子融合、FP8 编码)收益通常排在这些结构性优化之后——当然,如果模型支持,把 ViT 量化到 FP8 或 INT8 是最后一档稳定的加速,方法学与 混合精度 FP16/BF16/FP8 一致,视觉塔对量化的鲁棒性普遍比 LLM 好。
这一篇在知识体系里的位置
本篇是「多模态推理」线索的基础一环:上游依赖 FlashAttention 显存分块 tiling(ViT 与 LLM 共用的注意力 kernel 基础)和 LLM serving 的 TTFT/TPOT 与 SLO(服务指标体系);同层可对照 chunked prefill 与 PD 分离(文本侧的同构分离思想)、continuous batching 调度器(批调度机制本身)与 分离式 serving 集群(集群形态);下游延伸是视频理解的多帧 ViT 批处理、视觉 token 压缩(token merge/剪枝)与端到端多模态 SLO 规划。
总结
ViT 编码器推理的全部性能学问都绕着「token 数等于(高÷patch)乘(宽÷patch)、注意力成本随其平方增长」这条铁律展开:patch 批处理用 packing 加 varlen 注意力把不规则的视觉负载拼成规整 GEMM,消灭 padding 浪费;动态分辨率让 token 预算跟着图的内容需求走,用调度或模型层的复杂度换精度;而与 LLM 解码侧的分离部署则承认两种负载画像天生不同——算力密集的编码池和带宽密集的解码池各自扩缩、互不拖 SLO 的后腿,中间用一跳廉价的高速传输交接视觉 embedding。