流水线 ADC 数字校准:级间增益与比较器阈值误差的后台修正
更新时间:2026-10-05。流水线 ADC 想在 12~16 位分辨率上跑到几百 MSPS,靠模拟电路本身的匹配是做不到的——0.1% 的电容失配就足以把 14 位的理想精度打回 8 位。真正让高精度流水线 ADC 在 CMOS 工艺上成立的,是流水线 ADC 数字校准(digital calibration):在数字域实时估计级间增益误差和比较器阈值误差,再从输出码里把它们减掉。本篇与 流水线 ADC 多级结构原理 互补(那篇讲结构与冗余,本篇深挖误差与校准),级间缩放对误差预算的影响见 流水线 ADC 级间缩放设计,SAR 子级的电容失配校准思路则见 SAR ADC CDAC 失配校准。
本文要回答的问题
- 流水线 ADC 里级间增益误差和比较器阈值误差分别从哪里来,各把精度打坏多少?
- 为什么数字校准能「不修模拟电路」却把误差消掉,它的基本思想是什么?
- 相关注入法(伪随机噪声注入)怎么在不停机的前提下把级增益误差估计出来?
- 统计法不注入任何信号,凭什么也能收敛到校准系数?
- 校准收敛前后,SNDR、SFDR、ENOB 到底提升多少,收敛时间要多久?
一、误差的两个主角:级间增益误差与比较器阈值误差
先回顾流水线级的工作节拍:每一级先用子 ADC(几个比较器)对输入粗量化出 2~3 位,DAC 把量化结果变回模拟量并从输入中减掉得到残差,残差放大器把残差放大 2^k 倍交给下一级。整条链的传递函数建立在两个假设上:残差增益恰好是 2^k、比较器阈值恰好落在设计位置。这两个假设在真实硅片上都站不住。
级间增益误差(inter-stage gain error)有两个来源。一是电容失配:残差增益由采样电容与反馈电容的比值决定,现代工艺的电容匹配精度约 0.05%~0.1%,看似很小,但第一级增益误差会直接乘进后级所有码的权重里——第一级增益偏 0.5%,等效于第一位判决的分界线偏了满量程的 0.5%,折合 14 位满量程约 100 个 LSB。二是运放有限增益:开环增益 A 只有 60 dB 时,闭环增益相对理想值偏差约 1/A ≈ 0.1%,而且运放增益随输入摆幅非线性变化,引入的不仅是线性误差还有谐波失真。
比较器阈值误差(comparator threshold error)则是比较器失调电压(offset)造成的。好在流水线级有冗余位设计(比如 1.5 位/级结构自带 0.5 位冗余),只要阈值偏移不超过冗余范围,数字冗余纠错(digital error correction)能自动吸收,这是流水线结构的「免费保险」。但保险有额度:失调超过冗余范围、或者多级误差沿链累积,保险就会赔穿。真正没有保险可吃的是级间增益误差——冗余纠错对模拟增益偏了这件事完全无能为力,这正是数字校准的主战场。
这张图把两类误差的注入点画清楚了:阈值误差打在子 ADC 上,有冗余兜底;增益误差打在残差放大器上,没有兜底,只能靠校准。校准的思路也随之分成两条:阈值误差靠结构冗余「事前防御」,增益误差靠数字估计「事后补偿」。设计时两边的预算怎么分,参见 流水线 ADC 级间缩放设计 里的每级位数与缩放取舍。
| 误差类型 | 物理来源 | 典型量级 | 无校准时影响 | 冗余纠错能否吸收 |
|---|---|---|---|---|
| 级间增益误差(线性) | 电容失配 | 0.05%~0.5% | 首级即毁掉 3~5 位精度 | 不能 |
| 级间增益误差(非线性) | 运放增益随摆幅变化 | 随摆幅 | SFDR 恶化 20 dB 以上 | 不能 |
| 比较器阈值误差 | 比较器失调 | 几 mV ~ 几十 mV | 超冗余范围时产生 sparkle 码 | 冗余范围内可以 |
| DAC 元件失配 | 单位电容失配 | 0.05%~0.1% | 等效为额外增益与阈值误差 | 部分,靠校准一并收编 |
二、数字校准的基本思想:测出误差、反向销账
数字校准的核心观察是:流水线 ADC 的数字输出是各级数字码按「理想权重」拼接的,而真实权重偏了。如果我们能用某种办法测出真实的级间增益 G_actual,把后级码除以 G_actual 再拼接,误差就被数字域精确销账——模拟电路一个管子都不用动。
这就引出校准的两个模式。前台校准(foreground calibration):芯片上电时停下正常转换,注入已知信号测误差系数,存进寄存器,然后才开始干活。优点是算法简单、估计准;缺点是停机,而且温度、电压漂移后系数就过期了,得定期打断业务重新校准——通信系统里这往往不可接受。后台校准(background calibration):不打断正常转换,一边采信号一边在数字域持续估计误差、更新系数,温度和老化漂移被自动跟踪。高精度流水线 ADC 的主流做法是前台给个初值、后台持续跟踪,本篇重点讲后台校准的两条主流路线:相关注入法与统计法。
注意图中反馈环的方向:估计器吃的是原始码(有的结构还吃注入序列),吐出的是系数;校准引擎用系数修正原始码得到最终输出。整个环路的收敛速度、稳态抖动、对输入信号的依赖,就是两类算法分高下的战场。
三、相关注入法:往信号里掺一勺伪随机噪声
相关注入法(correlation-based calibration)最经典的形态是伪随机噪声注入(PN injection)。做法是在第一级(或前几级)的残差路径里,用 DAC 注入一个幅度已知、极性随机的伪随机序列 PN(取值 ±Δ,与输入信号统计独立)。这个 PN 序列会经历与信号残差完全相同的级间增益 G_actual,被后级量化后混在数字码里。
数字域手里攥着同一份 PN 序列的副本,只要拿后级输出码与 PN 做相关运算(相乘再累加平均),信号成分因为与 PN 不相关而被平均掉,留下的就是 Δ × G_actual——真实的级间增益被「相关」这把筛子从信号里滤了出来。估计值与目标值之差送进 LMS(最小均方)迭代器,按固定步长一点点修正校准系数,直到误差收敛到噪声地板以下。三阶以上的运放非线性也可以用同样思路:注入 PN 后再对 PN 的高次项做相关,把非线性系数一并估出来。
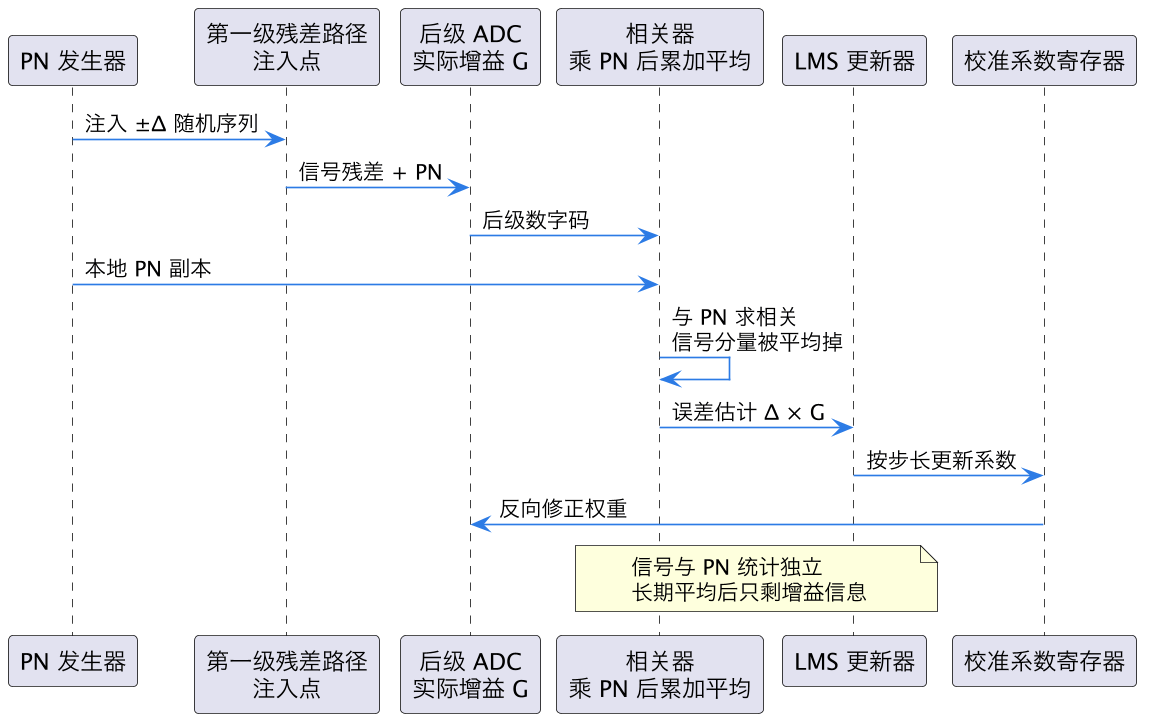
相关注入法的优点非常硬:估计不依赖输入信号的统计特性,直流、正弦、满摆幅随机信号下都能收敛;数学上就是自适应滤波,收敛行为可分析、步长可调。代价也不含糊:注入的 PN 占用了残差放大器的摆幅余量,信号摆幅得让出几个百分点;相关累加要有足够长的平均窗口,收敛时间通常在数百万到上千万个采样点量级——几百 MSPS 的 ADC 折算下来是几十毫秒量级,上电瞬间用户基本无感,但对突发式工作的系统(比如时分复用接收机)就要掂量。
工程上还有几个细节决定成败:PN 幅度 Δ 太小则相关信噪比不够、收敛慢,太大则挤压信号摆幅,典型取残差满量程的 1/16~1/8;多级要校准时从后往前校(先校增益误差最小的后级,再逐级前推),否则前级校准会把未校准的后级误差「学」进自己的系数里。
四、统计法:不注入任何东西,从信号自身学出误差
统计法(statistics-based calibration)走另一条路:什么都不注入,纯粹观察正常转换产生的数字码流,利用信号的统计规律反推误差。它的前提是输入信号足够「丰富」——残差信号在满量程内近似均匀分布,这是大多数通信和仪器信号天然满足的。
最有代表性的一类做法基于跨级一致性:理想情况下,前级量化码加后级残差码按权重 2^k 重构出的值,应该让残差统计特性满足某种不变性(比如残差落在冗余纠错区间内、残差直方图没有断裂)。当级间增益偏了,重构就会出现系统性的「接缝」——残差码在某些取值附近出现异常密集或稀疏的堆积,接缝的位置和形状就是增益误差的指纹。统计引擎持续累计这些统计量,用 LMS 或查表方式把系数往消除接缝的方向推。
统计法的卖点是「零侵入」:不注信号、不占摆幅、不改模拟设计,模拟核可以当作黑盒。它特别适合工艺移植时快速加一个校准层。短板也很现实:收敛依赖输入信号的统计特性,输入若是长时间直流或低活动率信号,统计量不更新,系数就停在那儿甚至漂移;收敛速度通常比相关注入法慢一个量级,且理论分析更依赖信号模型。实际芯片里两种方法常常混搭:前几级增益误差大、对摆幅不敏感,用相关注入法快速收敛;后级误差小、注入不划算,用统计法慢慢磨。
| 维度 | 相关注入法(PN 注入) | 统计法 |
|---|---|---|
| 是否注入信号 | 注入 ±Δ 伪随机序列 | 不注入 |
| 对输入信号要求 | 无要求,直流也能收敛 | 要求残差近似均匀、信号足够活跃 |
| 摆幅代价 | 占用残差余量约 6%~12% | 零 |
| 收敛速度 | 10^6~10^7 采样点 | 10^7~10^8 采样点 |
| 可分析性 | 自适应滤波框架,收敛可证明 | 依赖信号模型,分析较松 |
| 典型应用 | 前 1~3 级主校准 | 后级微调、黑盒模拟核 |
五、校准收敛后,性能到底提升多少
数字校准不是锦上添花,是这类 ADC 能否成立的生死线。给一组 14 位、250 MSPS 流水线 ADC 的典型量级(工艺电容匹配 0.1% 上下,运放增益 60~70 dB):未校准时第一级 0.3% 的增益误差会把 SNDR 压到 55 dB 附近,ENOB 不足 9 位,SFDR 被增益失配产生的杂散卡在 60 dBc 上下;数字校准收敛后,SNDR 回到 70 dB 以上,ENOB 恢复到 11.5 位左右,SFDR 改善 20~30 dB,逼近热噪声与采样时钟抖动设定的天花板。也就是说,校准把精度「救回」了 2.5~3 个有效位——等效于模拟匹配精度被凭空拔高了一个量级,这是任何版图对称技巧都做不到的。
收敛过程的管理本身就是设计的一部分。上电用大步长追速度,稳态切小步长压抖动——步长直接决定系数噪声,系数噪声会直接变成输出噪声。温度每漂 10 ℃,级间增益大约漂几十 ppm,后台跟踪环必须跟得上这个斜率,否则校准系数反而成了误差源。验证手段上,频谱是看校准效果最直观的尺子:校准前由增益误差产生的杂散谱线(落在与输入相关的确定位置)在收敛后应沉入噪声底,这套测试方法与 ADC FFT 测试平台搭建 完全通用,最终指标口径见 ADC SNR、SNDR 与 ENOB 指标。
还要提醒一个常被忽视的边界:数字校准修正的是「可建模」的误差——线性增益误差、低阶非线性、固定阈值偏移。它修不了热噪声、时钟抖动、以及随时间随机漂移的 1/f 成分。校准收敛后剩下的性能天花板,由这些不可校准项决定,这也是为什么高精度 ADC 最后总在时钟与基准电压上烧钱。
这一篇在知识体系里的位置
本篇属于芯片设计中级篇里数据转换器专题的一环。结构基础在 流水线 ADC 多级结构原理,误差预算的分配在 流水线 ADC 级间缩放设计;同样是「失配 + 数字校准」的套路,SAR 阵营的做法见 SAR ADC CDAC 失配校准,两者对照看能体会「校准思路相通、注入点与可观测量不同」。校准效果的测量落地到 ADC FFT 测试平台搭建 与 ADC DNL/INL 直方图测试,指标口径统一在 ADC SNR、SNDR 与 ENOB 指标。
总结
流水线 ADC 的高精度不是模拟电路做出来的,是数字校准救回来的:电容失配与运放有限增益造成级间增益误差、比较器失调造成阈值误差,前者靠相关注入法(掺入伪随机噪声再相关筛出真实增益)或统计法(从正常码流的残差直方图接缝反推误差)在后台持续估计并数字销账,后者靠前级冗余位免费吸收;校准收敛后 SNDR 提升 15 dB 以上、ENOB 多回 2.5~3 位,代价只是注入序列占几个百分点的摆幅和毫秒级的收敛时间。