块 RAM 与分布式 RAM:FPGA 两种片上存储的资源来源、时序差异与选型判据
在 FPGA 设计里写一个存储器数组,综合器面前通常有两种物理归宿:一种是芯片上预先做好的专用存储硬宏,Xilinx 称之为块 RAM(Block RAM,简称 BRAM);另一种是把实现组合逻辑的查找表(LUT)临时改造成存储位,称为分布式 RAM(distributed RAM,也叫 LUT RAM)。两者都能存放数据,成本结构却完全不同——选错了,轻则一块 BRAM 被几十位的小表占掉,重则几千个 LUT 被深 FIFO 吃光,逻辑布局无家可归。
存储推断:RTL 怎么写才会被综合成 BRAM/SRAM 而不是一堆触发器解决的是「代码怎么写,综合器才认得出这是一块 RAM」的问题,落点在推断规则与可综合模板;本篇解决它的上游问题:在动手写代码之前,先想清楚这块存储应该落到哪类物理资源上。底层的硅基存储结构、六管 SRAM 单元与灵敏放大器的工作原理,在片上存储器:SRAM、ROM 与存储阵列与 SRAM 单元与灵敏放大器里有完整展开,本篇只引用结论,不再重复晶体管层面的机理。
本文要回答的问题
- 块 RAM 与分布式 RAM 在芯片上分别是用什么物理资源实现的?为什么说一种是「专用硬宏」,另一种是「逻辑资源改造」?
- 同样一次读操作,两者的延迟时钟周期数为什么不同?异步读与同步读的时序代价各落在哪里?
- 容量增大时,两种方案的资源成本分别按什么斜率增长?什么量级是它们的盈亏平衡点?
- FIFO、常量查找表、小缓存、移位寄存器(行缓存)这四类最常见的存储需求,各自的判定依据是什么?
- 把一个深 FIFO 硬拼成分布式 RAM,到底会吃掉多少 LUT?能不能用器件数据手册的参数算出量级?
下面这张对比卡先把两种资源的关键差异并排放好,全篇后续章节就是把这张表里的每一行展开讲透。
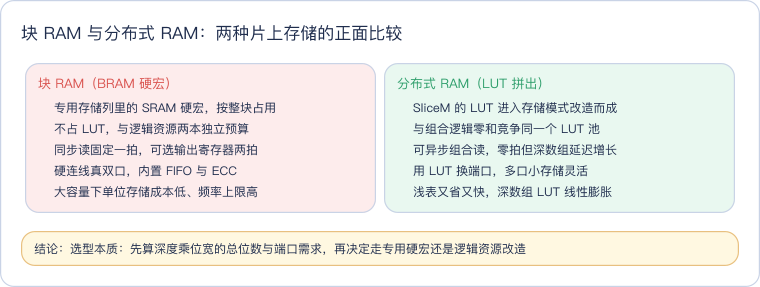
读这张对比卡按行对位:左栏红色块 RAM 的每一条都在讲「专用硬宏的固定标价」,右栏绿色分布式 RAM 的每一条都在讲「LUT 改造的弹性与代价」;两栏的差异从资源来源一路延伸到时序、端口与容量成本,末尾的结论给出全篇统一的判定入口。
一、两种 RAM 从哪来:专用硬宏与 LUT 改造
理解选型的第一步,是看清 FPGA 芯片上这两类资源的物理布局。现代 FPGA 的纸面资源表里,逻辑单元(LUT、触发器)和存储块是分列统计的,因为它们本来就是两片独立的硅片资源。
块 RAM 是芯片制造时就排布好的一块块完整 SRAM 宏,以 Xilinx 7 系列为例,每块容量为 36 Kb,可以整块使用,也可以拆成两个独立的 18 Kb 小块;宏内部自带地址译码、读写驱动、可选输出寄存器,以及真双口、ECC 校验、内置 FIFO 控制等硬连线功能。它在芯片上占据固定的物理列,与逻辑单元分开排布,通过专用布线通道接入互连矩阵。使用一块 BRAM,意味着从器件那一行存储资源里划走一块,LUT 和触发器的账面数字分毫不动。
分布式 RAM 则没有独立的物理身躯。FPGA 中一部分特殊切片(7 系列里称 SliceM,约占全部切片的一半;其余为只能做逻辑的 SliceL)里的 LUT 除了实现组合函数,还能进入存储模式:一个六输入 LUT 本身就是一张 64 位的小表,既可以当 64×1 的 ROM/RAM,也可以级联成更宽或更深的结构。所谓分布式 RAM,就是把这些本该做逻辑的 LUT 挪用为存储单元,再配上触发器和多路选择器完成读写控制。它的物理分布是「撒」在逻辑阵列各处的,因此得名分布式。
读图抓住资源边界这条主线:左侧逻辑阵列里,只有 SliceM 的 LUT 能改造成分布式 RAM,这部分 LUT 同时也是实现组合逻辑的原料,存储与逻辑在此零和竞争;右侧专用存储列里的 BRAM 是独立硬宏,再大的数组只要落进 BRAM,就不向逻辑阵列伸手。数据手册对两类资源分别给出总量,这是两本独立预算,后面的选型算账都在它们之间做权衡。
二、微观结构:一个 LUT 怎么变成 64 位存储器
LUT 实现组合函数的本质,就是用输入当地址去查一张存着真值表的小 SRAM。六输入 LUT 内部恰好是 64 个存储位,因此「做逻辑」和「做存储」对它来说是同一种结构的两种用法:让综合工具把这 64 位当作可写数组,它就成了深度 64、位宽 1 的单口分布式 RAM;两个 LUT 配对,可以实现深度 32 的简单双口。需要更深的数组时,工具把多个 LUT 堆叠,再用内部多路选择器逐级选通——深度每翻一倍,地址通路上的多路选择器就多一级。
这条堆叠路径直接解释了分布式 RAM 的时序特征。它的读可以是异步的:地址一变,数据经过 LUT 与级联多路选择器的传播延迟后直接出现在输出端,不需要时钟沿,风格上就是连续赋值语句读取数组。浅数组时这条路径很短,延迟与一级普通逻辑相当;但深度做到几千项时,级联多路选择器拉成长链,读路径延迟随深度对数级增长,且挤占的是与普通逻辑共用的通用布线,频率代价越来越显眼。
块 RAM 走的是另一条路。它是成熟的 SRAM 宏,内部存储阵列、译码器、灵敏放大器与输出锁存一应俱全,读操作固定为同步方式:时钟沿采样地址,下一个时钟沿之前数据出现在输出端,基础延迟一拍;打开内置输出寄存器再打一拍,可以把宏到布线的时序切断,换来更高的工作频率,代价是总共两拍延迟。无论存 1 Kb 还是 36 Kb,宏内部的读路径延迟基本恒定,不随容量增长——这是专用硬宏相对于 LUT 堆叠最本质的优势。

读这张图对照两端的延迟记账方式:左边分布式路线的延迟「藏」在级联 MUX 和通用布线上,数组越浅越划算,越深越亏;右边块 RAM 路线的延迟是宏的固定标价,一拍或两拍,与容量无关。两种结构也决定了推断风格——组合读的写法对应分布式 RAM,时钟沿内同步读的写法才可能被推断为 BRAM,具体的可综合模板与复位禁忌在存储推断中逐条讲过,这里只给最小对照:
// 分布式 RAM 风格:读为组合逻辑,地址变输出立即变
assign dout = mem[raddr];

// 块 RAM 风格:读在时钟沿内,输出延迟一拍
always @(posedge clk) begin
  dout <= mem[raddr];
end
这两段说明推断风格与物理结构的对应关系,不是实测结论;工程上以具体器件的综合报告为准。
三、容量、时序与端口:六个维度的硬差异
把结构差异翻译成工程语言,六个维度对照如下。器件级参数为厂商数据手册的典型规格,实际以目标器件手册为准。
| 对比维度 | 块 RAM(BRAM 硬宏) | 分布式 RAM(LUT RAM) |
|---|---|---|
| 物理资源 | 专用存储列中的 SRAM 宏,按整块占用 | SliceM 中的 LUT,与组合逻辑共享预算 |
| 最小粒度 | 7 系列最小配置为 18 Kb 半块 | 单个 LUT6 即 64×1,两位宽起拼 |
| 读时序 | 同步读,固定一拍;输出寄存器再打一拍 | 可异步组合读,零拍;深数组延迟随 MUX 级联增长 |
| 频率特征 | 专用布线,路径延迟与容量无关,fmax 高 | 占用通用布线,大容量时频率明显下滑 |
| 端口能力 | 硬连线真双口,内置 FIFO/ECC/字节使能 | 端口靠 LUT 与 MUX 拼,多口灵活但每口都花资源 |
| 功耗特征 | 未使能的块可时钟关断,大容量下能效高 | 小数组功耗低;大数组地址译码翻转面大、布线功耗上升 |
表里有两条需要单独点透。其一是端口:BRAM 的双口是硅片上白送的,三口以上则无能为力;分布式 RAM 每增加一个读口本质上是再复制一份 LUT 查表结构,用 LUT 换端口,寄存器堆这类多口小存储天然倾向分布式,寄存器堆设计给的正是这类行为模型。其二是最小粒度的浪费:百余位的小表放进 18 Kb 半块,利用率不足百分之一;小器件的 BRAM 往往只有几十块,被零碎小表占满后,真正需要大块存储的 FIFO 反而无块可用。
四、量级算例:拼一个 4K×32 的 FIFO 要吃掉多少 LUT
选型判据不能只停留在定性层面,下面用厂商数据手册参数做两笔量级账。示例器件取入门级 FPGA:约 20,800 个 LUT、50 个 36 Kb BRAM(合计约 1.8 Mb),SliceM 约占切片总数一半,均为数据手册示例口径,演示算账方法,不针对具体工程。
第一个例子,深度 4096、位宽 32 的 FIFO,总存储位数是 4096×32 = 131,072 位。
走块 RAM:131,072 ÷ 36,864 ≈ 3.55,向上取整占用 4 个 36 Kb 块(按 1K×32 一类配置排布),占器件 50 个块的 8%,LUT 预算几乎不动,FIFO 的指针与空满标志只花少量逻辑。
走分布式 RAM:仅存储体就需要 131,072 ÷ 64 = 2,048 个 LUT6,占全器件 LUT 的约 9.8%,而且这些 LUT 必须全部落在 SliceM——按一半切片估算,相当于一口气抽走全器件可存储化 LUT 的近五分之一;这还没算写地址译码、读口级联 MUX、FIFO 指针与空满比较的额外开销,实际占用更高。同容量下两种方案的账面差距是「4 个存储块」对「两千多个 LUT」,这就是深存储必须进 BRAM 的量化理由。FIFO 深度本身该怎么按突发与读写速率计算,见 FIFO 深度设计:突发、带宽与空满裕量,本篇不重复深度推导,只讨论深度定下来之后的资源归宿。
第二个例子反过来,一张 16×8 的系数查找表,总共 128 位。走分布式 RAM 只需 2 个 LUT6,嵌在逻辑阵列里,读口零拍延迟;若放进 BRAM,最小也要占一个 18 Kb 半块,利用率 128 ÷ 18,432 ≈ 0.7%,还要付一拍同步读延迟。小表进 BRAM 是资源与时序的双重浪费。
两个算例合起来给出盈亏平衡的直觉:千位以内、尤其需要异步读或多口的存储,分布式 RAM 又省又快;总位数上万且对频率敏感的存储,块 RAM 是唯一理性选择。中间地带(几千位、一两百深度)结合资源余量与端口需求判断,必要时让同一 RTL 按两种目标各综合一次,对比资源报告再拍板。
五、四类典型场景的选型判据
工程中绝大多数存储需求可归入下表四类,每类给出首选、例外与理由。
| 场景 | 典型形态 | 首选资源 | 例外与判据 |
|---|---|---|---|
| 数据 FIFO | 跨时钟域缓冲、突发吸收 | 块 RAM | 深度极浅(几十项)且需要异步读时可用分布式;内置 FIFO 控制器是 BRAM 的硬连线红利 |
| 常量/系数查找表 | 三角函数表、协议字段译码、小状态表 | 分布式 RAM 或 ROM | 表容量逼近单个 BRAM 半块、且系统里 BRAM 余量充足时可整块化;百余位的小表严禁占 BRAM |
| 小缓存/寄存器堆 | CPU 寄存器堆、多口临时缓存 | 分布式 RAM | 多口需求是决定性理由:BRAM 只有两个口,分布式可用 LUT 换端口 |
| 移位寄存器/行缓存 | 视频行延迟、卷积窗、串行延迟线 | 浅延迟用 LUT 移位模式,深行缓存用 BRAM | LUT 可直接配成移位寄存器(SRL)省掉触发器;整帧缓存等深度上千的延迟线走 BRAM |
移位寄存器这一行值得展开。SliceM 的 LUT 还有移位寄存器模式,一个 LUT6 可承担最多 32 拍可编程延迟,地址线直接充当抽头选择(行为模型见移位寄存器的应用与变体);用触发器拼 32 拍延迟要 32 个 FF,用 SRL 只要一个 LUT。但视频一行往往上千像素,行缓存越过万位关口后账就翻到 BRAM 一侧——SRL 适合短延迟与可变抽头,长延迟线归 BRAM,判据仍是总位数与资源余量。
把四类场景的判定过程收成一张流程图,颜色按角色区分:红色是需求入口,蓝色是两个判定动作,绿色与橙色是两类资源归宿,紫色是需要出报告复核的中间地带。
读图注意判定顺序:先问端口与读模式,因为这是硬约束——需要三口或异步读的存储,BRAM 在结构上就给不了;容量判定回答「量」的问题;紫色复核节点只收容两个判据都不极端的中间地带,用两份综合报告终结争论,而不是凭感觉下注。异步 FIFO 这类跨时钟域场景的完整资源对照实例,可参考 异步 FIFO 综合资源分析。
六、边界、反例与术语对照
先说一个最常见的反模式:仅凭「分布式 RAM 读起来零拍、时序好看」的局部印象,把深度 2048、位宽 16 的 FIFO 也写成组合读风格。32,768 位存储体需要 512 个 LUT6 且全部锁死在 SliceM 上,读口级联 MUX 在地址路径拖出长链,很可能成为新的关键路径,迫使整模块降频;同样的存储进 BRAM 只占一个 36 Kb 块,读路径是固定一拍的宏内延迟,时序干净。零拍优势只在浅数组成立,忽视深度门槛就是把优点用成了陷阱。
第二点是术语的厂商边界。块 RAM 与分布式 RAM 是 Xilinx 体系的叫法;Intel(Altera)体系里对应的专用硬宏是 M9K、M20K,分布式存储称 MLAB,叫法不同而选型逻辑一致。这套术语只属于 FPGA 语境:ASIC 中没有 LUT,对照物是 SRAM compiler 生成的存储宏与标准单元寄存器堆,推断规则可沿用存储推断中 ASIC 一侧的说明。
第三点,选型只决定资源归宿,不能替代推断纪律。选定 BRAM 后代码仍须遵守同步读、不加复位等推断要求,否则综合器会悄悄退回触发器;选定分布式 RAM 时也要核对综合报告,确认 LUT 进入存储模式而非展开成大量 FF。选型与推断是前后两道工序,缺一不可。
最后把全篇知识收成一张思维导图,复习时沿五条支路回忆。
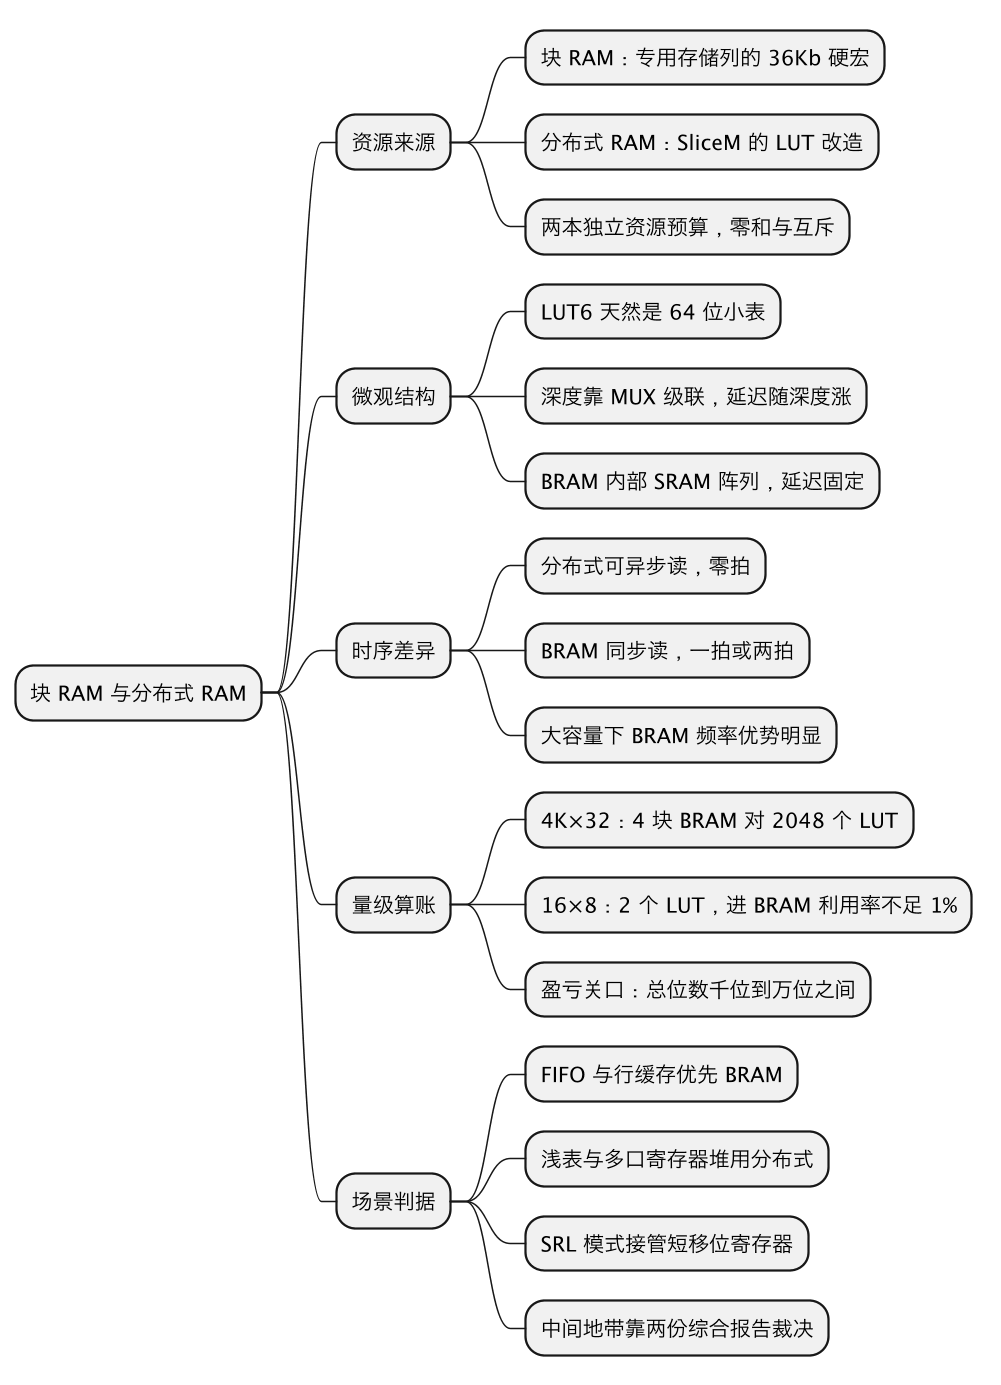
这棵树的第一层按「推理环节」切分而不是按器件罗列:资源来源回答存储从哪来,微观结构回答成本为何这样增长,时序与算账给出可计算的判据,场景支路把判据落到 FIFO、查找表、缓存与移位寄存器四类具体需求上。
这一篇在知识体系里的位置
本篇属于芯片设计入门层的 FPGA 资源与设计选型主题。向上承接存储原理:片上存储器:SRAM、ROM 与存储阵列给出片上存储的分类与阵列结构,SRAM 单元与灵敏放大器解释 BRAM 宏内部的晶体管级机理。向下游对接两篇工程方法文:存储推断:RTL 怎么写才会被综合成 BRAM/SRAM 而不是一堆触发器承接「选定资源之后怎么让综合器听话」,FIFO 深度设计:突发、带宽与空满裕量承接「FIFO 该做多深」的定量推导。同簇的结构设计篇还有寄存器堆设计与移位寄存器的应用与变体,分别对应多口小存储与延迟线两个典型分布式场景;真实 FIFO 的资源对账实例见 异步 FIFO 综合资源分析。
总结
块 RAM 与分布式 RAM 的全部选型逻辑可以收成一条链:FPGA 上有两本独立的存储预算,块 RAM 是专用存储列里的 SRAM 硬宏(7 系列单块 36 Kb、可拆两个 18 Kb),不碰逻辑资源,分布式 RAM 是把 SliceM 中本可做组合逻辑的 LUT 改造成存储位(一个 LUT6 即 64×1),与逻辑零和竞争;结构差异决定时序差异,分布式 RAM 可异步组合读、浅数组零拍且端口灵活,但深度靠 MUX 级联、延迟随容量增长并占用通用布线,块 RAM 固定同步读一拍、开输出寄存器两拍,延迟与容量无关且频率上限高;量级算账给出盈亏关口,同样 13 万位的 4K×32 FIFO,块 RAM 只需 4 个存储块,分布式 RAM 仅存储体就要 2048 个 LUT、占入门器件 LUT 总量近一成且全部锁死在 SliceM,而 128 位的 16×8 小表只用 2 个 LUT、进 BRAM 则利用率不足 1%;场景判据随之明确,深 FIFO 与上千像素的行缓存优先块 RAM,浅查找表、多口寄存器堆与短移位寄存器(SRL 模式)优先分布式 RAM,三口以上或异步读是分布式的硬约束场景,总位数上万或频率吃紧是块 RAM 的强制场景,介于其间的中间地带用同一 RTL 各综合一次、对比资源报告与时序再裁决;最后记住术语边界,Intel 体系对应 M20K 与 MLAB,ASIC 没有 LUT、对照物是 SRAM 宏与标准单元寄存器堆,而资源选型之后仍须遵守同步读、不加复位等推断纪律,并以综合报告确认存储真正落到了预期资源上。