宏单元摆放:floorplan 阶段 macro 摆位准则、flyline 分析与光晕拥塞预防
更新时间:2026-10-02。物理实现这条流水线上,有一种错误最贵:floorplan 阶段随手一摆的 macro,到 route 阶段才发现绕线绕不动,回头的代价是整个布局推倒重来。本站 数据流 S3:floorplan 与 place 讲过 floorplan 在流程里的位置,Floorplan 与 Powerplan 讲了供电网络的规划,电压域与 floorplan 讲了多电压场景。这一篇聚焦其中一个具体而高频的手艺活——宏单元摆放:SRAM、PLL、ADC、接口硬核这些大块头往哪儿放、怎么判断放得好不好、放砸了会怎样。macro 数量通常只有几十到几百个,却决定了标准单元能用的通道、绕线的长度上限和供电的压降分布,是物理设计里「少量决策撬动全局质量」的典型。
本文要回答的问题
- 宏单元摆放为什么必须在标准单元之前定案,它锁定了哪些后续不可逆的资源?
- flyline(飞线)分析到底在看什么,怎么用它判断一组 macro 摆位是否合理?
- 边界对齐、通道预留、pin 朝向这些摆位准则背后的物理原因是什么?
- 光晕(halo)和 placement blockage 各管什么,配多宽合适?
- macro 摆位引发的拥塞长什么样,怎么在 floorplan 阶段提前预防而不是等 route 报红?
一、macro 为什么先摆:不可逆资源的锁定顺序
一个 SoC 里的宏单元主要有几类:存储器(SRAM、ROM、register file 编译器产物,通常占芯片面积三到六成)、模拟硬核(PLL、ADC/DAC、LDO、bandgap)、接口 PHY(SerDes、DDR PHY、USB PHY)、以及大型数字子模块(在层次化设计里作为 hard macro 出现的整块 partition,见 层次化 STA 与 block 接口)。它们和标准单元的区别在于:标准单元只有几微米宽,工具可以在几百万个候选位置里微调;macro 动辄几百微米见方,位置的可行域极小,而且一旦定案,周围的布线通道、供电走线、时钟树走向全部跟着定型。
把顺序想反了就明白为什么必须先摆 macro:假设先放标准单元,400 块 SRAM 后进来,它们之间要保持特定的相对关系(同类 memory 常要聚簇方便 BIST 接线),要避开压降热点,pin 要朝向使用它的逻辑——这些约束同时满足的可行区域往往只剩几处,而那里已经长满了标准单元。所以工业流程的共识是:die 尺寸和 IO/bump 定案后(flip-chip 场景见 Bump 与 RDL 规划),第一件布局动作就是 macro 摆放,之后才轮到标准单元的全局 placement。
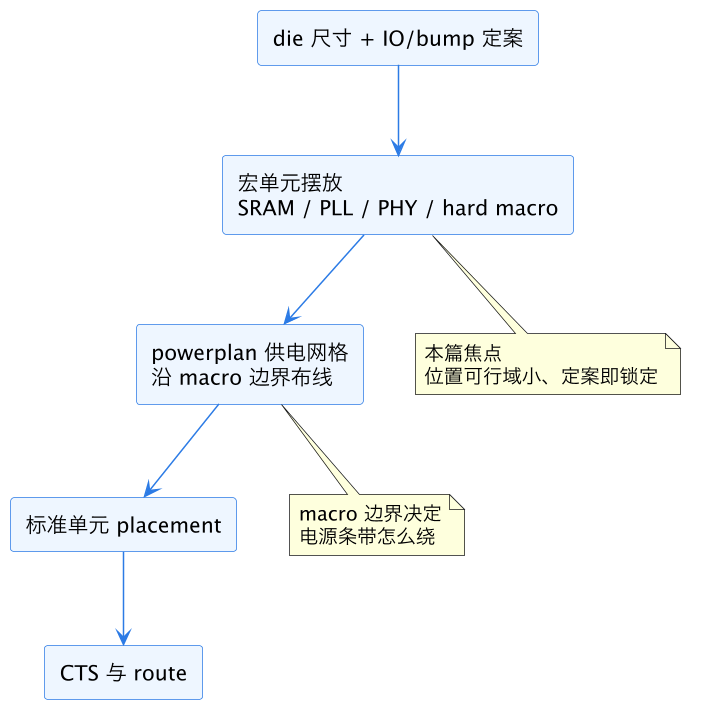
这张图的重点是箭头方向:每一步都消费上一步留下的资源。macro 摆放消费的是「整块空白 die」,它产出的不只是 macro 坐标,还包括留给标准单元的可用面积形状、留给绕线的通道拓扑、留给供电网格的走线走廊。下游任何一环报问题,回溯的终点经常就是这张 macro 摆位图。
还有一个项目管理视角的事实:macro 摆位是 floorplan 评审里唯一能在半天内靠人力完成的动作(几百个对象,人可以逐个看),也是 IP 提供商、封装、模拟团队唯一能参与讨论的物理设计环节。所以它天然是跨团队对齐的锚点——这也是为什么它的「对错」标准不只是工具 QoR,还包括各团队签字的接口契约,交接纪律见 数据流 X1:handoff 契约。
二、flyline 分析:macro 摆位的指南针
macro 摆位的第一手判据不是时序报告(那时还没有真实走线),而是 flyline——把网表里每个 macro pin 与其连接对象用直线连起来形成的「飞线图」。它假设所有连线走曼哈顿最短路径,是绕线需求的零阶近似。摆放前看 flyline,本质上是在问:这些大块头之间的逻辑亲缘关系,要求它们彼此多近?
读 flyline 有三个层次。第一层是密度:flyline 越密集的区域,说明穿越该区域的逻辑连接越多,如果那里正好被一块大 macro 挡住,绕线就必须绕行,detour 直接转化为时序恶化和拥塞。理想摆位让 flyline 密集区落在开阔的标准单元区上空,而不是横跨 macro。第二层是长度分布:几条特别长的 flyline 往往暴露「亲缘模块被拆散」的问题——比如某块 SRAM 服务的逻辑 cluster 在芯片另一头,这条长线日后就是一条需要 pipeline 寄存器救场的关键路径。第三层是聚簇形态:同一接口协议(比如一组 DDR 地址/数据/时钟信号)的 flyline 应当收束成整齐的「电缆束」,如果呈扇形散开,说明 macro 的 pin 朝向或相对位置有问题。
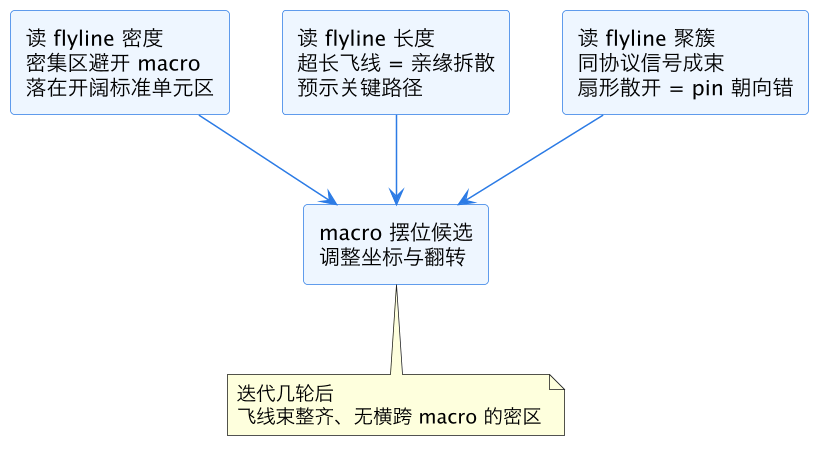
图上三种读法对应三种典型修改动作:密度问题移动 macro 让出走廊,长度问题把亲缘 macro 拉近,聚簇问题旋转或翻转 macro 改 pin 朝向(macro 通常支持 R0/R90/R180/R270 与 MX/MY 八种朝向,翻转还能顺带改善供电接法)。工程实操里,现代工具的 mixed-size placement 或 macro placer 可以给初稿,但「这组 memory 该贴哪条边、PLL 离它的时钟消费者多远」这类决策仍然要人基于 flyline 拍板,因为工具不知道协议语义。
flyline 的局限也要清楚:它是零阶近似,不含时序权重。两条同样长的 flyline,一条在 2GHz 关键路径上、一条在多周期路径上,意义天差地别。所以规范做法是 flyline 叠加时序权重显示(工具里通常按 slack 着色),让「长且紧」的线一眼可见。另外 flyline 不含绕线层资源——pin 在高层金属的 macro 对下方绕线的阻挡比看起来小,判断阻挡要结合 macro 的 LEF 里各层 blockage 信息,LEF/DEF 的数据结构见 数据流格式之 LEF 与 DEF。
三、摆位准则:边界对齐、通道与 pin 朝向
经验和工具约束收敛出几条通行准则,逐条说物理原因。
第一,memory 贴边、pin 朝内。SRAM 这类规则的阵列型 macro 优先沿 die 边界排布,pin 一侧朝向芯片内部。原因有三:边界本来就不能高效利用(标准单元靠边的行常有利用率折损),macro 贴边等于废物利用;pin 朝内让 flyline 最短,数据线一出 pin 就进标准单元海;贴边排布的 macro 之间自然形成整齐的垂直/水平通道,绕线走廊规整。反例是把 memory 摆在 die 中央形成「孤岛」,四周标准单元通信必须环岛绕行,这是教科书级的摆位事故。
第二,通道宽度按绕线需求留。macro 之间的间隙不是能留多窄留多窄——通道里要过信号线、时钟线、有时还要走电源条带。估算方法是从 flyline 数出穿越该通道的线网数,乘以线距再加供电余量;先进节点上一条承载几百条信号加一组电源条带的通道,宽度常在几十微米量级。通道太窄的代价在 route 阶段才爆:局部绕线层打满、DRC 修不动,拥塞分析见 布线拥塞与 DRC、串扰。
第三,同类 macro 对齐成排成列。SRAM 对齐的好处是供电条带可以直线穿过整排、BIST 扫描链走线规整、以及为缓存编译器生成的 pin 位置差异留出统一接口。对齐还有利于后续的 EM/IR 分析——压降沿着规整的条带分布可预测,分析方法见 Power signoff:Voltus 与 RedHawk。
第四,模拟与 PLL 远离数字噪声源。PLL 对电源噪声和衬底耦合敏感,准则是与高频数字逻辑、大电流开关的 memory 拉开距离,供电走独立支路,必要时加 guard ring 和深 N 阱隔离。时钟从 PLL 到消费者的距离还要折算进 clock latency 预算,见 clock latency 之源与网络延迟。
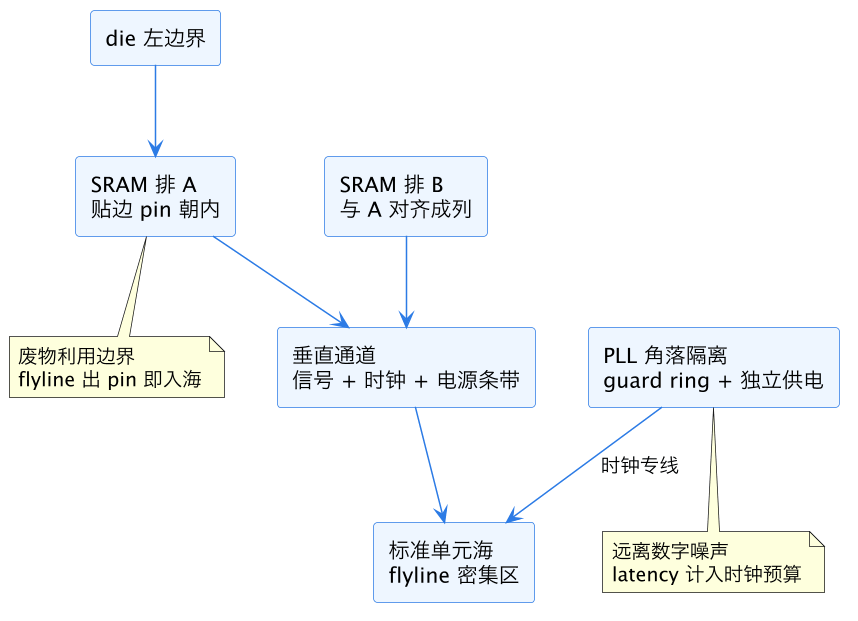
这张示意图是一个典型 corner 摆法的抽象:两排 memory 夹一条通道,PLL 蹲角落。实际项目里准则之间会打架——memory 想贴边,但 bump 图上那条边下方正好没有电源 bump;通道想留宽,但 die 面积卡死。摆位的艺术就是给每条准则标优先级:时序关键路径相关的相对位置最高优先,供电完整性次之,面积利用率最后。这个排序不能反,面积省出来的钱补不回时序收不掉的坑。
四、光晕与 blockage:macro 周边的缓冲地带
macro 摆好坐标只是第一步,它周围的「缓冲区」配置同样是摆放决策的一部分,两个主要机制是 halo(光晕)和 placement blockage。
halo 是在 macro 四边向外扩一圈的禁止/限制放置区,随 macro 移动,工具里通常叫 placement halo 或 keep-out margin。它解决的问题有两个。一是物理可制造性:macro 边缘的阱、密封环(seal ring)和金属图形与紧邻的标准单元行之间需要间隔,否则 DRC 违规。二是可布线性:macro pin 引出的第一批走线需要「出站空间」,如果标准单元紧贴 macro 排满,pin 出来的线立刻撞墙,工具只能在 pin 附近挖洞,反而浪费更多面积。
route halo(绕线光晕)是另一个维度:在 macro 上方指定某些金属层禁止或限制走线。有些 macro 的 LEF 自带各层 blockage(尤其低层金属被内部走线占满),route halo 在此之上再加保险——比如 macro 上方三层完全禁走,高层放行,避免工具把线压进 macro 内部图形密集区造成局部 DRC 地狱。
placement blockage 则是独立于 macro 的区域约束,分三级:hard blockage 完全禁止放任何标准单元(用于通道里要纯粹走线的走廊);soft blockage 允许摆放但 placement 阶段尽量避开、legalization 和优化阶段可以用(弹性缓冲);partial blockage 限定区域内容量百分比,比如最多放 40% 密度,常用于时钟树敏感区或预留 ECO 空间,ECO 预留策略见 Spare cell 摆放策略。
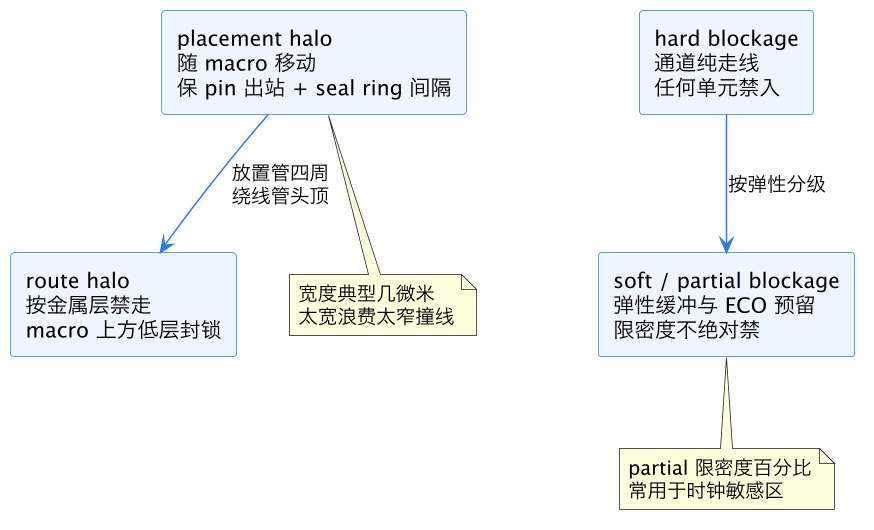
配置上的经验值:halo 宽度从 macro 工艺文档的最低要求起步(常见几微米到十几微米),再根据 pin 密度加——pin 全挤在一侧的高密度 memory,pin 侧 halo 加宽一倍是常见操作。全流程里 halo 不是一成不变的:floorplan 到 placement 早期用较宽 halo 保收敛,signoff 前评估能否收紧回收面积;route halo 的层数也随设计密度调,高密度设计宁可多封两层换取 DRC 干净。相关的单元级间距手段(cell padding)见 Placement 拥塞与 cell padding,逻辑是同一套:用面积换可布线性。
五、拥塞预防:从摆位源头掐断 route 报红
macro 摆位和拥塞的关系,可以用一句话概括:route 阶段的拥塞热图,八成能在 floorplan 阶段的摆位决策里找到根因。预防比修复便宜一个数量级,因为此时改动还只是挪坐标。
典型的摆位致塞模式有四种。第一种是「漏斗」:多排 macro 围出一个越收越窄的漏斗口,大量 flyline 必须穿过漏斗最窄处,通道宽度却按平均需求留的——route 一到,窄口处绕线溢出。预防是 flyline 分析时对每个宏观通道做「穿越线网计数」,按峰值而非均值留宽。第二种是「孤岛」:中央 macro 四周被逻辑环绕,环间通信全部环岛,环岛走廊打满。预防就是第二节的准则:能贴边贴边,必须居中时把它的通信对象一起拉过来形成 cluster。第三种是「pin 墙」:多块 macro 的 pin 面相对排布,两侧 pin 各引几百条线在对向通道里交错,线序交叉本身就吃掉大量绕线资源。预防是调整朝向让 pin 面朝向开阔区,或者干脆让两块 macro 的 pin 面贴在一起直连(abutment),中间不留给标准单元。第四种是「供电抢线」:macro 间通道同时要过信号和电源条带,电源条带按宽度扣掉后信号资源所剩无几。预防是把电源走线规划前置——这正是 floorplan 和 powerplan 要一起迭代的原因,见 Floorplan 与 Powerplan,供电不足的次生灾害(IR drop 热点逼你插 decap)见 Decap 插入与 IR。
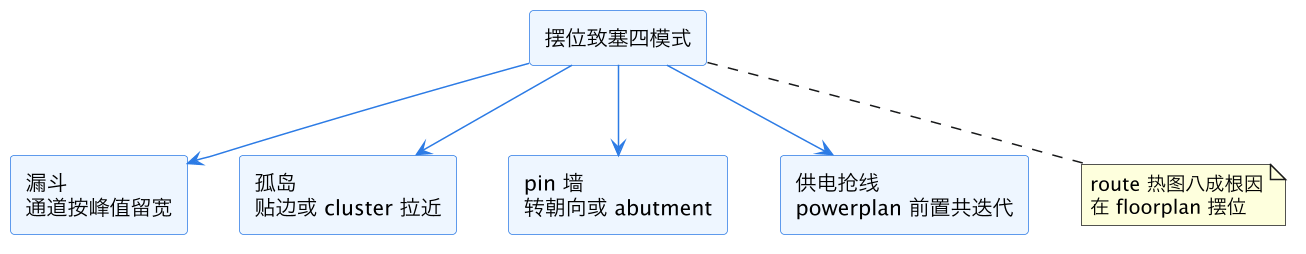
这张图可以当摆位评审的 checklist。四个模式之外,还要跑工具的快速拥塞预估(global route 的早期 trial 版本)做量化验证:flyline 是人眼的零阶工具,trial route 是工具的一阶验证,两者一致才算过。如果 trial route 已经在某通道报 overflow,不要指望详细 route 阶段工具自己能绕出来——回去挪 macro,这就是 floorplan 迭代的常态:摆位、flyline、trial route、调 halo、再摆位,一个设计走五到十轮不稀奇。整个 S3 阶段的迭代节奏见 数据流 S3:floorplan 与 place。
最后一层是时序与拥塞的耦合:macro 摆位同时决定绕线长度上限和通道容量,而绕线长度在先进节点上常常主导路径延迟(线延迟超过门延迟)。一条被迫绕行 2mm 的 2GHz 路径,插多少 buffer 都救不回来。所以摆位评审必须拉时序负责人一起看 flyline 上色的关键路径分布——「这组 macro 摆位让关键路径飞线平均长多少」是比「面积利用率多少」更重要的验收指标。后续时序收敛手段的边界见 Setup 修复之 VT swap 与 sizing:那些手段只能修中小违例,修不了摆位造成的结构性长路径。
这一篇在知识体系里的位置
本篇是 eda/ 目录物理实现线、S3 floorplan 阶段的实操篇,向上承接 数据流 S3:floorplan 与 place 的流程框架与 Floorplan 与 Powerplan 的供电协同,横向连接摆位的周边技术——电压域与 floorplan(多电压下的区域划分)、Bump 与 RDL 规划(封装侧约束)、数据流格式之 LEF 与 DEF(macro 抽象与摆位数据的载体)、Memory macro 时序弧(macro 内部的时序模型);向下通向拥塞与收敛——Placement 拥塞与 cell padding、布线拥塞与 DRC、串扰、Power signoff:Voltus 与 RedHawk,以及层次化设计视角的 层次化 STA 与 block 接口。读完本篇再看拥塞热图,应该能直接从红色区域的形状反推出摆位层的病根。
总结
宏单元摆放是 floorplan 阶段用几十到几百个大块头的坐标,一次性锁定绕线通道拓扑、供电走廊和标准单元可用面积的决策:方法上以 flyline 的密度、长度、聚簇三个读法为指南针,准则上坚持 memory 贴边 pin 朝内、通道按峰值线网数留宽、同类对齐成排、模拟 PLL 隔离蹲角,配套用 placement halo 保 pin 出站、route halo 封低层金属、hard/soft/partial blockage 分级管控周边缓冲;route 阶段的拥塞热图八成根因在摆位,预防手段就是盯死漏斗、孤岛、pin 墙、供电抢线四种致塞模式,用 trial route 做一阶验证,迭代到飞线整齐、通道无溢出再放行标准单元 placement。