固定优先级与轮转仲裁器对比实验:500 拍同激励仿真实测
更新时间:2026-10-25。本文是「集成电路大类 · 芯片设计」入门层(beginner)的一篇实验文。理论篇 三个最常见基础模块:FIFO、仲裁器、握手 已经讲过仲裁器的职责(多个请求方抢一份共享资源,仲裁器决定谁先用)和固定优先级、轮转两种策略的定义,那一篇回答「仲裁器是什么」;本篇回答另一个问题——**两种策略在真实激励下的行为差异到底有多大?**我们把两个仲裁器并排实例化、灌同一份激励、用计数器各自统计授权次数,让数字自己说话。
本文要回答的问题
- 固定优先级仲裁器的 RTL 为什么只有十几行?它的代价是什么?
- 轮转仲裁器的「旋转优先级基点」是怎么实现的?
- 什么叫「同激励对照实验」,为什么这是比较两种设计的正确姿势?
- 500 拍重载下,两种仲裁器的授权分布实测差多少?
先给结论卡,四个数字全部来自后文真实仿真日志:
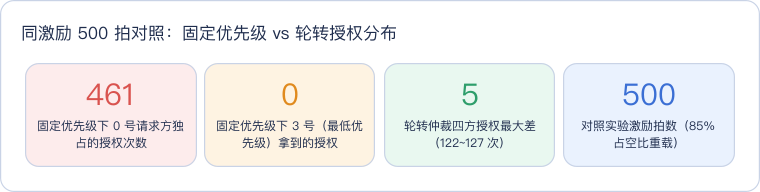
读这张卡抓一个对比:同样 500 拍、同样一份随机请求序列,固定优先级把 461 次授权给了最高优先级的 0 号请求方、最低优先级的 3 号一次都没拿到;轮转仲裁器把授权摊成 122-127 次、四方最大差距只有 5 次。这不是理论推演,是下面 termshot 实录里 scoreboard 数出来的。
一、固定优先级:十几行代码换来的「饿死」
固定优先级仲裁器(fixed-priority arbiter)的规则一句话:编号小的永远先。RTL 就是一个顺序扫描的循环:
always @(*) begin
    grant = {N{1'b0}};
    found = 0;
    for (i = 0; i < N; i = i + 1) begin
        if (req[i] && !found) begin
            grant[i] = 1'b1;
            found = 1;
        end
    end
end
从 0 号开始扫,第一个拉高的请求立刻中标,后面的全部忽略。它的优点极其现实:纯组合逻辑、零状态、综合出来就是一条优先级链(priority chain),速度快、面积小,中断控制器里大量用它——中断本来就该分轻重缓急。
代价同样现实:高优先级请求方持续请求时,低优先级会被永久压制。这不是边界 bug,是策略的定义性特征。问题只在「低优先级被压制多久算不能接受」——如果 0 号请求方占空比很高,3 号可能几百拍、几千拍拿不到一次授权,在总线仲裁、DMA 通道分配这类场景里就是事故。
从综合后的电路形态看,固定优先级链还有一个隐藏特性:越靠后的请求方,授权路径越长。0 号的 grant 只经过一级判断,3 号的 grant 要穿过前面三级的「我没请求」串联条件,请求方一多(比如 16 路、32 路),这条链就长成可观的组合逻辑深度,直接压在关键路径上。工程上请求方超过 8 路时,往往要把优先级链拆成树状结构分级判定,或者用查找表实现——这是固定优先级「代码短」不等于「电路便宜」的一面,本文 4 路规模还暴露不出这个问题,但读到工业界代码里的树状优先级编码器时要知道它在解决什么。
二、轮转仲裁器:旋转的优先级基点
轮转(round-robin)仲裁器的思路:优先级还是一条链,但链的「起点」每授权一次就旋到中标者的下一位。实现上多一个 one-hot 寄存器 base,表示本拍谁的优先级最高:
// 授权组合逻辑:从 base 开始环形扫描
for (i = 0; i < N; i = i + 1) begin
    if (req[(base_idx + i) % N] && !found) begin
        grant[(base_idx + i) % N] = 1'b1;
        found = 1;
    end
end

// 时序逻辑:授权后 base 旋到中标者下一位
always @(posedge clk or negedge rst_n) begin
    if (!rst_n) base <= {{(N-1){1'b0}}, 1'b1};
    else if (grant != 0)
        for (j = 0; j < N; j = j + 1)
            if (grant[j])
                base <= {{(N-1){1'b0}}, 1'b1} << ((j + 1) % N);
end
两种仲裁器的结构差异用一张图对照(红色是固定优先级的固有缺陷点,蓝色是轮转为消除它引入的状态):
读这张图抓住主线:固定优先级没有反馈环,轮转有一条从 grant 回到 base 的反馈环。正是这条环让「上次谁被服务过」成为状态,下一轮扫描从被服务者的下一位开始——长期看每个请求方被服务的机会就拉平了。代价是多一份 one-hot 寄存器和一级环形移位逻辑,面积和关键路径都略有增加,但换来的公平性是确定性的。
三、同激励对照:实验设计的关键一步
比较两个设计最常见的不严谨做法是「各写各的 testbench,各跑各的激励」,结果差异里混着激励差异,说不清是设计行为还是激励碰巧不同。本篇的对照做法是把两个 DUT 实例化在同一个测试平台里、接同一份 req 信号:
arb_fixed #(.N(N)) u_fixed (.req(req), .grant(grant_fixed));
arb_rr    #(.N(N)) u_rr (.clk(clk), .rst_n(rst_n), .req(req), .grant(grant_rr));
激励设计为重载场景:每个请求方每拍以约 85% 的概率拉高请求($random % 100 < 85),意味着几乎每拍都有多个请求方同时竞争——这正是仲裁器策略差异暴露得最充分的工况。轻载下两种仲裁器行为几乎一样(反正资源够用),只有持续竞争才能看出谁被饿死。
为什么选 85% 而不是 100%?全时段四方全请求的激励当然能复现饿死,但它太「干净」了——真实总线的请求是突发式的,随机占空比同时覆盖了「四方齐抢」「三方抢」「偶尔只剩低优先级单独请求」等多种窗口。如果轮转实现里 base 更新逻辑写错了(比如每次授权后都复位到 0 号而不是旋到下一位),在全请求激励下可能碰巧看不出异常,在随机激励下却会立刻暴露为 rr 列偏斜——随机激励的覆盖面价值就在这里。500 拍的长度则是统计学考虑:样本太短,随机波动会淹没策略差异;500 拍下每方期望请求约 425 次,分布特征已经稳定。
判定标准也事先写死,不靠肉眼看分布:
| 判定项 | 阈值 | 验证意图 |
|---|---|---|
| 固定优先级最低位授权数 | < 500/20 = 25 次 | 确认「饿死」现象真实发生 |
| 轮转四方授权最大差 | ≤ 500/10 = 50 次 | 确认公平性落在近均匀区间 |
| 轮转最少一方授权数 | > 0 | 确认无人被遗漏 |
三条同时成立才打 RESULT: PASS——这个测试平台实际上同时验证了两个仲裁器各自的特征行为,一鱼两吃。
四、iverilog 实测:461 比 0 的分布差距
整个流程就两条命令:iverilog -g2012 编译、vvp 运行。真实执行实录如下:
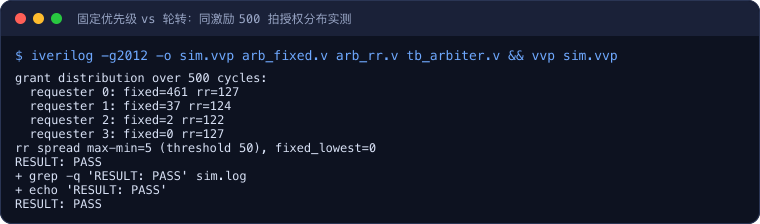
读这份实录抓三个位置:第 12-15 行的分布表是全文核心——fixed 列从 461 一路跌到 0,完美复现优先级链的压制结构(0 号吃走绝大部分,1 号捡漏 37 次,2 号只剩 2 次,3 号颗粒无收);rr 列 127/124/122/127,像用尺子量过一样平。第 16 行是自动判定:rr spread max-min=5 远低于阈值 50,fixed_lowest=0 低于阈值 25,两个特征行为同时确认,最终 RESULT: PASS。
几个值得停下来想的数字。第一,固定优先级下四方授权总和 461+37+2+0=500,正好等于拍数——说明每一拍都有至少一个请求方在抢(重载假设成立,没有「空拍凑数」的水分)。第二,轮转的四方总和 127+124+122+127=500,同样满拍,但分配近乎均匀,说明公平性不是靠少授权换来的。第三,max-min=5 这个残差来自环形扫描的取整效应:500 不能被 4 整除,加上随机请求不是每拍四方都在,小幅波动属正常,阈值放到 50 就是给这种合理抖动留的空间。
从编译到判定的完整过程原样摘录一段,可以看到对照实验的全链条——两个 DUT 一次编译进同一个仿真、同一份激励驱动、各自计数、最后统一判定:
+ iverilog -g2012 -o sim.vvp /tmp/evidence-src/exp-round-robin-arbiter-sim/arb_fixed.v /tmp/evidence-src/exp-round-robin-arbiter-sim/arb_rr.v /tmp/evidence-src/exp-round-robin-arbiter-sim/tb_arbiter.v
+ vvp sim.vvp
+ tee sim.log
grant distribution over 500 cycles:
  requester 0: fixed=461 rr=127
  requester 1: fixed=37 rr=124
  requester 2: fixed=2 rr=122
  requester 3: fixed=0 rr=127
rr spread max-min=5 (threshold 50), fixed_lowest=0
RESULT: PASS
+ grep -q 'RESULT: PASS' sim.log
+ echo 'RESULT: PASS'
RESULT: PASS
这段摘录干净得近乎单调,但它的信息量恰恰在分布表那四行:如果轮转实现有 bug(比如 base 更新方向反了、或者环形取模写错),rr 列会立刻出现明显偏斜甚至某个请求方归零,判定行就会打出 FAIL。把分布打印出来再设阈值判定,比只检查「授权唯一性」这类基本正确性多走了一步——不仅验功能对,还验设计特征对。
五、什么时候用哪种:一张决策表
实测数据落到选型上,结论很直接:
| 场景 | 推荐 | 理由 |
|---|---|---|
| 中断控制器 | 固定优先级 | 中断本身分轻重缓急,饿死低优先级正是需求 |
| 总线主设备仲裁 | 轮转 | 各主设备地位平等,长期饿死任何一个都是系统故障 |
| DMA 通道分配 | 轮转 + 权重扩展 | 通道间要公平,但可给高带宽通道加权 |
| 面积/时序极敏感的小模块 | 固定优先级 | 零状态、纯组合,代价最小 |
| 延迟敏感的实时请求方 | 固定优先级(把它放高位) | 用「故意不公平」保关键路径延迟 |
工程上还有两个常见变体值得一提。一是带权轮转(weighted round-robin):给每个请求方配份额,适合「要公平但不是绝对平均」的场景;二是可屏蔽优先级:固定优先级基础上加运行时掩码,低优先级积压太久时临时抬级,防止永久饿死。它们都是在本篇两个基本款上的增量修改,吃透了基本款再看变体都是顺水推舟。想进一步看 one-hot 编码在轮转类电路里的妙用,可以读 one-hot 编码与轮转调度。
顺带回答一个常见疑问:base 为什么用 one-hot 而不是二进制索引?二进制索引省寄存器(4 路只要 2 bit),但「旋到下一位」要译码加模运算;one-hot 用 N 个触发器换一个循环左移,组合逻辑最浅、时序最好。仲裁器通常坐在数据通路的咽喉位置、本身就压关键路径,拿面积换速度是划算的——这与状态机设计里高频状态寄存器倾向 one-hot 是同一个权衡逻辑。
动手复现时建议做一个反向实验:把 tb_arbiter.v 里的占空比从 85% 改成 20%(轻载)重跑,会看到固定优先级的 3 号请求方授权数明显回升——这能帮你建立直觉:仲裁策略的差异只在竞争下显现,负载是决定行为的第一变量。再进一步可以把请求方数 N 从 4 改成 8,观察轮转的公平性是否随规模保持(理论上 spread 占比会更小)。
这一篇在知识体系里的位置
- 理论承接:三个最常见基础模块:FIFO、仲裁器、握手(仲裁器的职责与两种策略定义);
- 编码风格延伸:one-hot 编码与轮转调度(base 寄存器为什么用 one-hot);
- 同系列实验:同步 FIFO Verilog 实现与回归实测(scoreboard 自校验方法同一套路)。
一句话总结
固定优先级仲裁器是纯组合的优先级链,重载下必然饿死低优先级(实测 500 拍 3 号请求方 0 次授权);轮转仲裁器用一个旋转的 one-hot 基点打破固定顺序,同激励下四方授权 122-127 次、最大差仅 5——选型不看哪个更好,只看你的系统能不能容忍饿死。
实验环境
- 机器/系统:云主机 S6.4XLARGE32 16C32G / Ubuntu 22.04(eda-golden-v1 镜像)
- 工具版本:iverilog -g2012(eda-golden-v1 镜像自带 Icarus Verilog)
- 日期:2026-10-25
- 完整命令:
bash run.sh(内部执行iverilog -g2012 -o sim.vvp arb_fixed.v arb_rr.v tb_arbiter.v,随后vvp sim.vvp,最后grep 'RESULT: PASS' sim.log)
代码获取
完整 RTL 与测试平台已同步到公开仓库:geek-doc.cn/experiments/exp-round-robin-arbiter-sim,克隆后进入该目录执行 bash run.sh 即可复现本文全部结果。