物理感知综合:fusion 流程如何用 floorplan 信息提前看到拥塞与线长
更新时间:2026-10-04。物理感知综合(physical aware synthesis,也常按厂商叫法称 fusion 综合、spatial synthesis)是先进节点综合流程的分水岭:传统综合靠 线负载模型 WLM 这种统计平均值估算互连延迟,到了 16nm 以下,线延迟主导路径、拥塞决定绕线,统计模型和现实差出 30% 以上是常事。物理感知综合的解法很直接——把 floorplan 信息搬进综合引擎,让综合在做映射和优化时就能看到「这个单元将来大概摆在哪、线大概要走多长、那片区域将来会不会挤」。本篇是综合线里接 逻辑综合 DC 的进阶篇,回答三个工程问题:这套流程要喂什么输入、它估出来的东西和真实 PR 为什么相关、以及它的收益到哪里为止。
本文要回答的问题
- 物理感知综合到底在综合的哪个阶段「看见」物理信息,虚拟布局布线(virtual P&R)是真跑了一遍布局布线吗?
- 跑 fusion 综合需要哪些输入——floorplan、macro 位置、布线层资源模型,缺了哪个会变成「伪物理感知」?
- 综合阶段估的线长和拥塞,为什么能和下游 全局布线拥塞分析 对得上?相关性从哪里来?
- 物理感知综合相比 WLM 流程的收益(时序相关性、拥塞前置发现、迭代次数减少)边界在哪里,什么设计吃了没效果?
- 工程落地时怎么验证综合-PR 相关性,相关性不达标怎么排查?
一、从 WLM 到物理感知:综合为什么需要「看见」版图
传统综合的时序模型是三段式:单元延迟查 Liberty 表,线延迟查线负载模型(wireload model,按 fanout 数查一条统计的 RC 曲线),两者相加。WLM 的致命假设是「同 fanout 的线长差不多」——这在单元均匀散布、线长由逻辑结构主导的时代勉强成立;但当设计里 macro 越来越多、单元密度越来越高、布线绕线越来越严重时,同样 fanout 4 的两条网线,一条 10 微米、一条跨 macro 绕出 500 微米,WLM 给的是同一个数。综合按这个数选驱动、插 buffer,到了 PR 阶段全线失真:综合报告里 meet 的路径 PR 后挂掉,综合没插 buffer 的长线 PR 后要 原位优化补 buffer 救,一轮 ECO 就是几天。
物理感知综合把「估算线长」这件事从查表改成了「真的摆一遍试试」:综合引擎内部跑一个轻量级的虚拟布局(virtual placement)——不做合法化细节、不处理 DRC,但把单元按 timing-driven 的目标散布到 floorplan 定义的 core 区域里,macro 摆在真实位置上——然后基于这个虚拟布局做斯坦纳树或 FLUTE 类的线长估计,再配合布线层的供给模型估拥塞。综合的每一次映射决策(选多大驱动、要不要复制逻辑、buffer 插不插)都用这个「摆过之后量出来」的线长。
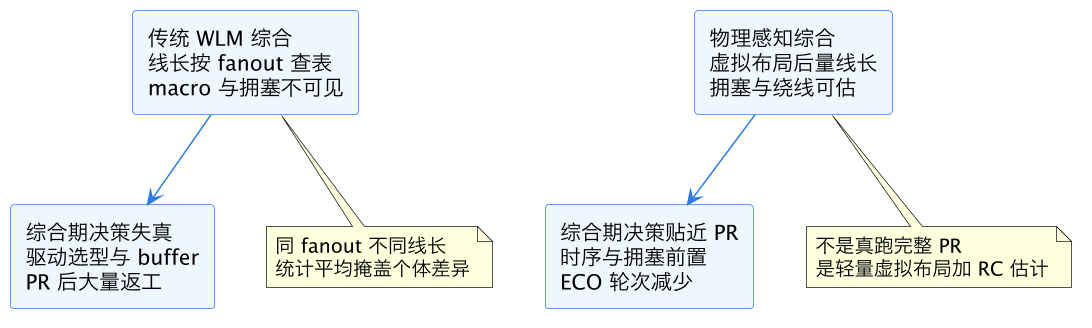
这张图是两种综合世界观的对比。关键认知在右侧那条注释:物理感知综合里的「布局布线」是替身演员——它足够像,能让线长估计和真实 PR 保持同方向、同量级;又足够快,综合迭代里可以反复调用。理解这一点,后面讨论相关性和收益边界才有共同语境。
二、输入要求:喂什么才叫物理感知
物理感知综合不是打开一个开关就完事,它的输出质量完全由输入的物理信息质量决定。核心输入有四类。
第一类:floorplan 定义。包括 die/core 区域形状、标准单元行(row)结构、blockage(hard/soft/placement halo)。来源一般是初版 floorplan 的 DEF(格式见 LEF/DEF 数据格式),或者在综合工具内用 floorplan 命令直接描述。没有这份输入,工具只能假设一个正方形 core 区,物理感知退化成「方框感知」。
第二类:macro 摆放。memory、IP 硬核的坐标和朝向,这是影响线长估计的最大单一变量——一条路径两端被两个 macro 夹在中间、必须绕行走 feedthrough(见 feedthrough buffer 插入),和两端贴在一起,线长差一个数量级。macro 没定稿就跑物理感知综合,估出来的线长是别人的设计。
第三类:布线层与 RC 技术文件。金属层叠、各层的单位电阻电容、via 电阻,来自 foundry 的 techfile(TLU+ 或 ITF,见 StarRC techfile 与 TLU+)以及 RC corner 定义(见 RC corner 选择)。虚拟布线估的 RC 要和签核抽取(SPEF,见 SPEF RC 抽取)用同一套 corner 体系,否则综合和签核各说各话。
第四类:约束与物理意图。SDC 照旧(见 综合约束 SDC),另外加上物理侧约束:电压区域(voltage area,见 voltage area floorplan)、placement guide/region(见 placement guide 与 region)、dont_use 列表。
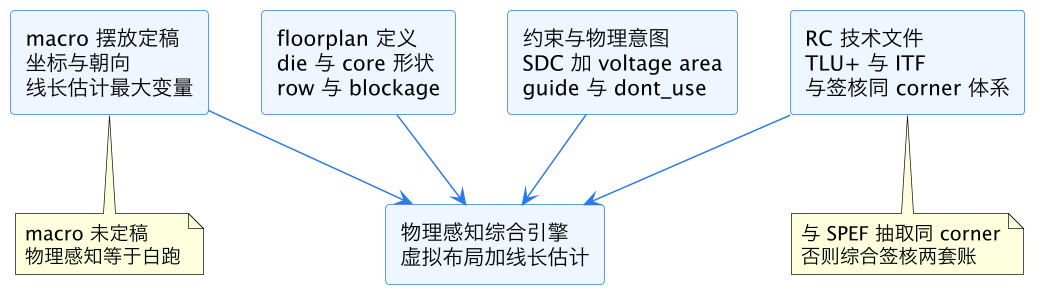
这张图把四类输入摆成漏斗:任何一类缺失或失真,引擎的物理视野就缺一块。实战里最常见的缺料是 macro 摆放——项目早期 floorplan 天天改,综合团队图省事用旧版 macro 跑,出来的网表 QoR 漂亮,PR 一摆新 floorplan 全部重来。工程纪律是:物理感知综合的输入版本要和 S2 综合交接数据流 里定义的 floorplan 基线绑定,floorplan 换版必须重跑综合。
| 输入 | 缺失时的退化表现 | 与 PR 对齐的检查点 |
|---|---|---|
| floorplan 形状 | 假设正方形 core,线长系统性偏乐观 | 比对 core 利用率与 aspect ratio |
| macro 坐标 | 长线被估短,buffer 欠插 | 抽查跨 macro 路径综合/PR 线长比 |
| RC 技术文件 | 延迟量级对、斜率错 | 与 SPEF 反标网表逐路径对拍 |
| 物理意图约束 | 虚拟布局摆进 PR 禁区 | 检查 guide/region 违例报告 |
三、引擎内部:虚拟布局与拥塞预估怎么做
物理感知综合的执行不是「先综合完再摆一下看看」,而是综合和虚拟布局交织迭代:初始映射后做一次粗虚拟布局,得到第一版线长表;优化引擎按这个线长做驱动选型、逻辑重组、buffer 插入;网表变了,布局增量更新,线长重估,再优化。循环收敛后输出的网表,其 buffer 树和驱动配置是为「这个 floorplan、这个 macro 摆法」量身定做的。
拥塞预估用的是全局布线的简化版:把 core 区域划成网格(gcell),虚拟布线把每条网线按斯坦纳树分配到经过的网格,累加每个网格的走线需求,和该层供给(track 数)比,得到拥塞热度图。这套机制和下游 全局布线拥塞分析 是同源的——这正是相关性的第一个来源。综合发现某区域需求超过供给阈值时,可以主动降局部密度:打散逻辑复制、限制该区域的单元聚集、对高拥塞 nets 换高层走线的 buffer 方案。这和 PR 侧的 布局拥塞与 cell padding 是同一套语言,只是发生在更早的时点。
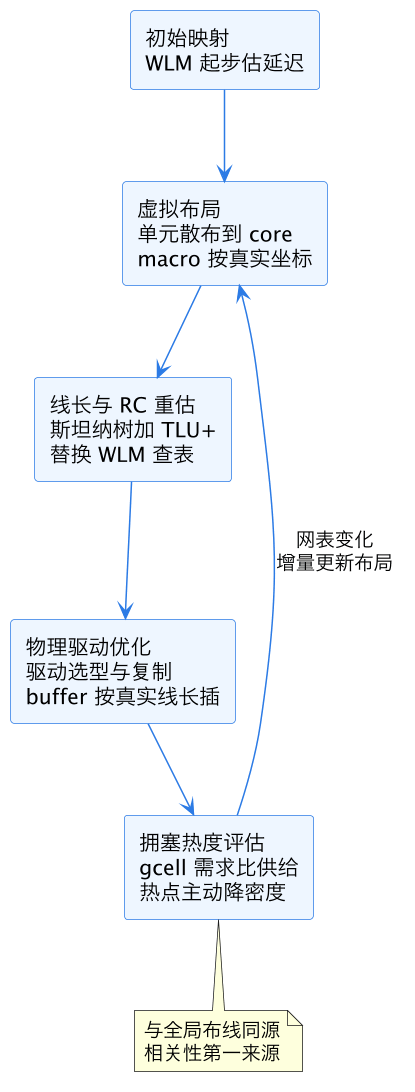
读这张图注意那条回边:cong 到 vplace 的「增量更新」是循环的心脏。综合不是算一遍就交卷,而是「改网表—重摆—重估—再改」直到收敛。这也解释了物理感知综合的运行时间为什么比 WLM 流程长 2-5 倍——它多跑了一个简版 PR 在里面。
四、相关性从哪里来,收益边界在哪里
物理感知综合的价值承诺是「综合报告 ≈ PR 报告」。这个相关性不是魔法,来自三个对齐:虚拟布局和真实 全局布局 用相近的 timing-driven 目标函数,单元散布形态相似;线长估计和真实全局布线用同源的斯坦纳树拓扑,绕线方向一致;RC 参数和签核抽取用同一套 techfile 与 corner。三个都对齐时,先进节点上综合与 PR 的布局后时序相关性(endpoint slack 的相关系数)通常能到 0.9 以上,而 WLM 流程常常只有 0.6-0.7。
但收益是有边界的,边界画在四处。
第一处边界:详细布线前的效应仍是盲区。串扰(SI,见 串扰增量延迟)、track assignment 后的实际绕线、详细布线的局部 DRC 收敛(见 详细布线 DRC 收敛),综合都看不见。所以物理感知综合把「布局后相关性」拉得很高,对「布线后相关性」只是改善不是解决——这也是为什么流程上仍需在 CTS 后、布线后重签时序(见 PR 时序收敛 ECO)。
第二处边界:时钟树还是理想值。综合阶段时钟按 ideal clock 或粗略的 latency 估计走,真实 CTS 时钟树综合 的插入延迟和 skew 只有在 PR 里才知道。hold 问题尤其明显——综合对 hold 的修复是基于理想时钟的,大量 hold 修复仍要留到 CTS 后(见 hold 修复 buffer 插入)。
第三处边界:floorplan 变更直接作废相关性。物理感知综合的网表是为特定 macro 摆法优化的,floorplan 大改(macro 换位置、voltage area 重划)之后,原来插的 buffer 位置全错,还不如 WLM 网表「平均地错」。项目早期 floorplan 未冻结时,物理感知综合的收益打对折。
第四处边界:小规模低密度设计收益本来就不大。设计只有几十万门、利用率 50%、几乎没有 macro 时,WLM 的统计假设偏差小,物理感知综合多花几倍运行时间只换来个位数百分比的相关性提升。收益最大的是百万门以上、高利用率、macro 密集、先进节点的设计——恰恰是最难收敛的那批。
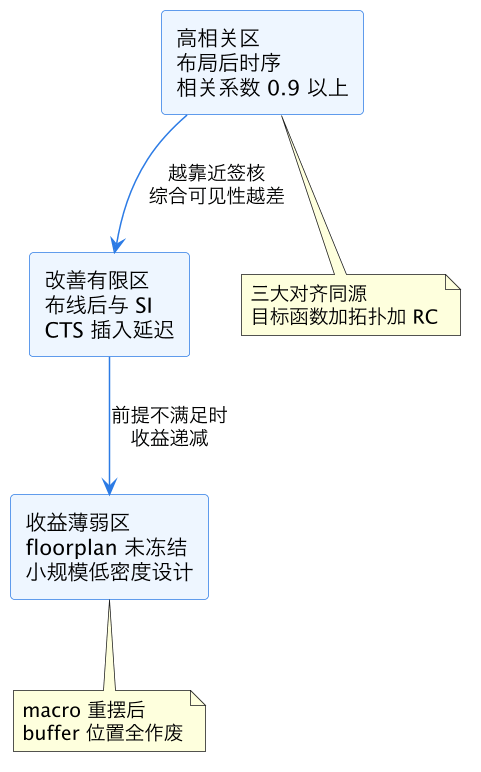
这张图把收益画成三个圈层,帮助排预期:物理感知综合买的是「布局后相关性」和「拥塞前置发现」,不是「布线后免迭代」。把它当银弹的团队会在 CTS 后失望;把它当「把 PR 第一轮的结果提前到综合看」的团队,才能拿到真实收益——综合与 PR 之间的时序迭代轮次从 4-6 轮压到 1-2 轮,这是行业里被反复验证的数字。
| 维度 | WLM 综合 | 物理感知综合 | 边界条件 |
|---|---|---|---|
| 线长估计 | fanout 查表,偏乐观 | 虚拟布局后实测拓扑 | floorplan 冻结才有效 |
| 拥塞可见性 | 无 | gcell 热度前置发现 | 热点颗粒度粗于真实 GR |
| 布局后相关性 | 0.6-0.7 | 0.9 以上 | 利用率与 macro 密度越高收益越大 |
| 布线后相关性 | 差 | 改善但不解决 | SI 与详细布线仍盲区 |
| 运行时间 | 基准 | 2-5 倍 | 可并行分区摊薄 |
五、工程落地:相关性怎么验证、不达标怎么查
上了物理感知综合,第一件事是建相关性度量闭环,不能凭感觉说「变准了」。标准做法:同一版网表,一边走综合的 QoR 报告,一边走完 Innovus PR 流程 到布局后,把两端所有 endpoint 的 slack 拉出来做散点图,算相关系数和「综合乐观量」(PR slack 减综合 slack 的中位数)。健康标准是:相关系数 0.9 以上,综合乐观量中位数在周期的 5% 以内,且不存在成片的方向性偏差(比如某时钟域综合系统性乐观 20%——那不是噪声,是建模缺陷)。
不达标时按固定顺序排查。先查输入版本:综合用的 floorplan/macro 和 PR 用的是不是同一版,这是最高频事故,没有之一。再查 RC corner 体系:综合读的是 cworst 而 PR 在另一个 corner 下抽 SPEF,斜率自然对不上。第三查物理约束传导:voltage area、guide 有没有完整传到 PR,综合把逻辑摆进了 PR 不让放的区域,两端的单元分布从根上就不同。第四查时钟假设:综合的 uncertainty 设置(见 时钟 uncertainty 与 jitter)是不是和 PR 的 CTS 目标一致,uncertainty 差太多会让两端的优化力度完全不同。最后才怀疑工具本身的估计精度——多数时候问题在前四项。
还有一个流程层的建议:物理感知综合输出网表时,顺手输出虚拟布局的物理信息(单元坐标、buffer 位置)作为 PR 的种子(seed placement / physical guidance)。下游 S3 floorplan place 数据流 如果用这套种子起步,综合-PR 一致性还能再抬一截——这也是「fusion」这个词的本义:不是两个工具各跑各的再对账,而是同一份物理视野贯穿综合到布局。
这一篇在知识体系里的位置
本篇在 eda/ 目录综合线里位于 逻辑综合 DC 与 线负载模型 WLM 的下游:那两篇讲综合的基础机制和旧式线长估计,本篇讲物理信息进入综合之后流程长什么样。输入侧连接 LEF/DEF 格式、StarRC techfile 与 TLU+、floorplan macro 摆放 与 voltage area floorplan;相关性验证依赖 全局布线拥塞分析、全局布局 timing-driven 与 SPEF RC 抽取 的口径;落地侧进 S2 综合交接 与 S3 floorplan place 数据流,余留问题交给 PR 时序收敛 ECO。读完本篇,面对「综合要不要上 fusion」这个问题,你应该能按设计规模、floorplan 成熟度、节点代际三个轴给出有依据的答案。
总结
物理感知综合(fusion 综合)用 floorplan 形状、macro 定稿坐标、与签核同 corner 的 RC 技术文件、物理意图约束四类输入,在综合引擎内部跑「虚拟布局—线长重估—物理驱动优化—拥塞热度评估」的迭代循环,把 WLM 查表式的线长估计换成「摆过之后量出来」的实测拓扑:相关性来自与全局布局同源的目标函数、与全局布线同源的斯坦纳树拓扑、与 SPEF 同源的 RC 参数,布局后时序相关系数可达 0.9 以上、综合与 PR 迭代轮次从 4-6 轮压到 1-2 轮;但收益有四条边界——串扰与详细布线仍是盲区、CTS 插入延迟综合看不见、floorplan 一改 buffer 全作废、小规模低密度设计得不偿失,落地时必须用 endpoint slack 散点图建相关性闭环,按「输入版本、RC corner、物理约束传导、时钟假设」的顺序排查不达标项。