randcase 加权分支:写法、权重为 0 的行为、与 dist 的分工及可配置随机化模式
更新时间:2026-10-01。约束随机验证里有两类「随机」经常被混为一谈:一类是值的随机——transaction 的地址、长度落在哪个区间,这是
dist和 constraint 的地盘,站内 SystemVerilog 约束完整指南 和 inside 与 dist 分布 讲得透彻;另一类是流程的随机——这一拍发读还是写、要不要插一段 idle、是否注入一次错误,这是randcase加权分支的地盘。很多工程师值随机玩得很溜,流程随机却只會写if ($urandom_range(100) < 30)这种裸概率判断,权重调一次改一次代码。这一篇把 randcase 的写法、权重为 0 的真实行为、与 dist 的分工边界、以及把权重做成可配置随机化模式的套路一次讲清。
本文要回答的问题
- randcase 加权分支的基本写法是什么,权重是怎么被解释的?
- 某个分支权重写成 0,或者所有权重都是 0,仿真器到底怎么走?
- randcase 和 dist 都叫「加权」,分工边界在哪里?
- 怎么把分支权重做成命令行可配置,实现「不改代码调流量配比」?
一、randcase 是什么:给流程分支加权的 case 语句
randcase 是 SystemVerilog 的关键字,外表像普通 case,但语义完全不同:它不匹配任何表达式,而是按每个分支声明的权重随机选一个分支执行。基本写法:
task automatic drive_one_beat();
  randcase
    60 : send_read();    // 60% 读
    30 : send_write();   // 30% 写
    10 : insert_idle();  // 10% 空拍
  endcase
endtask
每个分支前面的整数是权重,不是概率——仿真器把所有权重加起来,按「该分支权重 / 权重总和」计算实际概率。上面 60+30+10=100 恰好凑成百分比,读起来直观;写成 6:3:1 语义完全一样。这一点和 inside 与 dist 分布 里 dist 的 := 权重解释是同一套规则:相对值,不是绝对百分比。
分支体可以是任意语句块(begin ... end 包起来的整段 task 调用序列),这让 randcase 天然适合写「流量发生器」:每拍掷一次骰子决定干什么,循环起来就是一段随机激励流。相比 case ($urandom_range(9)) 这种先摇数再分派的手动写法,randcase 的好处是权重直接写在分支上,加分支、调权重不用动两段代码,可读性和维护性都好一截。
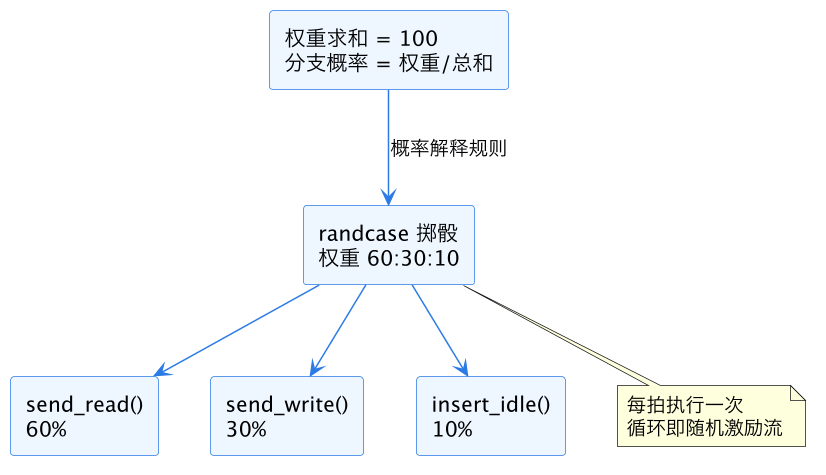
上图是 randcase 的执行模型:每次进入 randcase 块就独立掷一次骰子(各次之间没有记忆,不是 randc 那种不重复抽取),骰子的面数由权重总和决定。记住「无记忆」这一点——连续十拍全摇出读完全正常,想要「每种类型至少轮到一次」的语义得自己加状态机,或者改用 randc 动态数组随机 里讲的无重复抽取思路。
二、权重为 0 的行为:分支被跳过,全零则报警
randcase 有两个边界行为必须心里有数,否则调试时会被吓到。
单个分支权重为 0:该分支永远不会被选中。 这不是「概率极小」而是「概率为零」——仿真器在掷骰前就把零权重分支从候选池里剔除。这个特性非常有用:把某条分支权重写成 0 就等于临时禁用它,比如调试时想先屏蔽错误注入分支,改一个数字即可,不用注释整段代码。配合第二节要讲的可配置权重,「禁用某类激励」甚至可以在命令行完成。
所有分支权重全为 0:运行期警告,randcase 块整体不执行。 LRM 规定此时仿真器要发出警告(各家的措辞不同,常见是 "All randcase weights are zero" 一类),然后跳过整个块——不 hang、不 crash,但你的激励静默没了。这是一个典型的「静默坏掉」场景:仿真照跑,测试照过(如果 scoreboard 不检查激励存在性的话),但 DUT 根本没被驱动。工程纪律有两条:一是回归日志里把 randcase 警告纳入 grep 清单,跟 回归管理与 triage 的告警门禁是同一类动作;二是权重来自变量时,进入 randcase 前 assert 一下总和大于 0。
还有一个容易误会的点:权重可以是变量或表达式,仿真器在每次进入 randcase 时重新求值。也就是说 randcase w_rd : ... w_wr : ... endcase 里如果某个分支体内部改了 w_rd,下一次掷骰就按新权重走——这既是特性(可以做自适应流量),也是坑(分支体副作用悄悄改变后续概率分布,波形上完全看不出来)。
三、与 dist 的分工:值随机归 dist,流程随机归 randcase
dist 和 randcase 都讲权重,新手最容易问「能不能互相替代」。答案是分工清晰,别混用:
| 维度 | dist(约束内) | randcase(过程代码内) |
|---|---|---|
| 随机对象 | 一个变量的取值 | 一段代码流程 |
| 出现位置 | constraint 块、randomize() with | task/function/initial 等过程块 |
| 求解方式 | 参与约束求解,可与其他约束联立 | 独立掷骰,与约束求解器无关 |
| 可覆盖性 | covergroup 直接采值,权重即 bins 目标 | 流程路径,要用 covergroup 采分支标记或 $get_coverage |
| 典型用途 | 地址区间分布、长度分布、opcode 分布 | 读写比例、是否注入错误、是否插 idle |
分工的核心判据是:你要随机的是「一个值」还是「一个动作」。值归 dist——len dist {[1:4]:/70, [5:16]:/30} 让长度按区间加权,且这个分布参与求解,可以和其他约束(比如「长度大于 8 时地址必须 8 对齐」)联立,randcase 做不到这一点。动作归 randcase——「这一拍要不要发一笔错误帧」涉及一整段调用序列,塞进 dist 就得先摇一个枚举再 case 分派,等于手写 randcase。
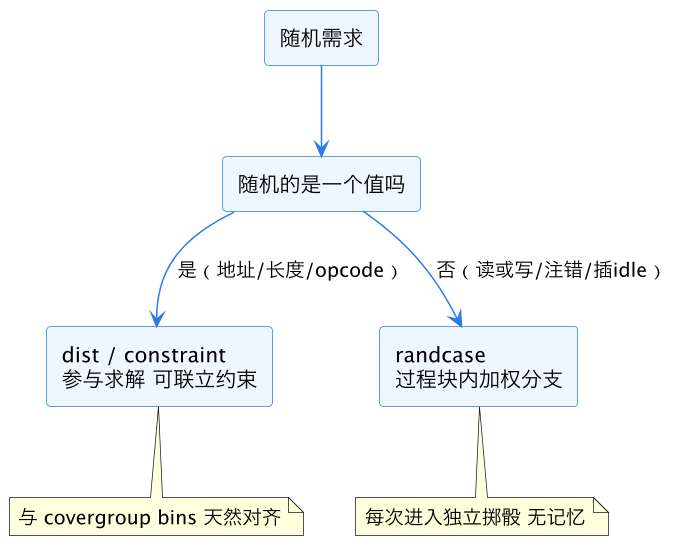
上图是选型判据的浓缩。实践里两者经常接力出现:randcase 决定「发一笔写事务」,然后 randomize() with 里 dist 决定这笔写事务的长度和地址分布——流程层和数值层各管各的,这正是 场景化随机分层 讲的 layering 思路的最小实例。
四、可配置随机化模式:权重进变量,变量接 plusargs
硬编码权重的问题在回归阶段暴露无遗:想跑一晚「写密集」配比、再跑一晚「错误注入」配比,就得改代码重编。标准做法是把权重提升为变量,从命令行注入:
class traffic_gen;
  int w_rd = 60, w_wr = 30, w_idle = 10, w_err = 0;

  function void cfg_from_plusargs();
    void'($value$plusargs("W_RD=%d", w_rd));
    void'($value$plusargs("W_WR=%d", w_wr));
    void'($value$plusargs("W_ERR=%d", w_err));
    if (w_rd + w_wr + w_idle + w_err == 0)
      $fatal(1, "all randcase weights are zero");
  endfunction

  task run();
    forever begin
      randcase
        w_rd   : send_read();
        w_wr   : send_write();
        w_idle : insert_idle();
        w_err  : inject_error();
      endcase
    end
  endtask
endclass
要点有三个。第一,权重给默认值,不挂 plusargs 时环境行为确定,跑冒烟不用背一串参数。第二,注入入口统一收敛到一个 cfg_from_plusargs(),机制上就是 SV plusargs 配置化 的老套路,UVM 环境则放到 test 的 build 阶段,配合 UVM 命令行 plusargs 按 test 名分发。第三,前面说的「全零防护」在这里落地成一行 $fatal——配置错(比如 +W_RD=0 +W_WR=0 漏给 idle)直接在零时刻炸出来,而不是让仿真静默空跑三小时。
这套模式的价值在回归矩阵上体现得最充分:同一个编译产物,回归脚本用不同 plusargs 组合扫多种流量配比——+W_RD=90 +W_WR=10 的读密集、+W_ERR=20 的注错压力——覆盖效率远高于单一配比长跑。错误注入分支默认权重 0 还有一层用意:正常回归里它天然关闭,需要时显式打开,零权重语义在这里变成了免费的安全开关。权重配比的调优不是拍脑袋,应该对着功能覆盖率的洞来调——哪类场景的 bins 没打满,就加大通往该场景的分支权重,闭环思路见 代码与功能覆盖率 和 covergroup coverpoint 与 bins。
最后补一个随机稳定性的提醒:randcase 和 dist 共用同一个随机数流,给环境加一条分支会改变后续所有摇骰结果,同一 seed 的「可复现」只对环境同版本成立。seed 管理和随机稳定性的完整讨论见 随机稳定性与 seeding。
这一篇在知识体系里的位置
本篇属于 chip-design/verification 目录下 SystemVerilog 随机化系列,向上承接 约束随机验证 的总纲;横向与 SystemVerilog 约束完整指南、inside 与 dist 分布 构成「流程随机」对「数值随机」的互补,配置化手段与 SV plusargs 配置化、场景化随机分层 衔接;往下,权重配比的调优依据来自 代码与功能覆盖率,可复现性问题归 随机稳定性与 seeding。
总结
randcase 加权分支是 SystemVerilog 给「流程随机」准备的专用语法:分支权重按相对值解释、每次进入独立掷骰、零权重分支被永久跳过、全零时警告并整体不执行;它与 dist 的分工是「动作归 randcase、取值归 dist」,工程上的正确打开方式是把权重做成变量接 plusargs、全零时 $fatal 自检、默认零权重当安全开关,让同一份编译产物在回归矩阵里跑出读密集、写密集、注错压力等多种流量配比。