细粒度专家:DeepSeek 系 MoE 结构对负载均衡与路由的影响
更新时间:2026-10-04。MoE 专家并行 serving 从系统视角讲过 MoE 模型怎么切到多卡上跑、all-to-all 怎么换数据;MoE 容量因子 讲过专家缓冲深度和 token drop 的账本。那两篇都把「专家长什么样」当作既定前提,本篇往结构里走一步:DeepSeek-V2/V3 带火的**细粒度专家(fine-grained expert)加共享专家(shared expert)**设计,把专家的粒度从「几个大 FFN」改成「几百个小 FFN」,这一个结构变化如何连锁地改写路由分布、负载均衡难度和推理侧的资源账本。读完你会明白为什么同样的 serving 框架,跑 DeepSeek 系模型时 EP 配置、容量因子、均衡策略全都要重新想。
本文要回答的问题
- 细粒度专家相对 Switch/GShard 时代的粗粒度 MoE,结构上到底改了什么?
- 共享专家为什么能独立提升质量,它和路由专家怎么分工?
- 专家变多变小之后,路由分布是更平了还是更歪了,auxiliary loss 还好使吗?
- 对推理 serving 来说,细粒度结构给 all-to-all、分组 GEMM 和容量配置带来什么具体变化?
- DeepSeek-V3 的「无辅助损失均衡」为什么只有在这种结构下才成立?
一、结构之变:从「8 个大专家选 2 个」到「256 个小专家选 8 个」
先对齐概念。经典 MoE(以 Mixtral、Switch 为代表)的做法是:把 Transformer 里的前馈网络(FFN)换成 E 个「专家 FFN」,每个专家是一个完整的、和原 FFN 差不多大的两/三层网络,router 给每个 token 选 top-k 个(k 通常是 1 或 2)。Mixtral 是 8 选 2,Switch 一路做到 128 选 1。这一代设计的默认心智是:一个专家就是一份完整的「能力副本」,token 靠选不同副本来获得专门化处理。
细粒度专家(fine-grained expert)把这个默认拆掉了:专家数量 E 大幅增大(DeepSeek-V2 是 160 个路由专家,V3 是 256 个),每个专家的中间维度同步缩小(小到原来 FFN 的几十分之一),top-k 相应增大(V3 是 8 选 256,再加 1 个共享专家)。在总激活参数量基本不变的前提下,同样多的计算被摊到了更多、更小的计算单元上。

上图的要点在「组合空间」一行。粗粒度下 token 能拿到的专家组合是 C(8,2)=28 种,细粒度下 C(256,8) 是个 15 位数量级的数。DeepSeek 论文里管这个叫组合灵活性(combinatorial flexibility):每个专家可以学得很「专」,token 的专门化靠「挑哪一组小专家」来表达,而不是靠「挑哪个大专家」。打个比方,粗粒度像去 8 家大超市选 2 家逛,细粒度像在 256 个专业小铺里配一套 8 件的工具箱——后者能表达的知识切分细腻得多。
这个结构收益有两篇论文的实证支撑:DeepSeekMoE(V2 的技术报告前身)在等激活参数、等 FLOPs 的对照下,细粒度加共享专家的结构在多个基准上稳定胜过 GShard 式粗粒度基线;道理也直观——专家更专,意味着同一个专家内部需要「和稀泥」的知识更少,知识冗余(多个专家各自存一份相似知识)被压缩,参数效率上升。
二、共享专家:不路由的那个专家在干什么
细粒度设计还搭了一个容易被忽略的部件:共享专家(shared expert)。它不参与路由,每个 token 无条件经过它,输出和路由专家的加权和再相加。V2 是 1 个共享专家,V3 也是 1 个(中间维度约等于 16 个路由小专家)。
为什么要它?观察粗粒度 MoE 的训练结果会发现一个浪费:不管 token 是什么,某些「通用操作」(常见的句法组合、高频模式)都会被每个专家各学一份,因为任何 token 都可能路由到任何专家,通用知识没地方集中存放。共享专家就是给通用知识一个固定地址:router 只负责分配「差异化」的部分,公共部分全走共享专家,路由专家被逼着只学增量。
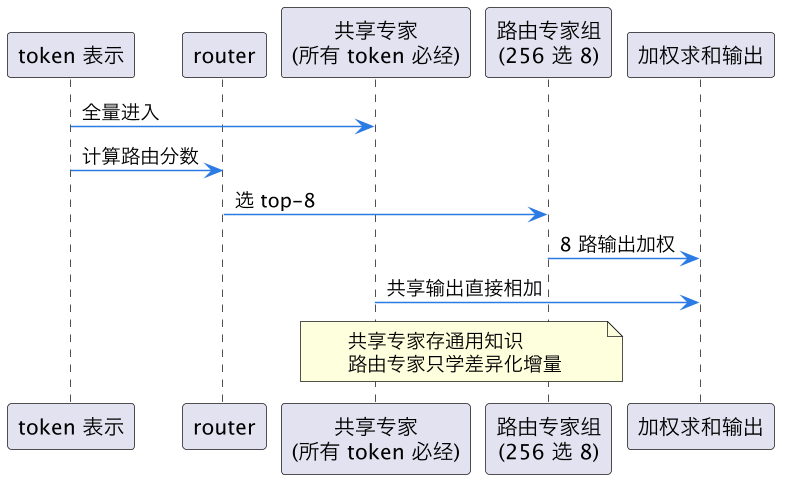
从图里能看出一个 serving 侧的直接后果:共享专家是每轮 100% 负载的稠密计算,它不占路由缓冲、不参与 all-to-all(在 EP 切分下它通常被当作普通稠密 FFN 做张量并行),容量规划时要把它从 MoE 的均衡账里摘出去单算。而路由侧因为少了「通用知识也要路由」的压力,负载分布天然平了一截——这是后面第四节均衡故事的起点。
| 维度 | 共享专家 | 路由专家 |
|---|---|---|
| 是否经过 router | 否,全 token 必经 | 是,按分数 top-k |
| 学到的知识 | 通用、高频模式 | 专门化、差异化 |
| 推理负载特征 | 稠密、恒定 | 稀疏、随流量倾斜 |
| 并行方式 | 张量并行(TP) | 专家并行(EP) |
| 容量规划 | 按稠密 FFN 算 | 按 capacity factor 配缓冲 |
三、路由分布的连锁反应:更平,但不自动平
直觉上,256 选 8 比 8 选 2 更容易均衡——分母大了,单个专家被挤爆的概率小了。这个直觉对了一半。细粒度确实把负载的方差压小了:每个配对只占总配对的 1/256,token 级别路由偏好被大数定律摊薄。但它引入了两个新的不均衡来源。
第一个是专家数量多带来的长尾。256 个专家里总有几十个是冷门(比如只在特定语言或特定领域被激活),冷门不是均衡问题,是资源问题:EP 部署下每个专家都要占卡上的显存,冷门专家的权重显存一分不少,却几乎不贡献计算。第二个更关键:top-k 从 2 涨到 8,意味着单个 token 的路由决策相关性变强——8 个槽位里经常成组地命中同一主题簇的专家(比如一批代码 token 同时挤向「代码簇」的十几个专家),簇内热点依然存在,只是热点从「单个专家」变成了「专家簇」。

这解释了为什么 DeepSeek 不能照搬 Switch 的 auxiliary load-balancing loss(负载均衡辅助损失,一个惩罚路由分布偏离均匀的附加训练目标)。经典 aux loss 的惩罚粒度是单专家,且它与主损失之间存在拉扯:压得越平,router 越不敢表达真实偏好,质量受损。在 256 个专家、top-8 的结构里,这个拉扯被放大——DeepSeek-V2 的实验显示强 aux loss 会明显掉点。于是 V3 换了一条路:无辅助损失均衡(auxiliary-loss-free balancing)——给每个专家的路由分数加一个只影响「选不选得上」、不影响「加权权重」的可调偏置项,训练/推理中动态调整:某专家负载持续偏高就降它的偏置,偏低就升。偏置调的是「门票」,不动「票价」,主损失完全感知不到均衡压力,质量损伤降到测不出。
这套机制能成立,恰恰依赖细粒度结构:专家够多,偏置微调有足够多的「旋钮」可用,把负载从一个专家挪到相邻语义的另一个专家,token 拿到的组合质量几乎不变;换到 8 个专家的粗粒度世界,挪负载意味着明显改变 token 的处理路径,偏置法的副作用就藏不住了。均衡算法和结构粒度是配套的,这是本篇最想留下的一个判断。
四、对 serving 侧的具体影响:all-to-all 变碎,GEMM 变小,capacity 变深
结构变化顺着推理链路往下传,每一环的账本都得重算。对照 MoE 专家并行 serving 里的 EP 框架,至少有四处不同。
all-to-all 通信变碎。top-8 意味着每个 token 要发给 8 个目标专家所在卡,通信的消息数约为 top-2 模型的 4 倍,而每条消息的有效载荷没变——通信总量翻倍以上,且小消息占比上升,对网络的延迟敏感度和元数据开销都更不友好。DeepSeek 推理部署的一个对策是节点限制路由(node-limited routing):把 256 个专家分组放到固定节点,router 限制每个 token 最多发往 M 个节点(V3 是 4 个),通信对端数从「最多 8 张卡」收敛到「最多 4 个节点」,跨机流量可控。
分组 GEMM 的块更小、更多。专家从 8 个变 256 个,grouped GEMM 要管 256 组变长输入,每组平均 token 数是原来的 1/32 上下。小 GEMM 的效率天花板低(算子启动、权重读出的固定开销摊不薄),这就是为什么 DeepSeek 推理栈在 EP 之外还大量依赖算子层面的定制优化。EP 度数的选择也变了:256 个专家放在 8 卡上是每卡 32 个,放在 32 卡上是每卡 8 个——每卡专家数越多,all-to-all 越省但单卡显存越紧,权衡曲线和粗粒度模型完全不同。
容量配置要重新校。MoE 容量因子 里那个公式 capacity = ceil(CF × T×k/E) 在这里参数全变:k 大、E 大,T×k/E 的均值不小(decode 一轮 32 请求时约 8 个配对每专家,比粗粒度高),但分布形状变了——偏置均衡把全局压平后,尖峰主要来自簇效应,CF 的甜区通常比粗粒度略低,但对均衡失效的容忍度更低:一旦偏置机制没跟上流量漂移,256 个专家的缓冲逐个溢出,排查面大得多。

还有一处隐形成本在调度侧。continuous batching 调度器 下 batch 组成每轮都变,细粒度模型每轮的 256 路负载直方图比 8 路难预测,prefill/decode 分离部署时,decode 集群的规模估算要按「簇热点 P99」而不是「单专家热点 P99」来做——这点和容量因子篇的 P99 定值法一脉相承,只是统计对象换了。
五、落地清单:跑细粒度 MoE 前要改掉的粗粒度习惯
把前面几节收成一张可操作的清单。
第一,别沿用粗粒度的均衡配置。aux loss 权重、CF 默认值、热点告警阈值,全是按 8~64 个专家的世界校出来的;细粒度下要么上偏置均衡,要么把 aux loss 权重降一个量级再观察质量回归。
第二,EP 切分先画簇再画卡。把 256 个专家按路由亲和性(哪些专家经常被同一批 token 同时选中)聚类,尽量让同簇专家同节点,node-limited 的 M 值才有意义。不聚类直接均分,跨机流量会比理论值高不少。
第三,监控指标换统计对象。告警盯「簇级负载方差」和「偏置更新频率」,而不是单专家 drop 率;显存侧注意冷门专家的权重驻留是固定成本,KV cache 推理显存 紧张时,专家权重量化比压 KV cache 更早进入议程。
第四,压测流量要包含主题突发。细粒度模型在均匀流量下的均衡表现普遍好看,真正的考验是突发同主题流量(一批代码、一批小语种)打过来时偏置机制的收敛速度——收敛期间簇热点直接击穿容量,这个窗口决定了在线 SLA 该怎么写。压测时建议把突发强度分三档注入(温和、翻倍、十倍),记录每档下偏置收敛所需的轮数和收敛期的 drop 率曲线,用这组数据反推容量余量该留多少,而不是按均匀流量的稳态结果拍一个数。
第五,给共享专家单独的监控视角。它不走路由、不进 MoE 缓冲,常规 MoE 面板上看不到它;但它是全 token 必经的稠密路径,一旦 TP 切分不均或算子回退到慢速实现,整体延迟会被它拖住而路由指标完全正常。定位过这类问题的团队都知道,先查共享专家往往比翻 256 路负载直方图省半天。
这一篇在知识体系里的位置
本篇是 MoE 结构侧的专题,与系统侧的 MoE 专家并行 serving(EP 切分与 all-to-all 的机制底座)互为表里;上游原理是 MoE 路由机制(gate、top-k 与辅助损失的经典框架——细粒度正是对这个框架的一次结构性修订);同层负载账本是 MoE 容量因子(细粒度下 CF 的统计对象从单专家换成专家簇);调度与显存的横向参照是 continuous batching 调度器 与 KV cache 推理显存。往下延伸的专题是 DeepSeek-V3 无辅助损失均衡的算法细节与节点限制路由的实现。
落地顺序建议:先确认要部署的模型是不是细粒度加共享专家结构(DeepSeek 系、Qwen3-MoE 系都是),是的话把粗粒度时代的均衡、容量、EP 默认值全部作废,按第四节的四处差异和第五节的清单重配,再用带主题突发的流量压测验证。
总结
细粒度专家把 MoE 从「8 个大 FFN 选 2 个」改成「256 个小 FFN 选 8 个加一个必经的共享专家」,用天文数字级的组合空间换参数效率和知识专门化;代价是路由分布出现「专家簇」级热点、辅助损失均衡失效,逼出 DeepSeek-V3 只调门票不动票价的偏置均衡,并把 serving 侧的 all-to-all 变碎、分组 GEMM 变小、容量因子的统计对象从单专家换成簇——跑这类模型,均衡策略、EP 切分、容量与监控都得按细粒度的账本重算,照搬粗粒度默认值是最常见的翻车方式。