MoE 混合专家:top-k 门控路由、专家并行与推理侧显存吞吐账本
更新时间:2026-09-29。在 KV Cache 推理显存 和 多 GPU NVLink 互连 里,我们分别看过稠密大模型推理的显存账和多卡互连的带宽账。MoE 混合专家(Mixture of Experts)把这两本账拧到了一起:它用「每层只激活一小撮专家」换来总参数量的数量级扩张,推理 FLOPs 没怎么涨,显存和通信却按全量参数付账。这一篇把 MoE 从门控路由到部署账本完整拆开,回答「为什么 8 选 2 的模型显存一点没省,训练还要额外交一份辅助损失」。
本文要回答的问题
- top-k 门控路由具体怎么算:softmax 之后取前 k 个,权重还要不要归一化?
- 专家并行(Expert Parallelism)下 token 怎么在 GPU 之间搬家,all-to-all 通信量有多大?
- 为什么一定要负载均衡辅助损失,不训它会出什么事?
- 容量因子(capacity factor)设 1.0 还是 2.0,丢掉的 token 对精度伤害多大?
- 推理部署时 MoE 的显存、带宽、吞吐三本账怎么算,和稠密模型差在哪?
一、MoE 层的基本结构:把 FFN 换成「专家团」
稠密 Transformer 里每个 token 都要过同一个前馈网络(FFN),参数量 = 计算量,想加容量只能加 FLOPs。MoE 的思路是把这个 FFN 复制成 N 份(N 个「专家」,通常是小的两层 MLP),每个 token 只被路由到其中 k 个(k 远小于 N,常见 8 选 2、64 选 8)。总参数量变成 N 倍,单 token 计算量只变成 k 倍——「条件计算」(conditional computation)的核心卖点就在这里。
一个 MoE 层的输入输出流程如下:
上图里最值得注意的是:门控网络本身极小(一个 d_model × N 的线性层,N=64 时参数只有几万),它几乎不花计算,却决定了全部专家的负载分布。合并阶段的权重 g_i 是 top-k 之后的 softmax 分数,常见做法是对选中的 k 个分数重新归一化(renormalize),保证输出尺度不随 k 变化。
以 Switch Transformer(N 大、k=1)和 Mixtral 8x7B(N=8、k=2)为两个极端,可以看清设计空间:
| 维度 | Switch (k=1) | Mixtral 8x7B (k=2) | DeepSeek-V2/V3 风格 (k=8) |
|---|---|---|---|
| 每 token 激活专家 | 1 个 | 2 个 | 8 个(细粒度专家) |
| 路由权重 | 取 max,无需归一 | 归一化 top-2 softmax | 归一化 top-k + 共享专家 |
| 负载均衡压力 | 最大(单点路由) | 中等 | 较小但专家数暴涨 |
| 合并开销 | 零(直通) | 一次加权加 | 多次加权加 |
| 代表取舍 | 通信最少、最易丢 token | 均衡 | 参数利用率高、路由复杂 |
二、top-k 门控路由的实现细节
门控计算本身只有三步,但每一步都有工程坑。第一步算 logits:scores = x @ W_g,得到每个 token 对 N 个专家的原始分数。第二步 softmax(有的实现对全部 N 个分数 softmax,有的先 top-k 再 softmax,两者在归一化权重下等价于是否包含未选中项的微小差异)。第三步按分数取 top-k,把 token 打包发给对应专家。
用 PyTorch 风格的伪代码看一次路由的完整数据流:
# x: (T, d_model),T = batch * seq_len 个 token
logits = x @ W_g                    # (T, N),门控线性层
probs = softmax(logits, dim=-1)     # (T, N)
top_w, top_idx = probs.topk(k)      # (T, k):权重 + 专家编号
top_w = top_w / top_w.sum(dim=-1, keepdim=True)  # 重新归一化

# 按专家分组:每个专家只算分到自己头上的 token
out = torch.zeros_like(x)
for e in range(N):
    mask = (top_idx == e)                      # (T, k) 布尔
    tok_ids, kth = mask.nonzero(as_tuple=True) # 该专家的 token 列表
    if len(tok_ids) == 0:
        continue
    y = experts[e](x[tok_ids])                 # 专家前向
out[tok_ids] += top_w[tok_ids, kth, None] * y这段伪代码暴露了三个实现要点。第一,路由是按 token 而不是按序列的——同一句话里的相邻 token 完全可能进不同专家,所以 KV Cache、注意力这些序列级结构不受影响,MoE 只替换 FFN。第二,按专家分组意味着每个专家拿到的是变长输入,实际框架(Megatron、Tutel、DeepSpeed-MoE)里用稀疏矩阵或 scatter/gather 内核代替 for 循环。第三,归一化这步不能省:不归一化时 top-k 权重和恒小于 1,输出尺度随路由分布漂移,训练和推理数值会对不齐。
还有一个面试和 Code Review 里高频的细节:先 top-k 再 softmax,还是先 softmax 再 top-k?如果最终要归一化,两者只差「未选中专家的概率是否参与分母」。Mixtral 的做法是先对全部 N 个分数 softmax、再取 top-k、再归一化,未选中专家的概率被彻底丢弃;GShard 早期版本直接在 top-k 的 logits 上 softmax。数值上差异通常不到百分之几,但同一份权重在两套实现间迁移时会产出不同结果,复现论文数字时必须对齐这个顺序。
另外,门控 logits 的数值稳定性也值得一提。N 很大(如 256 个细粒度专家)时,softmax 的分母跨 256 项,fp32 计算是底线;有的实现在 logits 上加一个可学的温度系数或直接 clamp 上限,防止个别 token 打出极端分数把 softmax 压成 one-hot——one-hot 化会让 top-2 里第二专家的权重趋近于零,等于悄悄退化成 k=1,负载均衡压力随之暴涨。
三、专家并行与 all-to-all 通信
MoE 的参数量动辄是稠密模型的 4-8 倍,单卡放不下全部专家,就得把 N 个专家切到 E 张卡上(每个 rank 持有 N/E 个专家),这就是专家并行。问题在于:每张卡上的 token 是按 batch 分的,而专家是按卡分的,token 必须「搬家」到持有目标专家的卡上,算完再搬回来。这一来一回就是两轮 all-to-all(全互换通信,每个 rank 向所有其他 rank 发送大小不一的分片)。
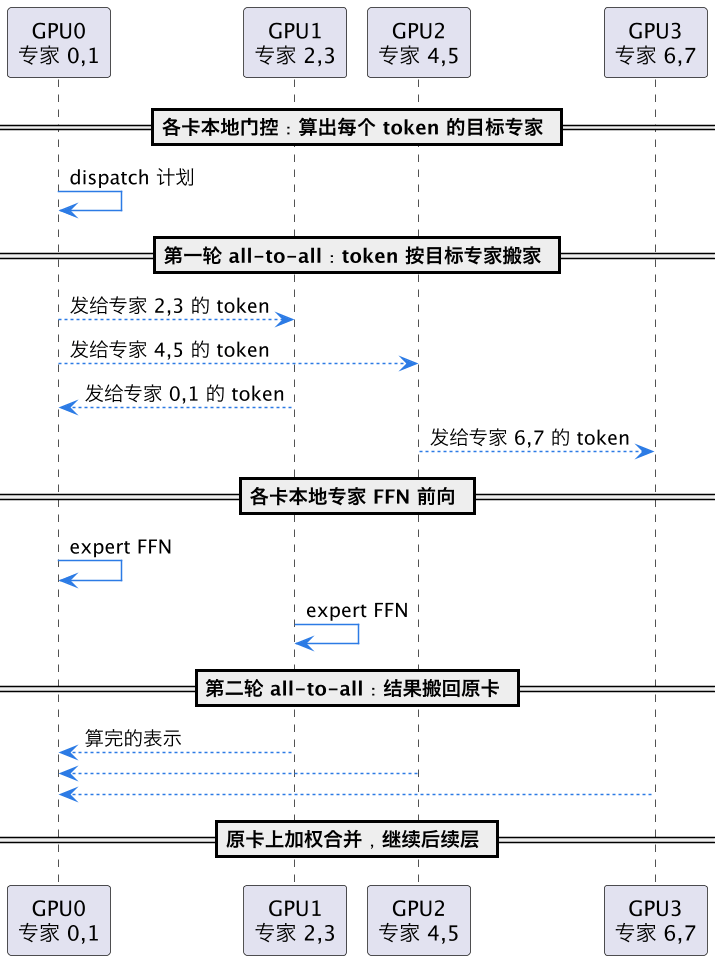
通信量可以粗算:设每卡 token 数为 T/E,隐藏维 d,激活值精度 2 字节(bf16),k=2 时每个 token 平均要发给 k 个专家,最坏情况下几乎全部离开本卡。两轮 all-to-all 的单卡进出流量约为 2 × k × (T/E) × d × 2 字节。以 T/E=4096、d=4096、k=2 估算,每轮约 128MB,一层两轮 256MB;一个 60 层、每层 1 个 MoE 的模型,前向一次单卡通信量就到了 15GB 量级。这就是为什么 MoE 训练/推理对互连带宽极度敏感——NVLink 域内几百 GB/s 能扛住,跨节点走 IB 或 RoCE 时 all-to-all 立刻成为瓶颈,工程上常用「专家并行限制在单节点内、跨节点用数据/流水并行兜底」的混合切法,互连细节见 多 GPU NVLink 互连。
还要区分 all-to-all 和 all-reduce:稠密模型的张量并行每层要 all-reduce 部分和,通信模式是「人人有份、聚合归一」;MoE 的 all-to-all 是「各发各的、按目标重排」,没有聚合语义,所以不能套用 ring all-reduce 的优化,带宽利用率更依赖网络的对分带宽(bisection bandwidth)。
工程上还有两个常见的 all-to-all 优化值得知道。其一是通信与计算重叠:把 token 按目标卡切成多个 chunk,发走第一个 chunk 后立刻开始算已到位的部分,用 CUDA stream 让 NCCL 通信和专家 GEMM 并行,能藏掉 30%~50% 的通信时间。其二是层级化 all-to-all:跨节点场景先做节点内 gather、再节点间单跳交换、最后节点内 scatter,把跨网流量从 E² 级别压到节点数级别,DeepEP 这类专用通信库的核心就是这个思路。判断通信是否成为瓶颈的经验法则:打开 nsys 看 MoE 层时间线,如果 all-to-all 内核占比超过整层耗时的 40%,就先考虑缩小专家并行域或启用重叠,而不是加卡。
四、负载均衡辅助损失:不训它就坍缩
top-k 路由有个天然的正反馈:早期被多选几次的专家梯度多、变得更好,于是更被选中——不加干预,几十个训练步后就会出现「赢家通吃」,一两个专家吃掉 80% 的 token,其余专家饿死(routing collapse)。专家饿死的直接后果是有效参数量大幅缩水,MoE 退化成一个小模型。
解法是在主损失之外加一份负载均衡辅助损失(load balancing loss)。Switch 风格的经典写法是:
L_aux = N × Σ_{i=1..N} f_i × P_i

f_i = 实际路由到专家 i 的 token 比例(离散决策的统计量)
P_i = 门控对专家 i 的平均 softmax 概率(可微)
f_i 来自不可导的 top-k 决策,P_i 可导,两者相乘后对 P_i 求梯度,效果就是「被分配任务多的专家,把它的门控概率往下压」。完全均匀时 f_i = P_i = 1/N,L_aux 取最小值 1。这个损失乘一个小系数(典型 0.01)加进总损失即可。
| 均衡手段 | 机制 | 代价 | 代表 |
|---|---|---|---|
| 辅助损失 | 可微压力拉平分布 | 与主损失抢梯度,系数敏感 | Switch、Mixtral |
| 噪声路由 | logits 加高斯噪声再 top-k | 推理时需关掉,略损精度 | Switch |
| 无损失偏置法 | 只调路由 bias,不进损失 | 需在线统计负载 | DeepSeek-V3 |
| 硬容量 + 溢出 | 超容量直接丢/绕行 | 丢 token 损精度 | 多数推理框架 |
辅助损失系数是个跷跷板:太小压不住坍缩,太大则门控为了均衡而均衡,token 被送去「不合适」的专家,主任务精度受损。论文里 0.01 是大量扫描后的甜点,实际项目里建议从 0.01 起步、盯着「每专家 token 占比」曲线调。
五、容量因子与丢 token
all-to-all 是变长通信,但 GPU 内核喜欢定长。工程上的妥协是给每个专家设一个容量上限(capacity):capacity = ceil(capacity_factor × T / N),即平均每专家该收的 token 数乘一个容量因子(capacity factor,CF)。路由时专家收满即拒,溢出的 token 走残差直连(等价于该层 FFN 被跳过),这就是「丢 token」(token dropping)。
CF 的取舍很直白:CF 越大丢得越少,但显存里的 buffer、通信的填充(padding)和计算的最坏情况都按 capacity 预分配,CF=2.0 意味着为平均负载付了两倍的钱。经验值是训练用 CF=1.0~1.25(辅助损失把分布训平了,溢出率能压到 1% 以下);推理分布不可控,常用 CF=1.0 配合溢出统计监控。丢 token 的伤害不均匀——被丢的往往是路由分布尾部的「冷门」token,一句里丢一两个通常无感,丢到 5% 以上生成质量会出现可测的退化(困惑度上升、长答案中途逻辑断裂)。
六、推理侧的显存与吞吐账本
到了部署侧,MoE 的账本和稠密模型完全不同,很多人第一反应「8 选 2 只算 2 个专家,显存是不是也只用 2/8」——错。全部 N 个专家的权重都必须驻留在(某个 rank 的)显存里,路由是逐 token 动态的,无法预知下一个 token 要谁。以 Mixtral 8x7B 为例算一本完整账:
| 账项 | 数值(Mixtral 8x7B) | 说明 |
|---|---|---|
| 总参数 | 46.7B | 其中专家参数约 90% |
| 激活参数/token | 12.9B | 8 选 2,约等于 13B 稠密模型的算力 |
| bf16 权重显存 | ~93 GB | 全部专家都要在场 |
| 4bit 量化后 | ~26 GB | 权重显存大头可压缩 |
| KV Cache | 按 13B 级稠密模型算 | 注意力结构与稠密一致,见 KV Cache 推理显存 |
| 单 token 前向 FLOPs | ≈ 2 × 12.9B | 与 13B 稠密模型同档 |
结论是三句话。显存按总参数付:46.7B 模型就要 46.7B 的权重位,量化(见 混合精度 FP16/BF16/FP8 与 INT8/INT4 量化校准)几乎是 MoE 部署的必选项。算力按激活参数付:解码阶段每 token 的 FLOPs 只对应 k 个专家,延迟和 13B 稠密模型相当。吞吐看带宽不看算力:解码是显存带宽受限(memory-bound),MoE 每 token 要读 k 个专家的权重,读的权重字节数比同算力稠密模型略多(k 个专家 vs 一个共享 FFN),但批量上来后不同 token 复用同一专家权重,有效带宽利用率反而可以改善。
这里展开第三句,因为它是 MoE 吞吐反直觉的地方。稠密 13B 模型解码时,每个 token 都要完整读一遍 13B 权重;批量为 B 时权重读一次、复用 B 次。MoE 解码时,一个 batch 里的 B 个 token 各自路由,合起来通常会把全部 N 个专家都踩到,权重读取总量接近全量参数——批量小的时候(比如 B=8 的在线推理),MoE 每步要搬的权重字节数可能是同算力稠密模型的 3 倍以上,首 token 之后的解码延迟明显更差。批量做大到 64 以上,「每个专家都有足够多 token 复用权重」才成立,MoE 的吞吐优势才开始兑现。所以 MoE 天然适合高并发服务,对低延迟单用户场景反而不友好——这一点和直觉「激活参数小所以更快」恰好相反。
多卡部署时还有第四本账——通信。前面算的每层两轮 all-to-all 在解码阶段同样存在,且解码 batch 小、通信占比更高。常见工程组合是:专家并行放 NVLink 域内(8 卡一箱正好 8 专家一卡一个),跨节点只做数据并行;配合 PagedAttention 与 vLLM 服务化 的连续批处理(continuous batching)把单批 token 数撑大,摊薄 all-to-all 的固定开销。投机解码(Speculative Decoding)在 MoE 上同样适用,小草稿模型可以用同族稠密模型,验证阶段仍是标准 MoE 前向。
最后给一个选型速查:
| 场景 | 建议 |
|---|---|
| 单卡部署、显存 < 40GB | MoE 必须 4bit 量化,或干脆选同激活量的稠密模型 |
| 8 卡 NVLink 节点 | 专家并行 8 路,一卡一专家,all-to-all 不出节点 |
| 跨节点训练 | 专家并行限节点内 + 节点间流水/数据并行,CF=1.0 |
| 高并发在线服务 | 连续批处理撑大批量,盯溢出率与每专家负载曲线 |
这一篇在知识体系里的位置
本篇属于 chip-design 中级篇里「AI 推理与加速」线索的架构层文档:上游是 KV Cache 推理显存(单模型显存账)与 多 GPU NVLink 互连(通信底座),同层配套 混合精度 FP16/BF16/FP8、INT8/INT4 量化校准(权重显存压缩),下游落地到 PagedAttention 与 vLLM 服务化、推理运行时调度 与 TensorRT 推理优化。
总结
MoE 混合专家用 top-k 门控让每个 token 只激活 N 个专家中的 k 个,把总参数量和单 token 算力解耦;代价是专家并行下每层两轮 all-to-all 通信、必须靠负载均衡辅助损失防止路由坍缩、容量因子决定丢 token 的比例;部署时显存按全量参数付、算力按激活参数付,量化加节点内专家并行是推理落地的标准组合。