RAL callback:uvm_reg_cbs 的 pre/post read/write 扩展点能干什么、典型误用有哪些
更新时间:2026-10-01。UVM 寄存器抽象层(RAL,Register Abstraction Layer)把 DUT 寄存器封装成对象,前门总线、后门 HDL 路径都能访问,站里 RAL 前门与后门访问 讲了两种通路,寄存器模型集成 讲了模型怎么挂进环境。但有一种需求这两篇没覆盖:我想在「每一次寄存器读写发生的前后」插一手——改一下要写的值、记一条日志、或者给某个古怪寄存器补上 RTL 没建模的行为。这正是 RAL callback 的地盘:UVM 提供
uvm_reg_cbs(cbs 即 callbacks)基类,暴露 pre_read / post_read / pre_write / post_write 四个虚方法,你把自定义行为挂上去,之后所有经过该寄存器的访问都会触发它。
本文要回答的问题
- RAL callback 的四个钩子在访问流程里到底插在哪几个点上?
- pre/post read/write 各自适合干什么:后门修改、日志、特殊行为建模分别用哪个?
- callback 挂在 reg、field、reg_block 三个层级上有什么区别?
- mirror 与 callback 修改后的值如何保持一致,谁负责调 predict?
- 工程上最常见的误用模式有哪些,后果是什么?
一、四个钩子插在访问流程的哪
一次 RAL 访问(比如 reg.write(status, value))在寄存器模型内部走一条固定流水线:先构建 uvm_reg_item,再依次触发 pre_write、真正发起总线或后门传输、最后 post_write,期间更新 mirror。callback 的四个方法就嵌在这条流水线上,pre 在传输发起前、post 在传输完成后。读路径对称:pre_read 在发读之前,post_read 在读值回来之后、写回 mirror 之前。
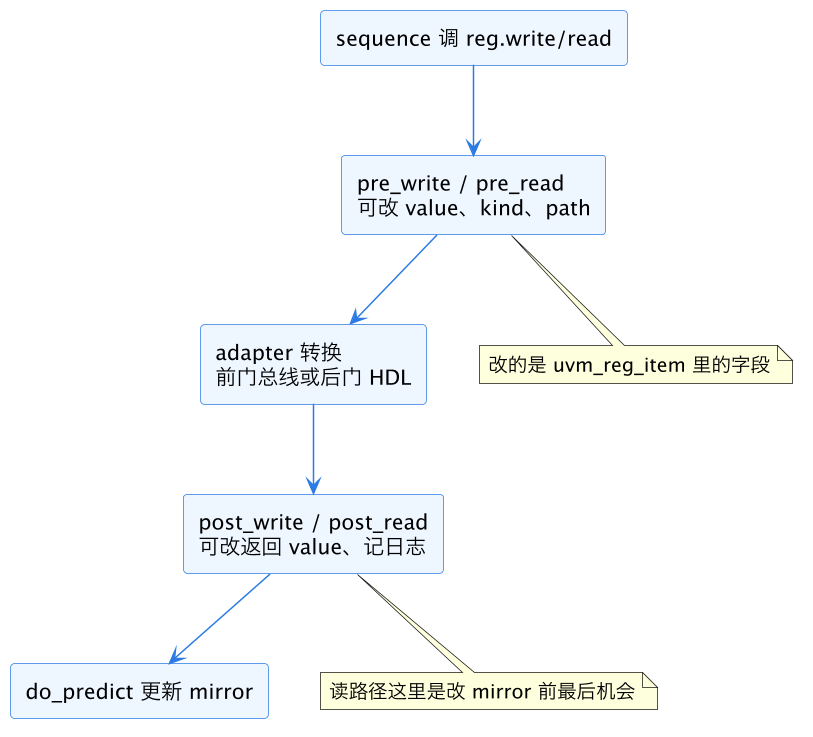
这张图要记住两个位置。第一,pre 钩子里拿到的是还没出门的 uvm_reg_item,改它的 value[0]、kind(读改写)、path(前门换后门)都生效——这是「拦截」能力的来源。第二,读路径上 post_read 是修改返回值的最后一站:在这里改 value[0],之后 do_predict 会把改过的值写进 mirror,调用方拿到的也是改过的值。理解了这两点,后面三种典型用法都是顺水推舟。
二、三种典型用法
用法一:访问日志与统计。 最朴素的用途。在 post_write 里把寄存器名、地址、写入值、时间戳打进日志,回归跑完你就有一份「哪些寄存器被碰过、被写成什么」的完整流水,比翻总线波形快得多。配合 RAL 覆盖率采样,callback 里的日志还能用来核对覆盖率模型有没有漏采样。
用法二:特殊行为建模。 有些寄存器行为 RAL 原生语义表达不了,比如写 1 清零(W1C)的副作用扩展到相邻状态位、读某个寄存器会顺带清掉中断挂起位、或者读写经过 FIFO 时地址不变但数据在流动。这类「访问触发副作用」的逻辑,RTL 里有,但寄存器模型的 desired/mirror 语义里没建模——在 post_read/post_write 里手动补上:读完中断寄存器后,把模型里对应 pending 字段也 predict 成 0。更复杂的字段级语义可对照 RAL desired 与 mirror 语义 一起理解。
用法三:后门修改与故障注入。 pre_write 里把 value[0] 改掉再放行,等于在不动 sequence 的情况下对写入流做篡改——专挑某个控制位翻转,就是一种低成本的故障注入。pre_read 里把 path 从前门改成 UVM_BACKDOOR,可以让「正常情况下走总线」的用例在某段窗口内改走后门,用来验证两条通路结果一致。后门通路的细节见 RAL 后门 HDL 路径 和 SV force/release 与后门注入。
三种用法对应到钩子的选择有一个简表:
| 需求 | 用哪个钩子 | 为什么 |
|---|---|---|
| 记录/统计访问 | post_write / post_read | 传输已完成,拿到的是最终生效值 |
| 修改写入值、注入故障 | pre_write | 传输未发起,改了才会真的出门 |
| 修改读回值、建模读副作用 | post_read | mirror 更新前最后机会 |
| 切换前门/后门路径 | pre_read / pre_write | path 字段只在出门前有效 |
| 建模写副作用(W1C 联动) | post_write | 需要知道写入已生效再补副作用 |
三、挂在哪一层:reg、field、block
uvm_reg_cbs 通过 uvm_reg_cbs::add(对象, callback) 注册,对象可以是 uvm_reg(单个寄存器)、uvm_reg_field(单个字段)、uvm_reg_block(整个块,块内所有寄存器都触发),甚至 uvm_mem。层级选择直接影响维护成本:
- 挂 reg:最常用,作用域明确,日志和副作用建模都挂这一层。
- 挂 field:只对某个字段敏感的场景,比如只关心中断使能位的翻转。注意 field 级 callback 的触发条件是「该字段所在寄存器被访问且访问覆盖该字段」,写其他字段不会触发。
- 挂 block:做全块访问日志时最省事,一个 callback 管几百个寄存器;但回调里要自己判断是哪个寄存器被访问(从
uvm_reg_item里反查),且性能开销随访问频率线性放大,高速访问的块慎用。
同一个对象可以挂多个 callback,按注册顺序执行——这意味着顺序本身成了语义的一部分,先篡改再记录和先记录再篡改,日志内容是不一样的。
四、典型误用
误用一:在 callback 里直接改 mirror。 最常见也最隐蔽。有人为了让「读出的 X 状态位不影响比对」,在 post_read 里直接 predict() 把 mirror 改掉,结果把 UVM 自己的预测流程(do_predict 随后还会按总线返回值再更新一次)踩在脚下,两处打架,mirror 状态取决于谁先谁后。正确姿势是改 value[0],让标准流程去更新 mirror,或者干脆关掉自动预测(auto_predict)、改由显式 predictor 统一更新 mirror,从机制上杜绝两处打架。
误用二:pre_write 改了值却忘了 mirror 语义。 pre_write 里把写值改成 A,调用方 sequence 以为自己写的是 B;如果之后用 mirror() 做 check,期望值用的还是 desired(B),总线上实际生效的是 A,比对必炸。凡是 pre_write 做篡改的,日志里必须把「原始意图值」和「实际出门值」都记下来,否则 triage 时会怀疑人生。
误用三:把 callback 当 scoreboard 用。 callback 是逐次访问的钩子,没有事务完整性概念;burst 写、间接寻址(见 RAL 间接索引访问)这类一次逻辑操作拆成多次物理访问的场景,callback 看到的是碎片。要做事物级检查请去 monitor 接 predictor 的那条正路——总线上看到的是完整事务,predictor 再据此更新 mirror。
误用四:挂了忘摘,污染环境。 callback 是全局注册,不随 phase 自动清理。某个用例挂上的故障注入 callback 没有 delete,后面的用例全部默默中招——表现为「只有跑全量回归才挂、单跑必过」的灵异失败。纪律是:谁 add 谁 delete,最好封装成在 build_phase 注册、或用例结束显式摘除的 RAII 式封装。
误用五:在 callback 里做重活。 post_read 里调一段 DPI-C 参考模型、或做复杂计算,每次寄存器访问都付一次代价,后门批量初始化几万次访问时仿真速度直接塌方。callback 保持轻量,重逻辑放 predictor 或独立组件。
这一篇在知识体系里的位置
本篇属于 chip-design/verification 目录下 RAL 专题的长尾扩展篇,向上承接 寄存器模型集成 的模型搭建与 RAL 前门与后门访问 的通路选择,横向与 RAL 后门 HDL 路径(后门怎么连)、RAL auto_predict 与显式预测(mirror 怎么同步)、RAL 覆盖率采样(访问之后怎么统计)互补,故障注入方向接 SV force/release 与后门注入。掌握 callback 之后,寄存器模型从「被动查表」变成「可编程的访问拦截层」,这是把 RAL 用活的标志。
总结
RAL callback(uvm_reg_cbs)在寄存器访问流水线上开了 pre/post read/write 四个钩子:pre 负责拦截(改值、换路径、注入故障),post 负责观察与补副作用(日志、W1C 联动、读清零建模),挂接层级按作用域选 reg/field/block;工程上要守住三条纪律——改 mirror 走标准 predict 流程不手改、谁注册谁摘除、callback 保持轻量,否则故障注入变环境污染、日志工具变性能黑洞。