UVM TLM 通信:analysis_port 与 imp 连接
更新时间:2026-09-24。本文是「集成电路大类 · 芯片设计」进阶层(intermediate) 验证方法学的一篇。组件构成与仿真阶段见 UVM 组件与 phase,监测与比对的整体分工见 sequence/driver/scoreboard。这一篇只聚焦一件事:monitor 采到一笔事务之后,怎样用 UVM TLM analysis_port 把它「广播」给所有关心它的组件,而又不让任何一方持有对方的句柄。
本文要回答的问题
- 为什么 monitor 不直接调用
scoreboard.write(t),非要绕一层 TLM 端口? - port、export、imp 三种端口各是什么角色,连接方向为什么不能反?
- 一个 analysis_port 连多个接收方是怎么做到的?
write()调用在时间上到底发生了什么? - analysis 连接为什么天生非阻塞?它和 put/get/peek 这类阻塞 TLM 端口有什么本质区别?
- 订阅者来不及实时处理时怎么办?
uvm_analysis_fifo接在哪里、谁负责排空?
一、为什么需要 TLM:从直接抓句柄到端口解耦
先看一种新手常写、却被验证方法学明确反对的写法:monitor 在 env 里拿到 scoreboard 的句柄,每采完一笔事务就直接 sb.expected_q.push_back(t),顺手再调 cov.sample(t)。功能上立刻能跑,但代价是 monitor 的代码里写死了「下游有谁」:今天有 scoreboard 和 coverage,明天要加一个 predictor、接一个断言模块、把 coverage 换成另一套,就得回头改 monitor 本身。一个本该最稳定、最可复用的组件,反而成了改动最频繁的地方。
**TLM(Transaction Level Modeling,事务级建模)**给出的答案是:组件之间不传递信号、不直接互调,而是在边界上放「端口」,通过端口收发事务(transaction,即一个封装好的数据包对象)。monitor 只知道「我有一个 analysis_port,采到东西就往上喊一嗓子」,根本不关心谁在听;env 在 connect_phase 里决定把这声「喊」接给哪些组件。于是 monitor 可以原封不动搬进另一个平台,订阅者也可以自由增删——这就是 UVM 组件复用的物理基础。
UVM TLM analysis_port 承担的正是这种「发布—订阅」角色,它是验证平台里出场率最高的 TLM 设施,几乎每个 agent 的 monitor 上都挂着一个。
顺带交代一笔事务对象的「身世」,因为它直接决定广播安不安全。monitor 每采完一笔,通常是先从工厂或 new 出一个事务对象,把地址、数据、传输类型、时序信息等字段填好,再发出去;这个对象是 class 实例,传出去的永远是句柄而不是内容副本。广播语义之所以在实践中成立,靠的是一条不成文约定:发布者发完之后不再修改这个对象,订阅者也只读不改。monitor 下一笔事务必须重新 new,而不是把同一个对象清空复用——否则前一秒刚发给五个订阅者的事务,下一秒字段全被覆盖,scoreboard 里排队等比对的数据会集体「变脸」。这条约定后面讲 fifo 和常见坑时还会用到。
二、端口三种角色:port、export 与 imp
UVM 的 TLM 端口按「数据流经过时的位置」分成三种角色,记住这三个词,后面所有连接规则都是它们的排列组合:
- port:发起方端口,事务从这里「出门」。monitor 上的
uvm_analysis_port就是 port,它只负责发出write。 - imp(implementation port):终点端口,真正提供方法实现的地方。
uvm_analysis_imp #(txn, scoreboard)要求它所在的 scoreboard 必须实现一个write(txn t)函数,广播到达时被回调的就是这个函数。 - export:中转端口,自己不实现方法,只把连接逐层向内转发。subscriber 对外暴露的
analysis_export、analysis_fifo 的analysis_export都是这一类——外部连到 export,export 内部再连到真正的 imp。
连接只有一个方向:port 连 export/imp,出口方主动发起 connect。写法是 aport.connect(aim),不能反过来写。一条连接链上,最外面是 port,中间可以串多层 export,最深处必须是一个 imp。事务类型参数也必须全程一致,#(txn) 对不上,编译期或 elaboration 期就会报错。
为什么要分这么细,不能让 monitor 直接连 scoreboard 内部的 imp 吗?小型环境里确实可以,前面的 scoreboard 就是这么做的。但一旦组件有层次,中转就不可避免:agent 是一个封闭封装,env 不可能越过 agent 的边界直接摸到 monitor;agent 就对外暴露一个 export,在自己内部把 export 连到 monitor 的 port——外部只面对 agent 的外壳,内部结构改了也不影响外面。fifo、subscriber 这类现成组件同理,它们对外给 export,把 imp 藏在肚子里。所以三角色的本质是**「谁发起、谁中转、谁实现」**:port 标记发起端,imp 标记方法真正落地的地方,export 负责让连接穿过封装边界。
两个实现细节写代码时经常碰到。第一,端口本身也是对象,必须在 build_phase 里 new,构造参数固定是 new("名字", this),第二个参数把端口绑定到所属组件,UVM 靠它做层次化路径检查;忘了 new,connect 时就是空句柄崩溃。第二,connect 只做「接线」,不检查也不搬运数据,真正的解析发生在 connect_phase 结束后,UVM 会沿链一路找到终点 imp 并缓存下来,运行期 write 的开销因此只是对一张小列表的遍历,不必担心每笔事务重复查层次。
三、一对多广播:一个 write,多个订阅者
analysis 系列端口和其他 TLM 端口最大的不同,是它天生支持一对多。一个 uvm_analysis_port 可以在 connect_phase 里被 connect 任意多次,UVM 内部为它维护一张接收方列表;运行时每发一笔事务,列表上的每个接收方都会收到同一个事务句柄。下图是一个典型 env 的连接拓扑:monitor 只有一个 analysis_port,下游同时接了三路。
读图抓住中间那个点:所有 fanout 都由 analysis_port 一个人记住,monitor 侧的代码与订阅者数量完全无关——连一个和连五个,monitor 都是那一行 ap.write(t)。scoreboard 用 analysis_imp 直接实现 write;coverage 通常继承 uvm_subscriber(它内部已经把 export、imp 和 write 链路搭好,子类只需覆写 write);predictor 同理用 imp 接收。三条连接彼此独立,任何一路 write 里报错都不会影响广播已经发出这一事实。
走一遍带数字的完整过程,时序感会更清楚。假设总线上先后出现三笔写传输:0x1000、0x1004、0x1008。monitor 在第一笔传输的最后一个时钟沿组装好 txn,调用一次 ap.write:scoreboard 当场拿它和参考模型对 0x1000 的期望比对,coverage 当场采样地址区间、突发类型等覆盖仓,predictor 当场把寄存器影子模型更新一笔——三件事在同一个仿真时刻全部完成,控制权才回到 monitor,随后总线才可能进入下一笔传输的周期。整个平台里不存在「0x1000 广播」这个单独的事件或时钟周期,它就是一次普通的函数嵌套调用。第二笔、第三笔重复同样的过程,每笔事务各自触发一轮完整 fanout。
还有两个关于拓扑的常见疑问。其一,发布者不一定是 monitor:参考模型算完一笔输出事务后,同样用 analysis_port 广播给 scoreboard,于是 scoreboard 分别订阅「实际侧 monitor」和「期望侧 reference model」,这是比对器的标准双输入接法。其二,imp 在一个组件里也不止一个:scoreboard 若要订阅两种不同类型的事务(实际侧、期望侧),就声明两个各自带类型参数和不同名字的 analysis_imp,并实现两个签名不同的 write,UVM 靠参数类型把调用分派到正确的那一个。
对应的代码骨架如下,连接全部集中在 env 的 connect_phase:
// ---- monitor 内部:只发布,不认识任何订阅者 ----
class bus_monitor extends uvm_monitor;
  uvm_analysis_port #(bus_txn) ap;
  function void build_phase(uvm_phase phase);
    ap = new("ap", this);
  endfunction
  task run_phase(uvm_phase phase);
    bus_txn t;
    forever begin
      collect_txn(t);      // 从 virtual interface 采样并组装事务
      ap.write(t);         // 一笔事务广播一次
    end
  endtask
endclass

// ---- scoreboard 内部:imp 要求本类提供 write ----
class bus_scoreboard extends uvm_scoreboard;
  uvm_analysis_imp #(bus_txn, bus_scoreboard) imp;
  function void build_phase(uvm_phase phase);
    imp = new("imp", this);
  endfunction
  function void write(bus_txn t);
    compare(t);            // 与参考模型期望值比对
  endfunction
endclass

// ---- coverage:继承 uvm_subscriber,覆写 write 即可 ----
class bus_cov extends uvm_subscriber #(bus_txn);
  function void write(bus_txn t); sample_covergroups(t); endfunction
endclass

// ---- env:在 connect_phase 决定 fanout ----
function void connect_phase(uvm_phase phase);
  mon.ap.connect(sb.imp);
  mon.ap.connect(cov.analysis_export);   // subscriber 对外是 export
  mon.ap.connect(pred.imp);              // 一对多:第三次 connect
endfunction
四、write 调用时序:非阻塞、零延迟、无握手
广播在仿真时间上是怎么发生的?关键一句话:write 是一个 function,不是 task。这意味着 monitor 调用 ap.write(t) 时并不让出仿真时间,UVM 顺着接收方列表逐一同步调用每个订阅者的 write,全部返回后,monitor 的这一行才算执行完。下图画出了这一次调用内部的嵌套顺序。
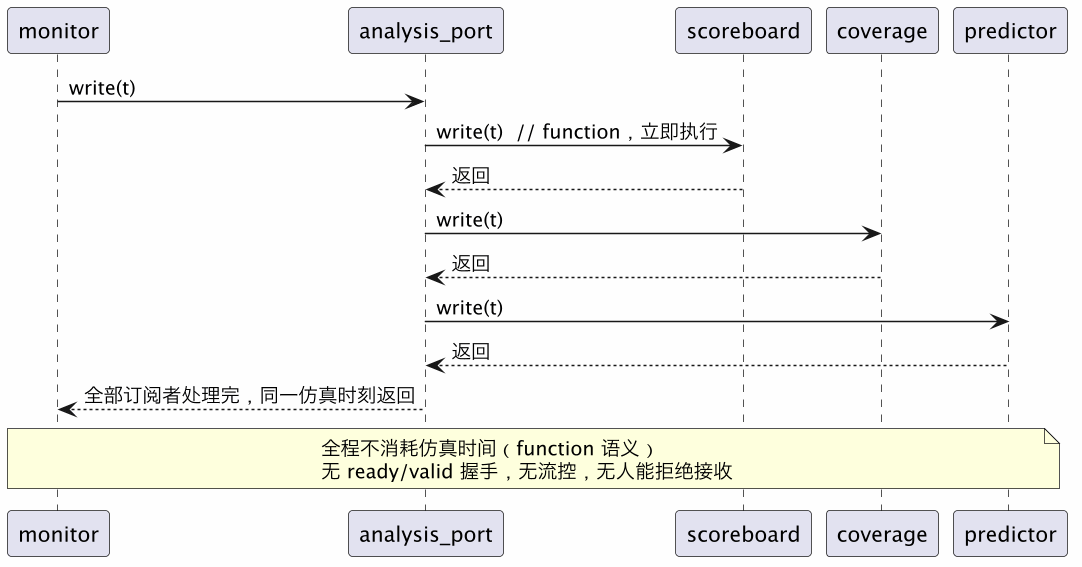
这张时序图解释了 analysis TLM 的三条硬性语义。其一,非阻塞、零仿真延迟:订阅者的 write 在调用方的栈上就地执行,不能在里面写耗时的 @(posedge clk) 或 #10,function 里出现时间控制语句本身就非法。其二,无握手、无流控:发布者不等任何人 ready,订阅者也没有办法「拒收」,write 必须立刻收下。其三,顺序固定:订阅者被回调的次序就是 connect 的先后次序,但工程上绝不该依赖这个次序——三个订阅者应当彼此独立,若 A 的 write 必须先于 B 生效,说明它们本就不该被拆成两个平级订阅者。
正因为没有任何等待,analysis 广播永远不会卡住 monitor 的采样节拍;代价是订阅者必须「当场」把事务处理完或先存起来,慢了不能用「阻塞回去」的方式施压发布者。
有人会问:既然回调是按 connect 顺序一个接一个执行,那一个订阅者 write 写得特别慢,会不会拖垮后面的人?会——但这里的「慢」只指函数体本身的零仿真时间开销,比如对超大数组做遍历比对,它拉长的是主机上的墙钟运行时间,而不是仿真时间,也不会改变任何事务的时序。应对方式不是把 write 改成 task(analysis 接口不允许),而是让重活退到 fifo 后面、在 run_phase 里慢慢算。换句话说,write 的理想形态永远是「收下来、记下来,立即返回」,真正的计算尽量移到 task 语境。同理,write 里应当避免打印刷屏、文件 IO 这类重操作,把它们留给消费侧。
关于异常还要知道一点:某个订阅者的 write 里若触发 uvm_error,UVM 默认只是计数并继续执行,回调链不会中断,后续订阅者照样收到这笔事务;这正是「一路出错不影响其他路」的机制来源。但如果 write 里出现 SystemVerilog 致命错误(比如空句柄解引用)导致进程直接终止,那波及的就是整个仿真,所以 write 的入口参数和内部句柄要做基本防御。
五、慢消费者:uvm_analysis_fifo 解耦生产与消费节奏
典型的麻烦是 scoreboard:它常常要等参考模型那边算出期望值才能比对,处理节奏天然比 monitor 慢,又不可能在 write(function)里等待。解决办法是在中间插一个 uvm_analysis_fifo:对发布者它表现为一个 analysis_export,可以被广播;对消费者它提供 get/peek 等阻塞端口。订阅者在 write 里什么都不用做——fifo 自己的 imp 把事务存进队列;消费者随后在自己的 run_phase(task)里按自己的节奏 get()。
// env 中:fifo 作为独立组件例化
uvm_analysis_fifo #(bus_txn) sb_fifo;

function void connect_phase(uvm_phase phase);
  mon.ap.connect(cov.analysis_export);   // coverage 实时处理,直连
  mon.ap.connect(sb_fifo.analysis_export); // scoreboard 经 fifo 订阅
  sb.ap_exp.connect(sb_fifo.blocking_get_export); // scoreboard 侧 get 出口
endfunction

// scoreboard run_phase:按自己的节奏消费
task run_phase(uvm_phase phase);
  bus_txn t;
  forever begin
    sb_fifo.get(t);      // 队列为空时阻塞等待,不占 CPU
    compare_with_reference(t);
  end
endtask
fifo 默认无容量上限,所以慢消费者不会让广播丢节拍,但也因此藏着两类真实事故:一是消费者中途出错、提前停止 get,fifo 无限积压,仿真内存持续上涨;二是仿真结束时队列里还压着未比对的事务,报告却显示通过。正规做法是在收尾阶段(check_phase 或利用 objection 的 drain 机制)检查 fifo.is_empty(),非空即报错。比对侧的对齐与超时策略可以配合 scoreboard 时序对齐 一起看。
fifo 的内部结构值得拆开看一眼,因为它解释了「为什么一个组件能同时被 write 又被 get」。它肚子里就是一个 SystemVerilog 队列外加两组 TLM 端口:朝向发布者的一侧,内部 imp 的 write 把事务 push 进队列;朝向消费者的一侧,挂着 blocking_get_export、nonblocking_get_export、get_peek_export 等一整套出口,get 在队列非空时弹出队首、为空时阻塞到新事务到来并立刻唤醒。所以 fifo 本质是一个带 TLM 外壳的线程安全邮箱,生产在 function 语境、消费在 task 语境,两侧通过队列握手,这正好补上了 analysis 接口「无流控」的短板。
消费侧除了阻塞 get,还有两种常用取法。不想被卡住可以用 try_get(t):有数据就取走并返回 1,没有立即返回 0,适合需要在等待时兼做别的检查的循环;peek 则只看队首不弹出,确认内容后再决定是否取走。运行中还可以用 fifo.used() 读当前积压深度做健康监控,比如在 long test 里周期性打印,深度单调增长往往就是消费者逻辑停摆的早期信号。多个慢消费者各用各的 fifo,彼此的队列互不影响;这也意味着前面说的 is_empty 收尾检查要逐个 fifo 做,任何一个非空都说明有广播「发了但没人处理完」。
六、analysis port 与阻塞 TLM 的对比,以及常见坑
analysis 家族只是 UVM TLM 的一半;另一半是 put/get/peek 等带握手的阻塞端口,它们服务于不同的通信形状。选型时按下表对照:
| 维度 | analysis_port(广播) | put/get/peek 阻塞端口 |
|---|---|---|
| 通信形状 | 一对多,发布—订阅 | 一对一,点对点 |
| 方法性质 | function,非阻塞,零仿真延迟 | task,可消耗仿真时间 |
| 流控/握手 | 无,订阅者不能拒收 | 有,put 等对端取走、get 等数据到来 |
| 典型发起方 | monitor 发布观测事务 | driver 向 sequencer 取事务等 |
| 接收方慢 | 靠 analysis_fifo 缓存解耦 | 天然背压,发送方自动等待 |
| 连接次数 | 一个 port 可 connect 多次 | 一个 port 通常只连一个出口 |
| 返回值/响应 | 纯通知,无返回 | get/peek 可拿回数据,支持双向 |
一个判断口诀:观测到的事实往外「喊」,用 analysis;需要对方配合、要等结果的「对话」,用阻塞端口。driver 从 sequencer 拉 sequence item 就是典型的 get 语义,而绝不会用 analysis。
最后汇总这一篇涉及的高频坑:
- 接收方没实现 write:
uvm_analysis_imp #(txn, comp)是带所属类参数的,comp 里必须有形如function void write(txn t)的精确签名,漏写则编译报错。 - connect 方向或类型不一致:只能 port 主动连 export/imp;整条链上事务参数类型必须相同。
- 多个订阅者忘连或重复连:env 复杂后维护一张 analysis 连接清单逐一核对,别靠仿真现象猜。
- fifo 不排空:收尾检查 is_empty,防止「没比完也算过」和内存积压。
- write 里写时间控制:function 中出现
@、#延迟直接非法;要等待就改走 fifo + run_phase。 - 跨组件直接抓变量:绕过 TLM 等于放弃解耦与复用,monitor 内部队列不应被外部伸手取。
- 订阅者共享事务被改:广播发的是同一个对象句柄,某一方就地修改会波及所有后续订阅者;需要留存就
$cast后 clone 一份。 - run_phase 阻塞 get 但无人写:没有广播源或连接漏接,进程永久挂死,配合 objection 超时机制暴露问题。
这一篇在知识体系里的位置
这一篇讲的是验证平台的「通信管道」。上游应先理解平台骨架与阶段机制:UVM 组件与 phase、sequence/driver/scoreboard 分工。横向相邻的主题包括覆盖率如何消费这些事务(代码功能覆盖率)、scoreboard 收到事务后怎样做时序对齐、寄存器模型的 predictor 如何订阅总线事务(UVM 寄存器模型集成)。想看 analysis_port 在完整协议环境里的整体接线,可参考 AXI UVM 环境。SystemVerilog 层面与 TLM 相近的原生同步原语(event/semaphore/mailbox)见 sv-event-semaphore-mailbox。
总结
UVM TLM analysis_port 是 monitor 的「发布—订阅」管道:一行非阻塞的 write 同步扇出给所有经 connect_phase 登记的 analysis_imp / subscriber,无握手、零仿真延迟、天然一对多;慢消费者用 uvm_analysis_fifo 把当场处理改成按节奏 get,并在收尾排空校验——它与需要握手的 put/get 阻塞端口互补,共同支撑起组件之间不持句柄、可独立复用的解耦结构。