MBIST 物理实现:collar 摆放、共享总线绕线规划与测试时钟切换全讲
更新时间:2026-10-03。MBIST(memory built-in self-test,存储器内建自测试)在逻辑侧怎么插、控制器怎么生成,本站 DFT scan 与 ATPG 和 DFT 物理实现 已经讲过;memory 宏时序弧 则从宏单元时序视角讲了 memory 接口的建立保持检查。这一篇换一个视角:MBIST 电路插进设计之后,它在版图上长什么样、摆在哪里、线怎么走、时钟怎么切。这些看似「体力活」的物理决策,恰恰决定 MBIST 是顺民还是刺头——collar 摆远了,测试总线绕半张芯片,功能时序和布线资源一起遭殃;时钟切换没规划好,CTS 阶段突然多出一棵测试时钟树,时钟资源直接爆掉。物理实现这一环做对了,MBIST 就是一张干净的旁路网;做错了,它是整个后端流程里最顽固的钉子户。
本文要回答的问题
- MBIST collar 是什么,为什么必须贴着 memory 宏摆,摆远了会出什么事?
- 多颗 memory 共享一个 BIST 控制器时,共享总线的绕线走廊怎么规划?
- 测试时钟和功能时钟在 MBIST 逻辑上怎么切换,物理上要处理哪些点?
- MBIST 插入对功能路径的时序侵入从哪里来,怎么隔离?
- MBIST 物理实现的标准流程长什么样,每一步的验收标准是什么?
一、MBIST collar 是什么:memory 的「测试外套」
先厘清术语。MBIST 系统由三块组成:BIST 控制器(controller,生成测试算法序列,比如 March C- 的读写模式)、collar(也叫 wrapper 或 interface logic,直接挂在某一颗 memory 宏的端口上,负责把控制器的命令翻译成这颗 memory 的地址、数据、读写使能,并在读出数据上做压缩比较)、以及把控制器和 collar 连起来的总线。控制器一个电压域或一个簇通常只有一个,collar 则是每颗 memory 一件「贴身外套」。
为什么 collar 必须独立存在?因为 memory 宏的接口千奇百怪:位宽不同、双口单口不同、有的带冗余行列修复(repair)端口、有的有 sleep 和 shut-down 电源管理脚。控制器只输出抽象的「测试算法步骤」,把这些步骤翻译成具体某颗 memory 的引脚时序,就是 collar 的活。collar 里通常还有多路复用器(mux):功能模式下,memory 的地址数据口接功能逻辑;测试模式下,切到 BIST 控制器。这个 mux 是 MBIST 对功能路径最主要的时序侵入点,第四节细讲。
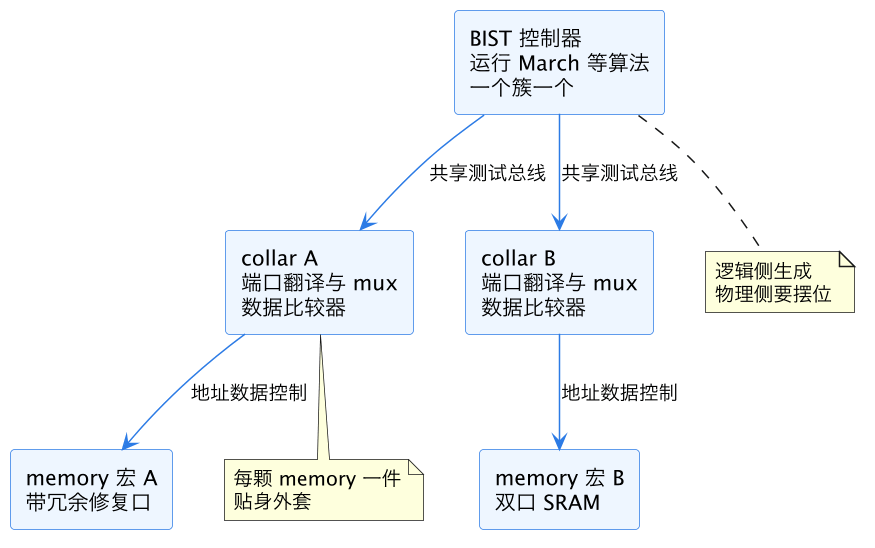
上图是 MBIST 的物理组成。读图重点是两层距离:控制器到 collar 是「中距离」总线,可以穿行一段版图;collar 到 memory 必须是「零距离」——这一段走线的质量直接决定 at-speed 测试能不能跑到额定频率。下一节就讲为什么。
二、collar 摆放:贴着 memory 的硬道理
collar 摆放的第一原则:物理上紧贴对应的 memory 宏,最好直接顶在 memory 的引脚侧边缘,走线长度控制在几十到一两百微米以内。这条原则背后的物理账很直白。
第一笔账是测试频率。现代 SRAM 的 at-speed MBIST 要求测试时钟跑在 memory 的额定功能频率上(先进工艺下动辄 1-2GHz 甚至更高),只有这样才能抓出真实的时序型缺陷(比如 transition fault 在 memory 内部的表现)。collar 里的比较器和 memory 的读出口之间就是一个寄存器到寄存器的时序弧,走线每多 200 微米,在先进工艺上可能多吃 20-50ps 的线延迟加串扰不确定性——1GHz 的周期只有 1000ps,测试路径的预算比功能路径还紧(功能路径有多年打磨的时序收敛,测试路径往往流片前一两个月才最终定型)。collar 摆远了,at-speed 测试频率就得降,测试覆盖率就打折,量产后漏出去的缺陷就是质量事故。
第二笔账是引脚对齐。memory 宏的引脚集中在某一两条边上,collar 贴着引脚侧摆,端口之间几乎是点对点的直连接,不需要绕线;如果 collar 被挤到 memory 的背面或隔着一个电压域,所有地址数据线都得绕过宏的边界,memory 宏本身是大面积布线障碍(通常只留最上面两三层金属可穿),绕行代价极高。
第三笔账是电源域。memory 和其 collar 必须在同一个可测试的电源状态下工作。memory 进了 retention 或 shut-down,collar 里的比较逻辑如果没有独立的状态保持,测试结果就乱了。所以 collar 一般和 memory 同域摆放,电压域 floorplan 里划电压域形状时就要把 collar 的位置预算进去。
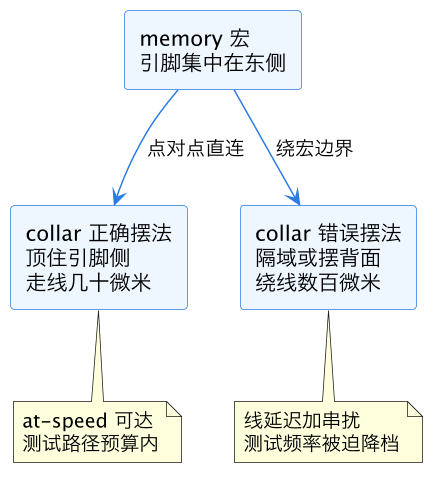
上图对比了 collar 的两种摆位结局。实战里「摆错」往往不是故意的,而是 floorplan 早期没给 collar 留位置——memory 摆得密不透风,BIST 逻辑插进来时只能见缝插针。所以 floorplan 宏单元摆放 阶段就要给每颗 memory 的引脚侧预留一条 collar 通道(通常按 memory 周长的某条边、宽度估几千到几万个标准单元),这是 MBIST 物理实现最上游的一个契约。
三、共享总线与绕线规划:控制器的「星形配送」
一个 SoC 上动辄几十上百颗 memory,一对一配控制器会把面积烧光,所以主流做法是一个控制器通过共享总线(shared bus)挂一串 collar,串行或分时测试。共享总线的物理形态是一条横贯 memory 密集区的「测试干线」,每颗 memory 的 collar 在干线上开一个「口子」接入。
共享总线的绕线规划要答三个问题。第一,走廊在哪:总线应沿 memory 排布带走直线,优先占用 memory 顶部的走线层或相邻 memory 之间的布线通道,避免穿越逻辑密集区——测试总线扇出大、翻转模式特殊,在逻辑区里穿行既占资源又引入串扰源。第二,拓扑怎么选:星形(控制器居中,总线放射到各簇)偏斜小但绕线多;链形(collar 一个串一个,daisy chain)绕线省但末端 collar 的时钟偏斜和信号质量差,链上某颗 memory 出问题还会拖累下游的测试调度。实战里常用「分簇星形 + 簇内链形」的混合拓扑,一簇内的 memory 距离近、链起来代价小,簇间走星形控制偏斜。第三,寄存器切片(pipeline):总线走长了必须在中途插寄存器切片,否则控制器到最远 collar 的走线延迟会限制整个测试时钟的频率;切片位置要在 floorplan 阶段就预留,事后补插常常无地可放。
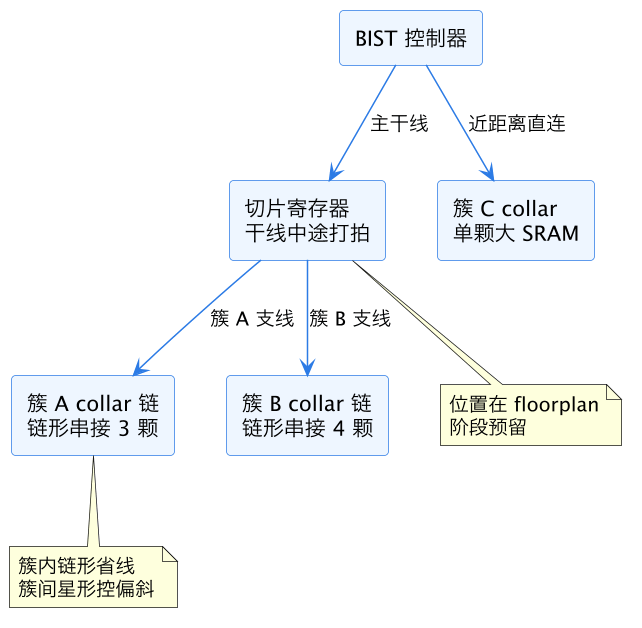
这张图是混合拓扑的典型形态。读图时盯住切片寄存器:它是总线时序的命门,也是最容易被遗忘的规划项。切片插进去之后,控制器到各簇的延迟被「打拍」规整,但代价是测试访问的流水深度增加,调度器要等拍——这是测试时间(test time)和物理可行性之间的经典交换。测试时间本身也是钱:测试机台按秒计费,测试图形数据流 讲过图形量与机台成本的关系,物理拓扑决定了测试调度的并行度上限。
| 拓扑 | 绕线代价 | 偏斜控制 | 故障隔离 | 适用场景 |
|---|---|---|---|---|
| 纯星形 | 高 | 最好 | 最好 | memory 少而分散 |
| 纯链形 | 最低 | 末端差 | 差,一颗拖累全链 | 小型嵌入式场景 |
| 簇内链加簇间星 | 中 | 好 | 好,按簇隔离 | 主流 SoC |
上表三种拓扑的取舍一目了然。选型时还要核对一件事:共享总线的线要不要走 NDR 或屏蔽?测试总线在 at-speed 下是高翻转信号,挨着功能关键路径走会引入串扰,NDR 与屏蔽时钟规则 那套方法对敏感邻段同样适用,但全面上 NDR 会把布线资源吃得太狠,一般只在总线与功能关键网长距离平行的段落局部使用。
四、测试时钟与功能时钟的切换:mux 的物理处理
MBIST 要跑 at-speed,测试时钟的频率就不能随便给个慢时钟了事——它必须能跑到 memory 的额定频率,所以测试时钟通常就取自功能时钟源,中间经过一个时钟选择 mux(OCC,on-chip clock controller,或简单的 clock mux)做切换:功能模式下 memory 时钟走功能树,测试模式下切到 BIST 控制器驱动的测试路径。
这个切换在逻辑上就是一个 mux,但物理上有四个必须处理的点。
第一,mux 的位置。时钟 mux 必须离 memory 的时钟引脚足够近,理由是 glitch 控制:切换瞬间的毛刺如果经过长走线会被放大和整形,可能打出非法脉冲把 memory 内部状态机打飞。靠近负载摆,mux 输出到 memory 时钟脚之间走线短、缓冲级数少,毛刺窗口可控。
第二,两棵树的资源共享。功能时钟树由 CTS 时钟树综合 精心构建,测试时钟如果另起一棵完整树,时钟资源(缓冲器面积、布线层、功耗)直接翻倍。聪明的做法是让测试时钟在 mux 之前尽量复用功能树的主干:两路时钟在靠近 memory 处才分叉进 mux,mux 上游共享同一段树干。这样 CTS 只需要保证 mux 两个输入端的偏斜预算,而不是给测试模式单独平衡一整棵树。
第三,多时钟域的 STA 覆盖。切换结构意味着每个 memory 时钟引脚上挂着两个时钟源,静态时序分析必须在功能模式和测试模式下分别签核,模式定义靠 SDC 的 case analysis 或 mode 约束区分。漏了测试模式的约束,等于 at-speed MBIST 从未被时序验证过——芯片回来测试频率跑不上去,没人知道是硅的问题还是签核漏了。
第四,切换控制信号本身。mux 的 select 来自测试控制逻辑(通常挂在 TAP 或测试模式寄存器上),这根信号要在整个测试窗口内稳定,且它的时序要按准静态处理(multicycle 或 false path),不能让它参与 at-speed 检查。
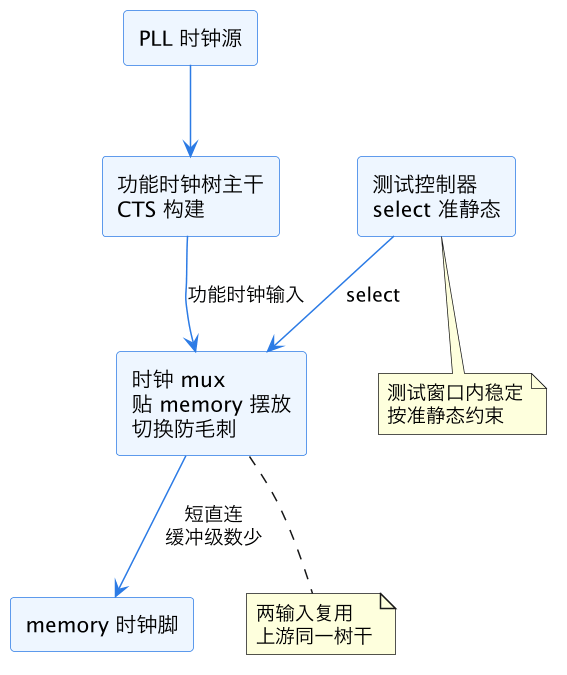
上图是时钟切换的物理结构。核心读法是「复用主干、就近分叉」:mux 越靠近 memory,两路时钟共享的树干越长,CTS 负担越小,毛刺路径越短。有些设计在 OCC 里还做了无毛刺切换(glitch-free mux,两个时钟都拉低后才换边),这类单元的摆放约束更严,要在 CTS 之前就以 fixed 状态钉死位置,否则 CTS 优化挪动它会把精心调好的偏斜打散。
五、时序侵入与隔离:让 MBIST 不当功能路径的绊脚石
MBIST 对功能时序的侵入主要来自 collar 里那个功能/测试 mux:它被串在 memory 的地址、数据、使能端口上,功能路径平白多走一级 mux(先进工艺下一级 2-1 mux 加走线大约十几到几十皮秒),memory 接口本来就是时序紧区(memory 宏时序弧 讲过接口弧的脾气),这一级插入有时就是压垮 setup 的最后一根稻草。
隔离手段有三层。第一层是 mux 选型与位置:用驱动能力足够的 mux 单元(或干脆用与门加或门的等价结构换取更优的延迟-面积点),并且把 mux 摆在 memory 引脚旁、让功能侧走线反而比插入前更短——很多设计 memory 引脚到功能逻辑本来就有一小段走线,把 mux 嵌进这段走线里,净增量可以做到接近零。第二层是时序预算显式化:在 SDC 里给 memory 接口路径单独留一份「MBIST 税」预算(比如每条接口路径预留 20-40ps),综合和布局阶段就按含税预算收敛,别等 PR 后期才发现接口路径集体挂掉。第三层是测试侧路径的独立签核:collar 内部路径、控制器到 collar 的总线路径,只在测试模式下检查,与功能模式互不污染——两套约束文件、两次 STA 跑批,覆盖关系画清楚。
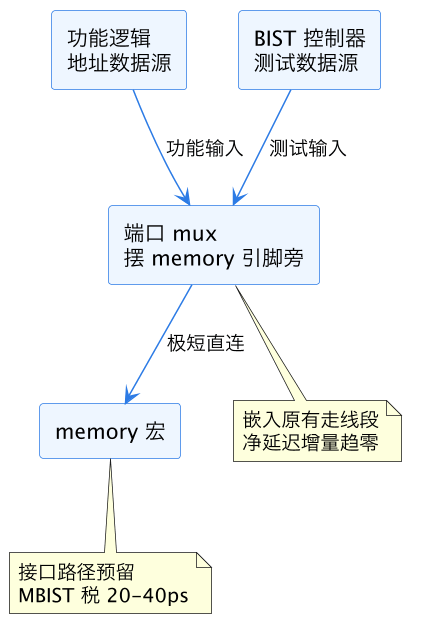
这张图是侵入隔离的核心手法。一句话:把 mux 变成「顺路的驿站」而不是「额外的收费站」。如果某颗 memory 的接口路径实在紧到吃不下这一级 mux,还有一招终极大法——直接观察(direct access)方案:测试时绕开功能 mux,用专用测试引脚直接驱动 memory,面积换时序。代价是额外的引脚和走线,只对极少数性能王冠上的 memory(比如 CPU 的一级缓存)值得用。
六、标准插入流程与验收清单
把前面五节串成一条可执行的流程,MBIST 物理实现的标准动作序列是:
- floorplan 阶段:按 memory 清单给每颗宏的引脚侧预留 collar 通道;划定测试总线走廊;预留切片寄存器坑位;把时钟 mux 位置以 fixed 属性钉在 memory 时钟脚附近。
- MBIST 逻辑插入(综合或 PR 前):生成控制器与 collar 网表,端口 mux 嵌入 memory 接口;此时功能侧时序预算已含 MBIST 税。
- 布局阶段:collar 逻辑用软指导(soft guide)或区域约束(region constraint)吸在对应 memory 旁,但不硬钉死,给布局器留优化余地;切片寄存器按预留坑位落位。
- CTS 阶段:功能与测试两个模式分别建树或共享主干,核对 mux 两输入端偏斜;测试模式时钟不确定性单独建模,STA 时钟 uncertainty 与抖动 的方法在这里按测试模式的实际激励源标定。
- 布线阶段:测试总线敏感邻段局部 NDR;检查 memory 顶部走线层的使用是否符合宏的布线阻挡规则。
- 签核阶段:功能模式与测试模式各自全 corner 签核 setup/hold;at-speed 测试路径按目标测试频率验收;测试模式的 max transition 和串扰也要过,因为测试总线长走线多。
| 阶段 | 关键验收项 | 不过的代价 |
|---|---|---|
| floorplan | collar 通道与走廊预留 | 后期 collar 见缝插针 |
| 布局 | collar 贴宏、走线达标 | at-speed 频率降档 |
| CTS | mux 两端偏斜、双模式树 | 测试模式时序无保障 |
| 布线 | 总线走廊、NDR 段落 | 串扰侵蚀功能路径 |
| 签核 | 双模式全 corner 通过 | 硅后测试跑不上频 |
这张表是流程的总检查单。每一行都是真实项目里交过学费的坑:最常见的是第一行——floorplan 没留通道,到 MBIST 插入时木已成舟,只能靠降测试频率兜底,而测试频率一降,at-speed 缺陷覆盖率就出现一个永远补不上的洞。
这一篇在知识体系里的位置
本篇是 eda/ 目录 DFT 物理实现线的 memory 专题,向上承接 DFT 物理实现 的总流程与 DFT scan 与 ATPG 的逻辑侧视角,横向连接 memory 时序(memory 宏时序弧)、floorplan 上游决策(floorplan 宏单元摆放、电压域 floorplan、floorplan 与 powerplan)、时钟与布线手艺(CTS 时钟树综合、NDR 与屏蔽时钟规则、STA 时钟 uncertainty 与抖动),向下接测试交付(测试图形数据流)。与 memory-macro-timing-arc 的宏时序视角互补:那篇讲 memory 接口弧怎么算,这篇讲测试电路在 memory 周围的物理落地。
总结
MBIST 物理实现的核心是让测试电路在版图上「各就各位」:collar 作为每颗 memory 的贴身外套必须顶住引脚侧摆放以保住 at-speed 测试频率,多颗 memory 共享控制器时用「簇内链形加簇间星形」的混合总线拓扑并在 floorplan 阶段预留走廊与切片寄存器坑位,测试时钟与功能时钟的切换 mux 贴 memory 时钟脚摆放、复用 CTS 主干并在功能与测试双模式下分别签核,端口 mux 对功能路径的时序侵入用「嵌入原走线段加显式 MBIST 税预算」消化;整条流程从 floorplan 预留到双模式签核六个阶段各有验收项,其中 collar 通道与总线走廊的上游预留是一切的地基——地基没打,后面每个阶段都在为它还债。