SV process 线程控制:fork join/join_any/join_none、process 类与 disable 全解
更新时间:2026-09-28。在 SystemVerilog testbench 基础 里,driver、monitor、checker 是三条同时活着的执行流;在 event、semaphore 与 mailbox 里,这些执行流靠同步原语交换数据。但「流」本身怎么生、怎么等、怎么杀,是那两篇没有展开的话题。这一篇专门讲 SV process 线程控制:fork 的三种汇合语义、
process类这把「线程句柄」、以及disable在并发代码里到底砍掉了谁。
本文要回答的问题
- fork join、fork join_any、fork join_none 三种汇合点到底差在哪,各自的等待边界是什么?
- join_none 的后台线程为什么会在父任务返回后「继续活着」,它由谁回收?
- process 类的 self、await、kill、status 四个操作能解决什么问题?
- disable fork 和 disable 命名块分别砍掉哪些线程,为什么一不小心就把无关线程杀了?
- 超时看门狗、并行激励、后台 monitor 这三类典型场景各该用哪种组合?
一、为什么 testbench 离不开并发
一个最朴素的激励任务——「发一个包,等响应,检查结果」——在信号级就得拆成至少两条线:一条驱动总线,一条等响应,因为响应可能在你驱动还没结束时就回来了。单线程写法要么漏采响应,要么把驱动节奏拖慢。SystemVerilog 给出的答案是仿真器原生并发:fork ... join 把多个 begin-end 块变成并行执行的线程,仿真器在同一个时间片内轮流调度它们。
和软件线程不同,SV 线程只在「遇到会消耗仿真时间的语句」(延时、@(事件)、阻塞方法调用)时让出调度权,纯计算代码一口气跑完。这意味着线程之间的交错只发生在你显式等待的点上——理解这一点,才能解释后面所有「为什么我的 fork 顺序和想的不一样」的疑惑。
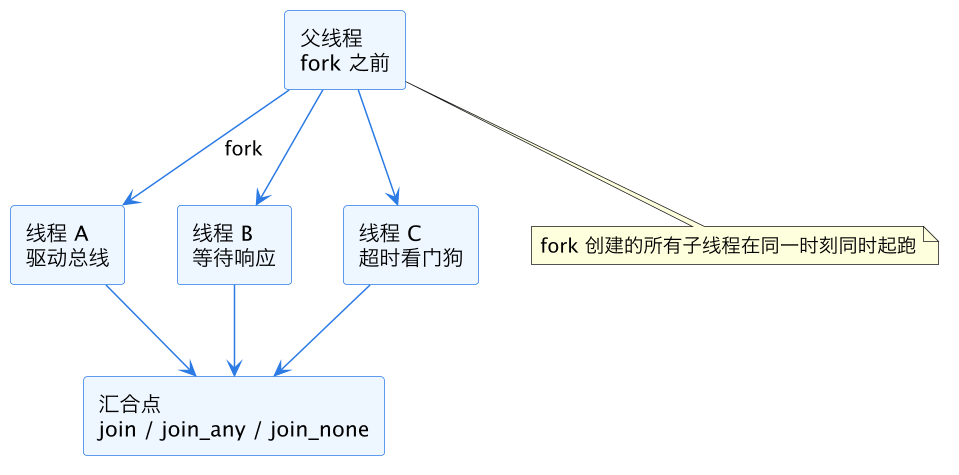
上图是 fork 的基本形态:父线程在 fork 处一分多路,所有子线程同时起步,各自独立前进,最终在汇合点重新收口。三种 join 关键字的区别,全部体现在这个「收口」怎么收上。
二、fork join:全部到齐才放行
fork ... join 是语义最朴素的一种:父线程阻塞在 join 处,直到所有子线程都执行完才继续。它适合「几件有明确终点的事并行做,然后一起往下走」的场景,比如同时拉高几路激励、各自跑完固定拍数后再检查状态。
task drive_two_agents();
  fork
    begin : blk_a
      agent_a_driver.run(20);   // 跑 20 拍
    end
    begin : blk_b
      agent_b_driver.run(35);   // 跑 35 拍
    end
  join
  // 两条都跑完才到这里,此刻是两路激励都结束的时间点
  check_idle();
endtask
这个例子里 join 的实际等待时长是两个分支中较长的那个:35 拍。一个高频考点是「fork 里循环 spawn 出来的线程算不算 join 的子线程」——算。fork-join 块内创建的线程,包括循环展开产生的每一个,都是这棵 fork 树的成员,join 会等它们全部结束。很多「join 卡死」的 bug,根源是分支里有个 forever 循环永远不会自然退出,join 于是等到天荒地老。这类线程就不该放在 join 里等,要么改用 join_any,要么用后面讲的 disable 主动收尾。
| 汇合方式 | 父线程何时继续 | 未结束的子线程去向 | 典型场景 |
|---|---|---|---|
| join | 所有子线程结束 | 不存在未结束者 | 有限长并行任务 |
| join_any | 任一子线程结束 | 继续运行 | 看门狗 + 干活线程 |
| join_none | 立即继续 | 后台继续运行 | 常驻 monitor、后台服务 |
三、fork join_any:先到先走,剩下的怎么办
fork ... join_any 在任一子线程结束时放行父线程,其余子线程不被打扰、继续执行。它是超时机制的标准写法:一条干活、一条看门狗,谁先到听谁的。
task send_with_timeout(txn_t tx);
  fork
    begin : work
      driver.send(tx);
      wait(tx.done);            // 事务完成
    end
    begin : watchdog
      #10us;
      `uvm_fatal("TIMEOUT", "transaction not done in 10us")
    end
  join_any
endtask
join_any 放行之后,那个没跑完的线程还活着。上面这段代码有个真实的坑:事务正常完成时 work 分支先结束,join_any 放行,但 watchdog 分支的 #10us 还在计时,10us 后照样触发 fatal——超时误报。正确姿势是在 join_any 之后立刻 disable fork,把剩余的兄弟线程清掉,这是第五节的主题。
join_any 的另一个用途是「多个响应先到先处理」:fork 出几条等待不同通道响应的线程,join_any 拿到最早回来的那个先走流程,后续响应由外层循环再次 fork 等待。这种写法在乱序总线(比如 AXI 多 outstanding)的 scoreboard 侧很常见,与 AXI UVM 环境搭建 里处理乱序响应的思路一脉相承。
四、fork join_none:发射后不管
fork ... join_none 让父线程完全不等待,子线程转入后台执行,父线程立刻继续往下走。它是常驻服务的唯一正确形态:monitor 的 forever 采样循环、覆盖率收集线程,都应该 join_none 启动,否则主流程永远卡在 join 上。
task run_phase_body();
  fork
    monitor_loop();        // forever 循环,永不结束
    coverage_loop();
  join_none
  // 父线程立刻到达这里,继续注册 objection 等
endtask
join_none 有一个容易踩的调度细节:父线程是「立刻」继续,而子线程的第一次执行被推迟到父线程下一次让出调度权时。也就是说 join_none 后面紧跟的语句先于任何子线程的第一行执行。如果子线程依赖父线程随后才设置的变量,时序上看似没问题;反过来,如果父线程紧接着修改变量而子线程以为拿到的是旧值,就出现竞争。工程惯例是:fork 之前把子线程要用的参数按值传进局部变量,别让后台线程去读一个父线程还在改的东西。
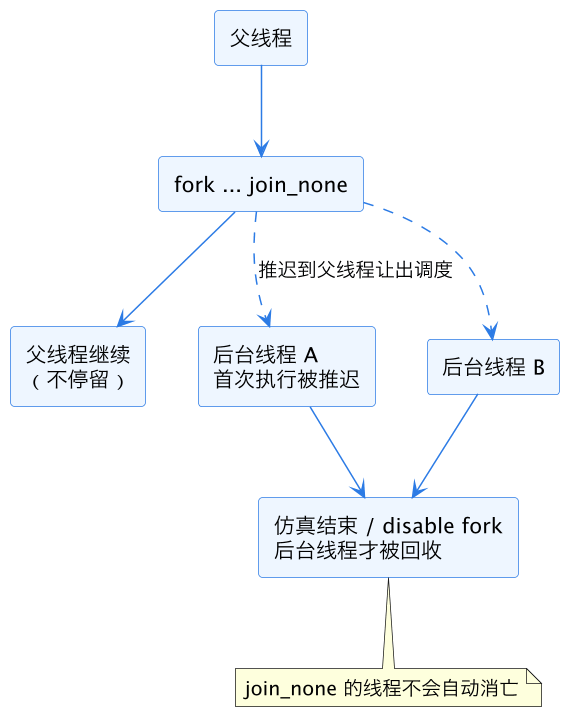
上图想强调的正是回收问题:join_none 的线程没有自然死亡保证。用例结束时如果它们还在 forever 空转,UVM 靠 phase objection 的 drop 机制和仿真器在 phase 跳转时的清理来兜底,但在裸 SV testbench 里你必须自己管——要么保留 process 句柄手动 kill,要么在收尾处 disable fork。放任不管的后台线程是「上个用例的激励串到下个用例」这类灵异 bug 的头号来源。
五、process 类:给线程一个句柄
前面三种 join 都是「结构性」控制——在 fork 的语法边界内决定怎么等。很多时候需要的是「指名道姓」地操作某一条线程:等它、杀它、问它死没死。SystemVerilog 的内建类 process 就是线程的句柄类型,和句柄机制在 SystemVerilog 内存管理与垃圾回收 里讲的对象句柄是同一套思路。
process::self() 返回当前线程自己的句柄;把句柄存进变量,之后就拥有了对这条线程的四个操作:
class watchdog;
  process th;
  task arm(time budget);
    fork
      begin
        th = process::self();      // 记下自己
        #budget;
        `uvm_fatal("WD", "timeout")
      end
    join_none
  endtask
  task disarm();
    if (th != null && th.status() != process::FINISHED)
      th.kill();                   // 事务正常完成,杀掉看门狗
  endtask
endclass
四个操作的语义:- await():阻塞当前线程直到目标线程结束,相当于点对点的 join。
kill():立刻终止目标线程及其 fork 出来的所有后代。status():返回状态枚举(FINISHED / RUNNING / WAITING / SUSPENDED / KILLED),判断线程是否还活着。suspend()/resume():挂起与恢复,实际项目里极少用,因为挂起一个正拿着 mailbox 或 semaphore 的线程极易造成死锁。
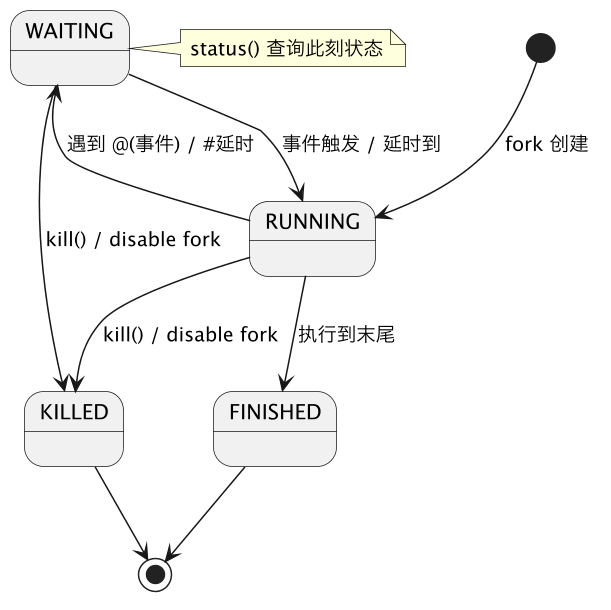
这张状态图值得记的是两个终止入口:自然死亡只有「执行到末尾」一条路,其余都是被外部力量终结。kill 对 WAITING 状态的线程同样生效——它不会等那个 10us 延时走完再死,而是当下就把线程从调度队列里摘除,这正是看门狗 disarm 能立刻解除威胁的原因。
process 句柄还能解决 join_none 的参数传递难题。循环里 join_none 起 N 条线程时,把循环变量按值拷进每条线程的自动变量,再配合句柄数组收齐:
process kids[int];
for (int i = 0; i < N; i++) begin
  automatic int idx = i;          // 按值捕获,关键!
  fork
    begin
      kids[idx] = process::self();
      worker(idx);
    end
  join_none
end
// 之后可以逐条 await,也可以在收尾统一 kill
foreach (kids[i]) kids[i].await();
漏掉 automatic 声明是教科书级 bug:所有线程共享同一个 i,fork 的推迟执行让它们起步时读到的都是循环结束后的值。加上 automatic 后每次迭代一份拷贝,线程各拿各的。
六、disable fork 与命名块:精确打击和误伤
disable fork 终止当前线程的 fork 树里所有还没结束的子线程。注意作用域是「当前线程」——它是从调用点往下砍的一整棵子树,不是全局清场。它和 join_any 是官配组合:
fork
  begin : work
    do_something();
  end
  begin : watchdog
    #10us;
    `uvm_fatal("WD", "timeout")
  end
join_any
disable fork;          // 谁先到,剩下的那个在这里被清掉
更古老的写法是 disable <命名块>:给 begin-end 块起名,然后 disable watchdog 只杀那一个块里的线程。粒度更细,但有两个限制:名字必须在词法作用域内可见,跨任务 disable 别人内部的块做不到;而且一个块被多处并发调用时,disable 会停掉所有活跃实例,想精准杀某一次调用就得靠 process 句柄。
最容易踩的坑是 disable 的「株连」效应。老代码里常见任务末尾写一句 disable fork 求心安,如果这个任务本身是被更外层 fork 出来的子线程,这行代码会连同父线程 fork 树里自己的兄弟线程一起砍掉——disable fork 砍的是「当前线程创建的所有后代」,而一个 join_none 任务里的 disable fork,作用范围恰好在它自己的子树,看似安全;但如果把 disable 写成了命名块形式、而那个块名在父任务里也有重名,或者任务被嵌套调用,波及面就完全失控。判断准则只有一条:动手前先画一遍线程树,确认砍掉的子树里没有无辜线程。
| 手段 | 作用范围 | 能否跨任务 | 典型用途 |
|---|---|---|---|
| disable fork | 当前线程的全部后代线程 | 否 | join_any 后收尾 |
| disable 命名块 | 该块的所有活跃实例 | 受限(需可见) | 老代码、单块取消 |
| process::kill | 句柄指向的线程及其后代 | 是 | 精确杀某条后台线程 |
七、三个典型场景的组合拳
把前面的零件拼成三张常用配方。
场景一:带超时的操作——join_any + disable fork。干活线程和看门狗线程 fork 出去,join_any 等先到者,disable fork 清场。这是使用频率最高的并发模式,几乎每个 driver 里都有。
场景二:N 路并行激励 + 全部完成——循环 fork join_none + process 句柄数组 + 逐个 await。比单层 fork join 灵活:可以中途按条件杀掉队的那一路,也可以在 await 前插入超时逻辑。每个 worker 的参数用 automatic 局部变量按值传递。
场景三:常驻后台服务——join_none 启动 + 句柄存档 + 用例收尾统一 kill。monitor、coverage、协议后台线程都属此类。收尾代码放在 test 的 final_phase 或显式的 shutdown 任务里,确保跨用例无残留。
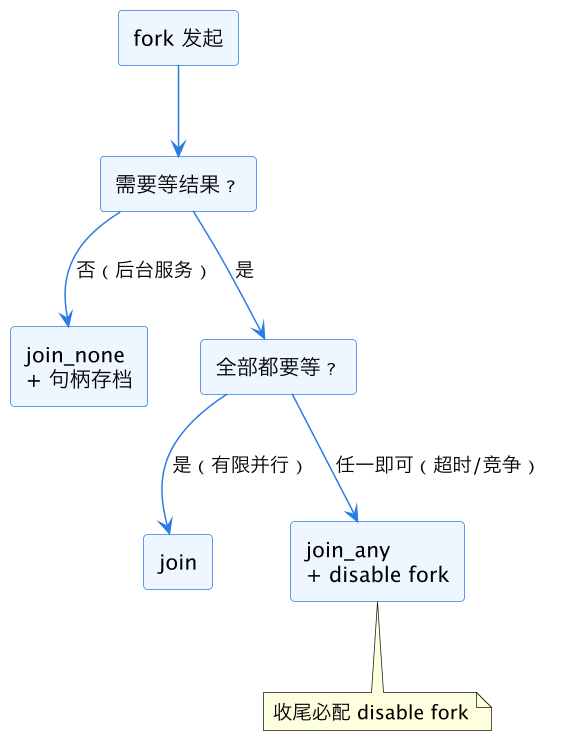
这张决策图可以直接当检查清单用:写 fork 前先问「我要不要等」「等一个还是等全部」,答案唯一确定汇合关键字,剩下要补的只是 join_any 之后的 disable fork 和 join_none 之后的句柄管理。
八、常见坑
- join 里放
forever线程:join 永不返回,任务卡死;常驻线程一律 join_none 或 join_any 配 disable。 - join_any 后忘写 disable fork:看门狗线程残留,超时在事务成功后误触发 fatal。
- 循环 fork 不用 automatic:所有子线程读到循环结束后的变量值,激励内容全部串号。
- 以为 join_none 的子线程立刻执行:其实推迟到父线程让出调度权,父子之间的初始化顺序要按这个规则设计。
- 滥用 disable 命名块:重名块、并发实例被一起停掉,杀错线程还不如不杀;新代码优先 process 句柄。
- suspend 一个持锁线程:它挂起时占着 semaphore/mailbox,其他线程全部堵死,基本等同于死锁制造机。
- 用例结束不回收 join_none 线程:后台线程跨用例泄漏,下一个用例看到幽灵激励;收尾统一 kill 或靠 phase 机制兜底并验证。
这一篇在知识体系里的位置
- 向上承接:SystemVerilog testbench 基础 给出 testbench 整体骨架,本篇补上其中并发执行流的创建与回收机制。
- 横向相关:event、semaphore 与 mailbox 讲线程之间怎么同步与传数据,本篇讲线程本身怎么管,两者是同一枚硬币的两面。
- 机制延伸:SystemVerilog 内存管理与垃圾回收 解释句柄与对象生命周期,process 句柄遵循同一套引用语义。
- 落地延伸:UVM 组件与 phase 中每个组件的 run_phase 本质就是一棵 fork 树,phase 跳转时的线程清理依赖本篇讲的回收机制。
总结
SV process 线程控制的核心是三件事:用 join / join_any / join_none 选择汇合语义(全等、等一个、不等),用 process 类句柄对具体线程做 await / kill / status 的指名操作,用 disable fork 在 join_any 之后清掉残留兄弟线程——再配上 automatic 按值传参和用例收尾的统一回收,并发 testbench 就从「能跑」变成「可控」。