FPGA 入门 17:神经网络与 FPGA——推理在硬件上长什么样
更新时间:2026-09-12。本文是
fpga/入门层第 19 篇。选型直觉见 FPGA vs CPU/GPU,乘法器资源见进阶 DSP48 与算术,量化的定点基础见进阶 定点数与 DSP 设计,HLS 流程见进阶 HLS 入门;AI 加速架构深论见专家层《FPGA AI 推理加速》(后续),系统学神经网络原理见独立的 神经网络与深度学习域(nn/)。
本文要回答的问题
- 剥掉术语,一个神经元、一层网络在硬件上到底在算什么?为什么说推理 99% 是乘加(MAC)?
- 训练和推理有什么区别,FPGA 主要参与哪一半、为什么?
- 量化(FP32 到 INT8/INT4)为什么能几乎不掉精度却大幅提速、省带宽?它和定点数是什么关系?
- 一个神经网络加速器在 FPGA 内部大致长什么样:DSP、BRAM、MAC 阵列、数据流、权重都放在哪?
- 算力(TOPS)和带宽分别怎样决定性能?为什么很多网络实际是「带宽受限」?
- 为什么工程上通常不手写整网 RTL?Vitis AI / OpenVINO、HLS、手写 RTL 三条路线怎么选?
- ReLU、池化、卷积滑窗这些层,分别对应什么简单硬件?
- FPGA 做 AI 相对 GPU/ASIC 的优势和劣势各是什么,适合什么部署场景?
读完本文,你不需要会训练模型,也能在硬件层面「看懂」一个神经网络在 FPGA 上是怎么跑起来的,并建立判断 AI 加速方案的工程直觉。
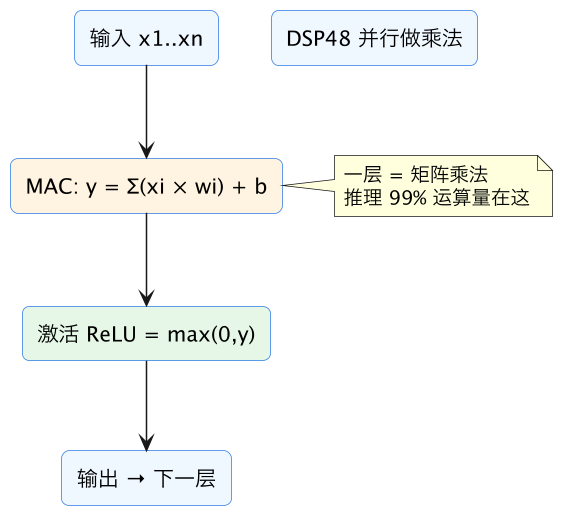
一、神经元 = 一次乘加
二、训练 vs 推理
| 训练 | 推理(FPGA 主战场) | |
|---|---|---|
| 做什么 | 学权重(反向传播) | 前向计算出结果 |
| 在哪 | GPU 集群、浮点 | 边缘/数据中心,可 INT8 |
| 权重 | 不断更新 | 固定(存 BRAM/DDR) |
| 特点 | 算力巨大、离线 | 低延迟、低功耗、流水线 |
三、量化为什么关键
- FP32 乘加:慢、费 DSP、带宽压力大;
- INT8:一个 DSP 做 2 个乘法、权重小 4 倍、精度几乎不掉;
- 本质 = 定点数设计(scale 因子、截位、防溢出)。
四、部署方式
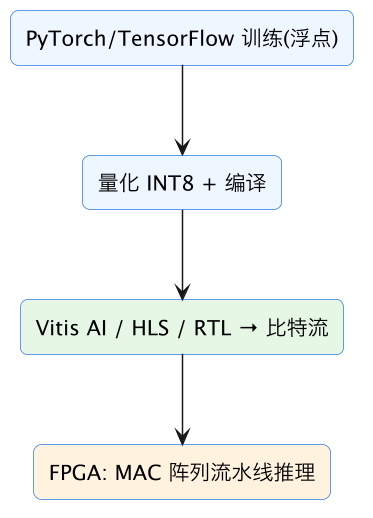
多数人用厂商工具链(Vitis AI/OpenVINO),不手写整网;定制算子用 HLS。
五、从一个神经元到一片 MAC 阵列
神经元的计算是 y = activation(Σ xi·wi + b)。硬件把它拆成三个朴素操作:乘法(xi×wi)、加法树/累加器(把乘积累加)、激活(一个简单函数)。一层有 N 个输入、M 个输出神经元,就是 N×M 次乘法加 M 路累加,本质是一次矩阵乘向量(全连接层)或卷积窗口上的乘加。
- MAC(Multiply-Accumulate)单元:一个乘法器接一个累加器,每个时钟周期完成一次「相乘并加进累加器」。FPGA 里乘法优先映射到专用 DSP 块(如 DSP48,内部就有乘法器和加法器,见 DSP48 入门)。
- 并行阵列:摆 N 个 MAC 并排,一拍就能做 N 个乘加;再用流水线把「取权重—相乘—累加—激活」切成多级,阵列每个周期都吃进新数据,吞吐 = 阵列规模 × 频率。这正是 FPGA 相对顺序执行处理器的根本优势:你要多少并行乘法器,就摆多少。
- 累加器要留位宽:K 个 W 位乘积累加,结果位宽约 2W+log₂K,否则高位被截,数值错误——这与 数据类型与位宽 的进位规则完全一致,只是规模更大。
卷积层在算什么
卷积用一个小权重窗口(如 3×3)在输入特征图上滑动,每个位置把窗口内像素与权重逐对相乘再求和,得到输出特征图的一个点。不同输出通道用不同权重窗口。硬件实现就是:缓存若干行像素形成滑窗、对窗口做并行乘加、结果过激活/池化。它仍然是密集乘加,只是数据复用方式(权重复用、行缓存复用)决定了片上存储怎么组织。
ReLU、池化、Softmax 的硬件长相
- ReLU 就是
max(0, x):看符号位,负则输出 0,一个比较器/选择器即可; - 池化(max/average pooling)是局部窗口取最大或均值:比较器树 +(可选)移位除法;
- 批归一化(BN)在推理时常被折叠进权重和偏置,变成一次乘加;
- Softmax 含指数/除法,通常放最后一层用查表或软件做,不是主算力。
所以除了最后这些「边角」,网络 99% 的硅片面积和功耗都花在规整的乘加上。
六、量化:把浮点问题变成整数问题
训练通常用 FP32(32 位浮点)甚至混合精度;推理时把权重和激活量化成 INT8/INT4,精度通常只下降约 1% 以内,但硬件收益巨大。量化的数学本质是用一个尺度因子 scale 把实数映射到整数:x_int ≈ round(x_real / scale) + zero_point,整数乘加后再按 scale 还原(对称量化时 zero_point 为 0)。
对 FPGA 的三重收益:
- 算力翻倍:一块 DSP 做一个 18×18 有符号乘法;做 INT8 时可拆成多个低精度乘法,单位 DSP 每秒操作数成倍增加。
- 带宽和存储大降:权重从 4 字节降到 1 字节(INT8)甚至半字节(INT4),同样片上 BRAM/外部 DDR 带宽能喂四倍以上的数据。深度网络常常是带宽受限而非算力受限,这点收益尤其关键。
- 逻辑和功耗更省:整数乘法器比浮点单元小得多、省 LUT/DSP、翻转功耗低。
两条量化路线:PTQ(训练后量化,直接对现成模型校准,简单,最常用)和 QAT(量化感知训练,训练中模拟量化误差,精度更好)。工程难点是尺度因子选择、激活异常值处理和累加截位/饱和——这些就是 定点数基础 与进阶 定点数与 DSP 设计 的内容在 AI 上的直接应用。
算力 vs 带宽:屋顶图直觉
性能同时受两个上限约束:①算力上限=MAC 数 × 频率(每秒能做多少乘加);②带宽上限=每秒能搬多少字节,而每次 MAC 需要权重和激活数据。算术强度(每搬一字节做多少次计算)决定你撞哪个上限。权重复用充分(如卷积中一个权重被很多像素共用)时算术强度高,容易吃满算力;权重只用一次(如某些全连接/大 batch=1 场景)时,阵列常常饿着等数据。设计加速器的核心工作之一就是安排数据复用、用片上 BRAM 缓存权重和特征图、减少对 DDR 的访问。
七、一个 FPGA 加速器的典型结构
把上面概念落到框图,一个推理加速器通常包含:
- MAC 阵列(计算核心):成百上千个 DSP 组成的脉动/并行阵列,做矩阵乘/卷积;
- 片上缓存:权重、激活、部分和存在 BRAM/URAM,按阵列节奏供给(见 BRAM 与分布式 RAM);
- DMA / 数据流控制:在 DDR 与片上缓存间批量搬运,常配合 AXI 流/内存映射接口;
- 控制单元:一个状态机(见 状态机入门)按层组织「搬入—计算—搬出」的节拍;
- 激活/池化单元:紧跟 MAC 输出的简单组合/流水逻辑;
- 软核/CPU 协同:Nios II/MicroBlaze 或 PS 端负责配置、调度、跑非规整层和 Softmax。
数据像流水线一样从 DDR 经片上缓存流过 MAC 阵列,每一级每拍产出部分结果——这种「数据流架构」没有取指/译码、没有缓存未命中,延迟由流水拍数确定,这正是 FPGA 在低延迟推理上的结构性优势(与 GPU 对比见 GPU 计算与 FPGA 对照)。
八、怎么真正把模型放上 FPGA:三条路线
手写整网 Verilog 几乎不现实(一个中型网络就是几百万次乘加),实际开发分三层,按抽象程度从高到低:
- 厂商 AI 工具链(最常用):AMD/Xilinx 的 Vitis AI、Intel 对 OpenVINO/oneAPI 的 FPGA 支持等。流程是在 PyTorch/TensorFlow 训练 → 导出 → 量化(INT8)→ 编译器把算子映射到预置的高性能 MAC 阵列 IP(DPU/BNN 类)→ 生成比特流;主机端通过运行时 API 发数据、取结果。你主要在做「模型准备、量化校准、调度集成」,不写 RTL。
- HLS(C/C++ 定制):当预置 IP 不支持某算子、或要压榨特定网络时,用高层综合写 C++,加 pipeline/unroll/array partition 等指导,综合成 RTL(见进阶 HLS 入门)。研究和定制加速常用。
- 手写 RTL(教学/极致优化):只在很小的网络、单个算子或教学时做——一个 MAC 单元、一个阵列控制器、一个 FSM,本文前面讲的所有 Verilog 基本功在这里全用得上。
新手路径建议:先用本文建立「推理=并行 MAC + 数据流 + 定点量化」的硬件直觉 → 用工具链跑通一个现成 demo(如 MNIST/YOLO 小模型)理解数据进出 → 需要定制时再下钻 HLS,最后才是手写 RTL。
九、用数字建立直觉:延迟、吞吐与资源
拿一个简化的全连接层估算(理解量级即可):输入 256、输出 128,共 256×128 = 32768 次乘加。
- 若 FPGA 上摆 256 个 MAC、跑 200MHz,理想情况下每拍阵列做 256 次乘加,约 128 拍(≈0.64 微秒计算时间)算完一层,再加取权重/数据的开销。
- 权重 32768 个,INT8 约 32KB——片上 BRAM 能装下一部分,其余从 DDR 搬;FP32 则 128KB,更依赖带宽。
- 延迟由「数据从进来到出去经过的流水拍数」决定(确定、可做到亚微秒);吞吐由阵列规模、频率、能否持续喂满决定。
- GPU 做这一极小层反而吃亏:kernel 启动和数据搬运是微秒级固定开销,几千个核根本喂不饱;FPGA 的固定流水延迟在这种小批量、低延迟场景占优(详见 GPU 与 FPGA 对照)。
这也解释了应用分工:大批量训练/吞吐型推理在 GPU,小批量、确定性延迟、贴近传感器前处理、需要自定义接口的推理下沉 FPGA,量产且模型稳定、量极大时再考虑 ASIC(开发成本高、不灵活但单位成本/功耗最优)。
资源账怎么看
打开 FPGA 数据手册会看到 DSP 数、BRAM 容量、逻辑单元数、外部内存带宽。AI 工程的早期估算就是:每秒乘加需求 ÷ 每 DSP 每秒乘加数(考虑量化倍率)估 DSP;权重/激活驻留与复用估 BRAM/DDR 带宽;控制和软逻辑估 LUT/FF。估算后若某项远超芯片,就要么换更强芯片、要么量化更狠、要么改数据复用策略。资源报告读法见 资源利用率。
十、自测要点与学习地图
自测:① 写出一个神经元的乘加公式,说明一层为何是矩阵乘;② 说出训练与推理的区别及 FPGA 主打哪半;③ 解释 INT8 量化在算力、带宽、功耗上的三个收益及 PTQ/QAT;④ 画出加速器的主要组成(MAC 阵列、BRAM、DMA、控制 FSM、激活单元);⑤ 说明算术强度如何决定撞算力墙还是带宽墙;⑥ 列出三条实现路线及各自适用场景;⑦ 用一个 256×128 层做量级延迟估算;⑧ 说明 FPGA/GPU/ASIC 在 AI 上的取舍。
学习地图:先有选型大局观 FPGA vs CPU/GPU 与 GPU 对照;硬件资源看 DSP48、BRAM、定点数基础;控制器就是状态机 FSM 入门;实现路径看进阶 定点 DSP 设计、HLS 入门;想懂网络算法本身去独立的 神经网络域(nn/)。
十一、常见网络在 FPGA 上的友好度
不同网络对硬件的友好程度差别很大,入门阶段先有个定性认识:
- CNN(卷积网络,图像为主):卷积是规整的密集乘加、权重复用高、算术强度大,最适合 MAC 阵列流水化,是 FPGA AI 加速的经典场景(检测、分类、工业质检)。
- 全连接 MLP:参数多、每权重复用低,偏带宽受限,量化收益明显,适合很小的网络或作为 CNN 的尾部。
- RNN/LSTM:含按时间步的串行依赖,并行度受限于序列长度,加速器要处理门控乘加与隐藏状态,吞吐不如 CNN 规整。
- Transformer/注意力:大矩阵乘很适合阵列,但注意力里的 softmax、动态形状和大显存带宽是难点;现实多靠量化、算子裁剪和高带宽存储解决。
- 二值/极低比特网络:乘法变成异或/查表,极端省资源,适合把小网络塞进低端 FPGA,代价是精度和可训练性。
选型直觉:网络越「规整、静态、可量化、复用高」,FPGA 越能发挥;动态形状、复杂控制、浮点依赖重的部分更适合 GPU/CPU。
量化后的精度怎么验证
量化不是「压完就行」,必须验证:①用一批代表性校准数据统计权重/激活范围,确定 scale;②在验证集上对比 FP32 与 INT8 的精度/召回,掉点超出预期就调量化策略(逐层 scale、混合精度、对敏感层保留高精度)或上 QAT;③硬件侧用定向 testbench 检查累加位宽、截位/饱和、符号处理是否与量化仿真一致。软件精度对、硬件结果错,多半出在定点实现的尺度因子和截位上——这正是 定点数基础 与 FIR/乘加 里反复练的能力。
十二、把 AI 术语翻成 FPGA 术语
| AI 说法 | 硬件对应 |
|---|---|
| 权重 weight / 激活 activation | 存在 BRAM/DDR 的常量 / 流过阵列的数据 |
| 乘加 MAC | DSP 块做乘法 + 加法器累加 |
| 张量/矩阵乘 | MAC 阵列按调度并行处理 |
| 卷积滑窗 | 行缓存 + 窗口选择 + 并行乘加 |
| 批 batch | 一次连续喂入的样本数,影响能否喂满阵列 |
| 量化 INT8 | 8 位有符号/无符号整数 + scale,定点运算 |
| 推理延迟 latency | 数据穿过流水的总拍数 × 时钟周期 |
| 吞吐 throughput | 每周期完成的 MAC 数 × 频率 |
| 算子 operator/layer | 一个可复用的硬件模块(带状态机控制) |
| 编译器/运行时 | 把网络映射到阵列 IP、调度 DMA 与控制寄存器 |
把这张表想通,你会发现 AI 加速器并不神秘:它是「很多 DSP + 精心组织的 RAM/数据流 + 一个状态机控制器」,用的仍是本系列前面教的计数器、状态机、流水线、定点、BRAM、时序收敛。
十三、若想手写:从一个 MAC 到一层网络
即使最终用工具链,手写一个最小乘加核也极有助于理解,而且完全在已学知识范围内:
- 先写单个有符号 MAC:
acc <= acc + a*b,乘法让综合进 DSP,acc 位宽留足(见 数据类型、DSP48),配 valid/ready 握手。 - 例化 4 个 MAC 成小阵列,用 module 与端口 的参数化和 generate 复制,输入/权重从 BRAM 读出。
- 加一个 FSM 控制器:状态包括 LOAD_W(装权重)、RUN(逐拍喂数据、使能 MAC)、DONE(输出累加和),正是 状态机入门 的三段式范式。
- 用 testbench 喂已知整数向量,手算期望累加和比对;再上 ILA 抓实际结果。
- 把 FP32 小模型一层量化成 INT8,让这个核计算并与软件结果比较误差。
做到第 3 步,你就已经「造出」一个微型全连接加速器的核心;做到第 5 步,就理解了量化误差和定点截位。此后再看 Vitis AI 编译出的 DPU,会明白它本质是这套东西的大规模、可编程化版本。
端到端系统通常长什么样
一个真实边缘 AI 节点往往是「传感器 → FPGA → 网络/主机」:FPGA 先做采集与前处理(MIPI/LVDS 接口、滤波、缩放、像素格式转换,这些自定义时序是 GPU 做不了的,见 开发板外设地图),再把规整后的张量送进推理加速器,最后做阈值/后处理并输出结果或上送。训练好的模型经量化编译随比特流/权重文件部署,权重可存在 Flash/DDR、上电加载。FPGA 在这条链路里同时扮演「接口桥 + 前处理 + 低延迟推理」,这是它在工业检测、相机、安防、边缘盒子里不可替代的原因,而不是因为它单点算力比 GPU 强。
三个常见误解澄清
- 误解一:「做 FPGA AI 必须很懂深度学习算法。」不必须。算法由数据科学家训练,FPGA 工程师的核心价值在硬件映射、量化定点、数据流和接口;但要懂网络的计算结构。
- 误解二:「FPGA 会取代 GPU 做训练。」基本不会。训练需要浮点、反向传播、海量算力和成熟生态,GPU/NPU 主导;FPGA 主战场是推理与前处理。
- 误解三:「TOPS 越高越快。」实际性能受带宽、batch、流水效率、算子覆盖率制约;标称 TOPS 是阵列满载峰值,真实利用率常常只有几成,屋顶图和实测延迟才有意义。
算法和工具链(PyTorch、Vitis AI、HLS 版本)迭代很快,但「并行 MAC 阵列 + 数据流喂给 + 定点量化 + 状态机控制」这套硬件本质十年不变。先把这套不变的底层直觉打牢,上层工具怎么换你都跟得上。
最后给入门者一个务实的定位:不必因为「AI 很热」就跳过数字基础直接学工具链。神经网络加速器用到的每一项核心能力——有符号/无符号运算与位宽、DSP 乘加、BRAM 组织、流水线、状态机、时钟与复位、时序收敛、仿真验证——都是本系列入门和进阶篇反复训练的通用 FPGA 能力。反过来,当你能把一个计数器、一个 FSM、一个带 valid/ready 的乘加流水写扎实,再去理解 MAC 阵列、量化和工具链生成的报告,会发现只是规模和复用方式的差别,没有什么不可跨越的黑魔法。建议的进阶顺序是:先吃透定点数与 DSP 乘加,再用 HLS 或手写 RTL 实现一个单算子(矩阵乘/卷积),跑通仿真与上板,最后才接触完整 AI 工具链。这样你对工具链「替你做了什么、什么时候会做不好」会有判断力,而不是只能在黑盒外面猜结果。等你能独立把一个量化小模型的一层在 FPGA 上算出与软件一致的数值,就真正跨过了「从 FPGA 入门到 AI 加速」的那道门槛,后续无论是深入 MAC 阵列架构、算子优化还是工具链集成,都会有扎实的落脚点,也更容易在跨学科团队里和算法、软件工程师对上话,形成共同语言。
十四、量化:神经网络为什么离不开数字格式
要在 FPGA 上跑神经网络,绕不开"量化(quantization)"这个词,因为它直接决定资源够不够、精度掉不掉。训练好的网络权重通常是 32 位浮点(FP32),每个数要占 32 个触发器量级的存储、用浮点运算器处理;而网络动辄几百万到上亿个参数,全用浮点放进 FPGA 既装不下、算起来 DSP 和功耗也扛不住。量化的本质,是把连续的浮点数值映射到有限个离散的整数(或定点)取值上:最常见的是压到 INT8(8 位整数),推理场景下权重和激活常统一用 8 位甚至 4 位表示。位宽从 32 降到 8,意味着同样一块 BRAM 能存 4 倍参数,一个 DSP 单元的乘法吞吐密度也成倍提升,这正是 FPGA(和各种推理芯片)能高效跑网络的关键前提。
代价是离散化带来的精度损失:取值点变少,模型输出会有误差。但大量实践表明,推理阶段对这点误差相当不敏感,FP32 训练好的模型做"训练后量化",常常几乎不掉点;对掉点明显的层,可以用"量化感知训练"在训练时就模拟量化误差,让权重适应低精度表示。实现上通常采用"缩放因子 + 零点"的仿射量化:用一个 scale 和 zero_point 把浮点区间映射到整数区间,DSP 只做整数乘加,缩放换算在层边界集中处理。对 FPGA 初学者,理解量化有三层意义:其一,它解释了为什么神经网络加速器里的 MAC 阵列几乎都做定点整数运算而不是浮点;其二,它是"算法精度—硬件资源"这一 FPGA 核心权衡最典型的案例;其三,它提示了软件与硬件协作的接口在哪里——量化方案通常由软件框架(如 TensorFlow、PyTorch 的量化工具)确定并导出参数,硬件只负责按约定的定点格式高吞吐执行。想动手时,最小实验就是把一个小网络的权重导出成 8 位系数,用 ROM 存进 FPGA,再用本文后面讲的 MAC 结构去算,亲手感受精度与资源的换算。
十五、加速器的存储层次:数据从哪里来、放到哪里
新手设计神经网络加速器时,注意力几乎全放在"怎么堆乘法器"上,但真正决定性能的往往是数据供给,即存储层次和带宽。FPGA 上的存储呈金字塔:最靠近运算的是寄存器,零延迟、可并行读写但极少;其次是片上 BRAM/URAM,容量 KB 到数 MB 级、带宽高、可自由组织成多个 bank;最底层是片外 DDR,容量 GB 级但延迟高、带宽要靠突发访问和缓存来榨取。神经网络一层的计算模式是"权重和输入相乘累加",权重可能上百万个,不可能全放进寄存器,甚至单层都未必放得进片上 RAM,必须从 DDR 分批搬运。于是核心矛盾变成:MAC 阵列每秒能吃掉几 GB 数据,DDR 和片上缓存能不能及时喂饱它。喂不饱,再多乘法器也只能空转,这就是"计算密集"与"访存密集"的分野。
工程上用一套经典手段缓解,叫做数据复用与分块(tiling)。把特征图和权重切成适合片上 RAM 的小块,一块数据搬进来后被尽可能多次使用:权重复用(一组权重对多个输入卷积)、输入复用(一份输入与多组输出通道权重相乘)、输出复用(部分和在片上累加完再写回,避免反复进出 DDR)。配合 Ping-Pong 缓冲(两块 RAM 交替,一块喂计算、一块由 DMA 装填)让搬运与计算重叠,隐藏访存延迟。再往上是用 AXI-Stream/AXI4 这样的流式与内存映射接口、配合 DMA 做批量突发传输。评估一个加速器时,有经验的人会先算"算术强度"——每搬一字节数据能做多少次运算,再对照器件的 DDR 带宽和 DSP 峰值算力,判断瓶颈在计算还是在访存(roofline 模型)。对学习者而言,尽早建立"搬运和计算同等重要、片上存储是稀缺资源、能复用就不重取"的观念,比单纯把 MAC 数量翻倍更能提升真实性能,这也是后续学习 FIFO、DMA、DDR 控制器和数据通路设计时一条贯穿始终的主线。
常见坑对照
| 坑 | 后果 | 正确认识 |
|---|---|---|
| 以为 FPGA 做训练 | 方向错误 | FPGA 主打推理端 |
| 直接上浮点网络 | 资源爆、慢 | 推理先量化 INT8 |
| 只看算力不看带宽 | 实际跑不满 TOPS | 权重/特征图带宽常是瓶颈 |
| 想手写整个网络 RTL | 工程量巨大 | 用工具链/HLS,RTL 只做定制核 |
| 忽视量化精度验证 | 结果偏差大 | 量化后校验精度、必要时 QAT |
相关与延伸
选型:FPGA vs CPU/GPU。 硬件基础:进阶 DSP48 与算术、定点数设计、HLS 入门;系统学网络原理见 神经网络域(nn/);专家层《FPGA AI 推理加速》(后续)。
一句话总结
从硬件视角看神经网络:一个神经元就是"输入×权重求和+偏置再过激活"的一次乘加(MAC),整层是矩阵乘法、整网推理 99% 的运算都是乘加——所以神经网络加速 ≈ 堆大量并行乘法器并源源不断喂数据,这正是 FPGA 的 DSP48 阵列擅长的。关键概念分清:训练在 GPU 上离线学权重(浮点、反向传播),推理是部署后的前向计算(FPGA 主战场,权重固定、可低延迟流水线);量化把 FP32 权重压成 INT8/INT4,精度几乎不掉而 DSP 吞吐翻倍、存储带宽降 4 倍(本质是定点数设计)。工程上几乎不手写整网 RTL:主流用 Vitis AI/OpenVINO 这类工具链把训练好的模型量化编译成比特流,定制算子用 HLS——算法工具会变,但"并行 MAC 阵列 + 数据流喂给 + 定点量化"的硬件本质不变。