LEC aborted 点调试:从黑盒全比到 datapath 切分的分层排查流程
更新时间:2026-10-07。做后端的人都经历过这种早晨:LEC(Logical Equivalence Checking,逻辑等价性检查)的 nightly 回归跑完,报告里不是满眼绿色的 Equivalent,也不是干干净净的几条 Nonequivalent,而是一大片灰色的 Aborted——工具说「这个点我证明不出来也不证明不出来它不等价,我放弃了」。nonequivalent 点的排查方法见 LEC nonequivalent 点调试,那篇处理的是「工具给出了明确不等价结论」;本篇处理的是更磨人的场景:工具连结论都给不出。LEC aborted 点调试的核心思路只有一句话:不要指望工具一口气吃下整个设计,而是按层把证明规模切小到工具能证明为止。下面按「先判性质、再分层切」的顺序展开。
本文要回答的问题
- Aborted 和 Nonequivalent 在报告里都是「没过」,本质区别是什么,为什么不能当失败直接修?
- 面对几百个 aborted 点,第一刀应该切在哪里——约束、黑盒还是结构?
- datapath(数据通路)类 aborted 为什么占大头,切分验证怎么做?
- 每层排查手段的成本差多少,预算怎么排?
一、先分清性质:aborted 不是失败,是「没算完」
等价性检查引擎对每一个比较点(compare point,通常是寄存器、主输出、黑盒输入)做形式化证明,结果只有三种:Equivalent(等价)、Nonequivalent(找到反例)、Aborted(资源耗尽,未得出结论)。第三种最容易被误读——很多团队把 aborted 直接当 nonequivalent 处理,让设计工程师逐点看原理图,结果三天后发现问题根本不在逻辑,而在引擎超时。
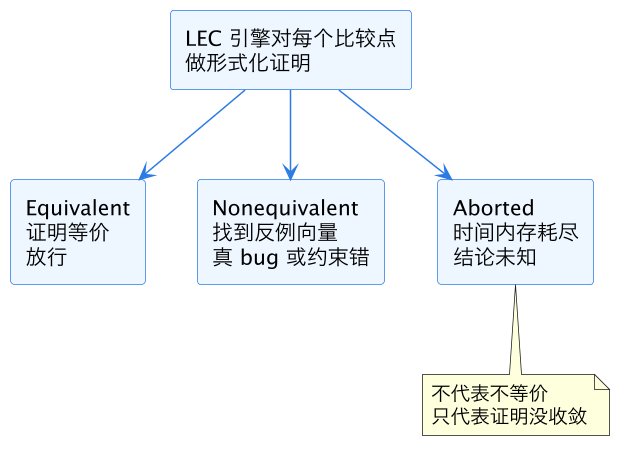
这张图要记住的点是:aborted 处在「未知」区间,它里面既藏着真 bug,也藏着大量「逻辑其实等价但证明太难」的假阳性。工程水位上,一个缺少针对性约束的成熟设计,aborted 点里真正不等价的比例通常不到一成——其余九成以上是约束缺失或证明规模超限。所以 LEC aborted 点调试的第一条纪律是:先消规模,再谈对错。直接跳进原理图找 bug,等于在九成假阳性里抽奖。
aborted 的成因可以归成三类,排查顺序也按这个来:
| 成因类别 | 典型表现 | 占比水位 | 处置方向 |
|---|---|---|---|
| 约束缺失 | 扫描使能、测试模式、常量引脚没设 | 四到六成 | 补约束重跑,成本最低 |
| 证明规模超限 | 乘法器、复杂算术块、深组合锥 | 三到四成 | datapath 切分或黑盒 |
| 真不等价 | 集中在某次 ECO 改动附近 | 不足一成 | 转 nonequivalent 流程 |
二、第零层:把约束欠的账先补上
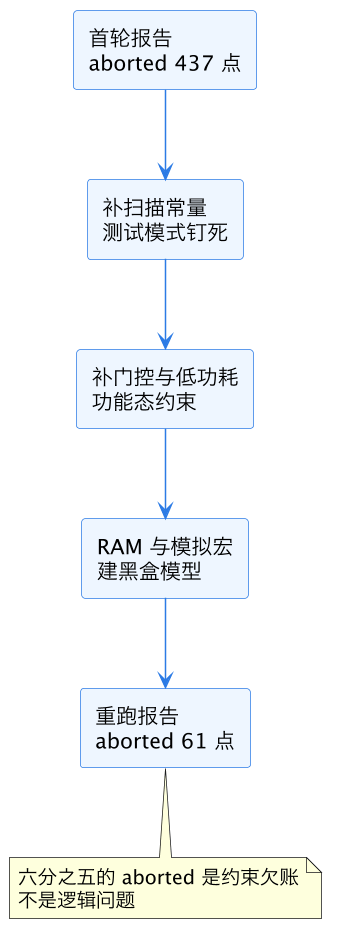
一半以上的 aborted 是「工具被迫证明一个它不知道前提的命题」。最常见的欠账有四笔:扫描相关的测试使能没钉常量(set_constant 0 scan_enable 一类),导致引擎要同时证明功能模式和测试模式两种行为;时钟门控单元的使能端约束缺失,证明空间多翻一倍;综合插入的保留寄存器(retention register)和低功耗结构(隔离单元、电平转换器)的功能态约束没给——低功耗场景的专门约束清单见 Conformal 低功耗 LEC 检查;第四笔是存储器和模拟宏没建库模型,引擎把 RAM 当一片巨大的组合逻辑硬啃,必然超时。
这一层的动作机械但收益巨大:对照 checklist 把常量、模式约束、库模型补齐后重跑, aborted 数常见从几百掉到几十。给一个真实量级的例子:某 28nm 项目 RTL 对综合网表首轮 LEC,aborted 点 437 个;补全 scan/test 常量与 12 个 RAM 黑盒模型后重跑,aborted 掉到 61 个——七分之六的「问题」根本不存在。这一层的花费是几个小时,是全部五层里性价比最高的。
补一条容易踩的坑:约束补全后不要急着逐层排查,先看一遍 compare point 的映射(mapping)报告。映射失败(unmatched point)和 aborted 经常是同源的——综合工具做了边界优化(boundary optimization)或跨层次打平后,两个版本里根本不存在对应点,引擎对这类点的「证明」从一开始就建立在错误配对上,跑再久也是 aborted。把映射报告里 unreachable、unmatched 的点先清掉,往往又能顺手带走一批 aborted,还避免后面在错误的配对上白白切分。
三、第一层:黑盒隔离,先把「啃不动的」请出证明场
补完约束仍 aborted 的点,下一步是看它们的逻辑锥(logic cone,从比较点回溯到输入的全部组合逻辑)里有没有「引擎天敌」——乘法器、除法器、浮点单元、大型桶形移位器。这些结构的输入输出关系是算术的,而 LEC 引擎的布尔推理在乘法门数上是指数爆炸:一个 32 乘 32 乘法器的门级展开有上万门,两个结构不同(RTL 行为级综合出的 booth 编码树 vs 网表里被 retime 过的另一棵树)的实现做布尔等价,跑一晚上 aborted 是标准结局。
黑盒比对的思路是「先承认我证明不了里面,那就只证明外面」:把啃不动的模块在两个版本里同时设成黑盒(Conformal 的 set_black_box,Formality 里对应 verification 的 blackbox 设置),引擎只需证明「两个版本在黑盒边界上的连接关系一致」,黑盒内部的一致性由另一路保证——或交给专门的数据通路验证工具,或复用前仿真的回归证据,或在 ECO 流程里用增量比对兜底。黑盒之后 aborted 是否消失,直接告诉你问题是不是出在这些模块内部。
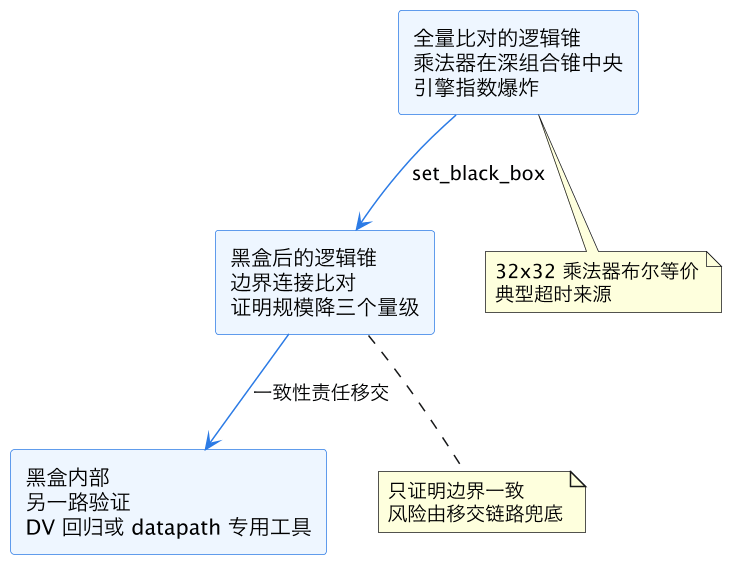
黑盒是把风险搬家而不是消灭风险,所以纪律有两条:一是黑盒清单要进流程文件,哪些模块被黑盒、内部等价性由谁担保、担保证据在哪,签核时要能翻出来;二是黑盒边界必须在两个版本中严格对应——一边黑了乘法器实例 A、另一边黑错了实例,边界比对会报出大量假的 nonequivalent,反而把水面搅浑。ECO 场景下黑盒边界与改动范围的关系,可以对照 功能性 ECO 网表补丁 里的影响锥分析来定。
四、第二层:datapath 切分,把大证明拆成小证明
黑盒之后剩下的 aborted 点,集中在 datapath 上:不是单个乘法器,而是「寄存器堆加 ALU 加旁路选择器」这一整片算术数据通路被综合工具整体重排过——retiming 把寄存器推过组合逻辑、资源复用把两个加法器合成一个、操作数重排(operand reordering)利用了加法交换律。这些变换在数学上保等价,但把两个版本的中间结构差异拉得很大,引擎做关键点映射(key point mapping)失败,只能退化成整锥证明,然后超时。
datapath 切分的套路是人工给引擎搭「中间跳板」:在两个版本里找功能上对应的中途信号(比如 ALU 的两个操作数输入、复用器的输出),用 add_pin_constraints / 等价点声明(Conformal 的 add equivalent points、Formality 的 set_user_match 加 verify 切分)把它们声明为待验证等价点,引擎先证明「输入到跳板」这段等价,再以跳板为起点证明「跳板到输出」这段等价——证明空间从一个大锥拆成两个小锥,每段的深度和宽度都在引擎能力之内。
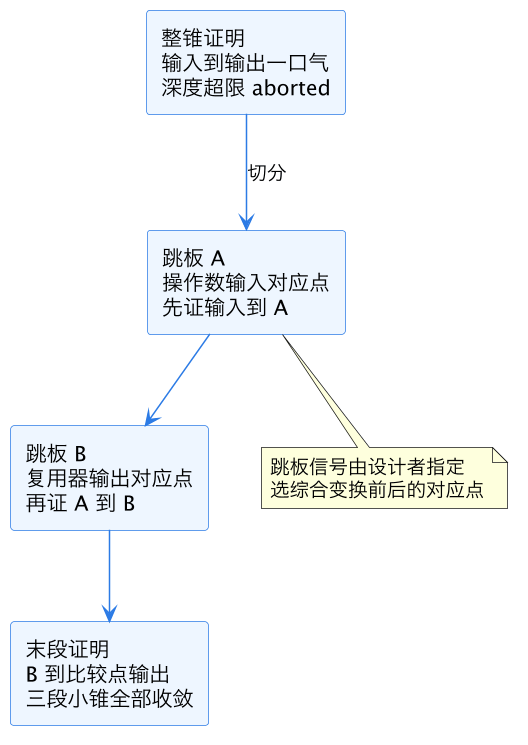
跳板选得好不好决定这一层的成败,三个经验法则:选「语义锚点」而不是随手挑线网——操作数、结果、选择信号这类在 RTL 里有名字的线,综合后存活概率高;每个大逻辑锥放一到两个跳板,放太多会把引擎拖进跳板自身的映射开销;跳板声明后要单独 verify 一次,如果跳板本身报 nonequivalent,说明你选错了对应点,撤掉重选,不要硬往下推。对运算单元选型背景不熟的读者,综合数据通路运算器选择 讲了综合工具会怎样重排算术结构,看完就明白为什么两个版本的中间结构会对不上。
这一层的成本开始上升:每个顽固 aborted 点平均要花半天到一天读两边的映射报告、选跳板、迭代验证。所以执行顺序很关键——只有前两层清场后剩下的点,才配得上这一层的人工。
五、第三层:剥案例与升级工具,承认「这个引擎不适合这题」
切分后仍有个位数顽固 aborted 时,进入最后的精细化阶段,三板斧按序来。第一板斧是剥案例:把 aborted 点所在的模块从设计里剥出来,连同约束做成一个独立小 testcase 单独跑 LEC——脱离大设计后内存和映射干扰都消失,很多点在小环境里几分钟就收敛,反过来证明大设计里的 aborted 是资源竞争问题。第二板斧是换引擎策略:提高引擎的努力等级(effort level)、切换求解器策略(Formality 的 set_verification_priority、Conformal 的多引擎并发),或者干脆换工具交叉验证——两家引擎的强项不同,一家 aborted 的点另一家常能直接证明。第三板斧是承认 LEC 不是万能钥匙:对时序重构(sequential retiming)跨度大的设计,改用时序等价性检查 SEC(Sequential Equivalence Checking),机理见 形式验证之时序等价 SEC;对纯算术数据通路,用专门的 datapath 验证工具按算术语义而非布尔语义证明,乘法器类问题在那边是顺手题。
| 排查层 | 动作 | 单点成本 | 消减水位 | 何时上 |
|---|---|---|---|---|
| 第零层 | 补约束与库模型 | 小时级(整批) | 消掉四到六成 | 永远第一步 |
| 第一层 | 黑盒隔离 | 半天(整批) | 再消两到三成 | 约束补完后 |
| 第二层 | datapath 跳板切分 | 半天到一天(单点) | 消掉大部分剩余 | 黑盒清场后 |
| 第三层 | 剥案例/换引擎/换工具 | 一到两天(单点) | 个位数顽固点 | 最后兜底 |
把四层串起来就是完整流程,一张图可以收口全篇。
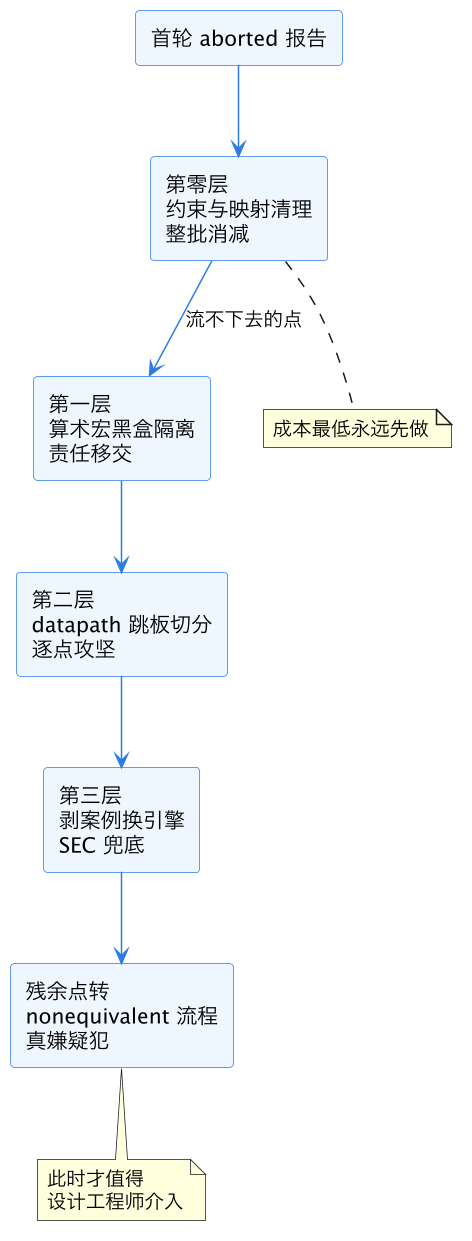
这张图的读法是自顶向下成本递增、点数递减:每一层只处理上一层流下来的点,且每一层做完都要重跑一次全量验证确认消减效果,不要在一层里恋战。具体到执行:首轮报告先跑约束 checklist 整批消减,再对剩余点按逻辑锥内容分类——锥里有算术宏的黑盒,锥里是重排 datapath 的上跳板,剩下的剥案例换引擎。每一层「消不掉」的点自动流到下一层,最终流到 nonequivalent 排查的点才是真正的嫌疑犯——那时再按 LEC nonequivalent 点调试 的反例向量流程逐点攻。整条链路跑顺之后,一个几百点 aborted 的首轮报告,收敛到个位数真嫌疑点通常在两到三个工作日,而不是无头苍蝇式的两周。
这一篇在知识体系里的位置
本篇是形式验证专题的流程排障篇:工具与比对方法学的基础在 形式验证之 LEC 与 Formality,明确不等价结论的反例调试在 LEC nonequivalent 点调试;横向关联 Conformal 低功耗 LEC 检查(第零层约束欠账的大头)、LEC 扫描与 DFT 验证(扫描约束的细节)、形式验证之时序等价 SEC(第三层的替代引擎);上游衔接 综合数据通路运算器选择(datapath 结构差异的来源),下游衔接 功能性 ECO 网表补丁(ECO 后的增量 LEC 是 aborted 高发场景)。
总结
LEC aborted 点调试的本质是「管理证明规模而不是证明逻辑」:aborted 只代表引擎资源耗尽,其中真 bug 通常不足一成,所以排查必须分层——先补扫描常量、低功耗约束与宏模型消掉四到六成假阳性,再对乘法器等引擎天敌做黑盒隔离并移交内部验证责任,然后对综合重排过的数据通路人工设等价跳板把大锥切成小锥,最后对个位数顽固点剥案例、换引擎或转 SEC/datapath 专用工具;按这个顺序,几百点 aborted 的两周乱仗可以压成两三天收敛到真嫌疑点的标准流程,每一层流不下去的点才配占用设计工程师的眼睛。