FPGA 原型验证专题 42:在降频原型上做架构性能评估——cycle 计数、跨片延迟扣除与 A/B 外推
更新时间:2026-09-13。本文是模块 E 第三篇。30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算讲怎么把启动时间换算回芯片预期,24 活动覆盖率与性能调试闭环 热点/瓶颈/回放讲活动/剖视回收,43 原型结果可信度分级 可签核/可决策/仅参考与报告规范给通用可信度框架;本篇专注架构师最想要、也最容易做错的事:在一个比真实芯片慢十倍、还被切成多片的原型上,测出能指导微架构决策的性能数字。
一、第一原则:数周期,不要看表
原型 DUT 可能跑在 2~10 MHz,目标芯片跑在 1.5~3 GHz,再叠加跨片 TDM 和速率适配,墙钟时间(秒表测出来的启动多久、一秒传多少数据)几乎不携带任何芯片性能信息。但数字系统的性能本质由"完成一件事花了多少个时钟周期"决定。只要在原型里用 DUT 自己的时钟数 cycle,降频就不影响计数结果——2 MHz 和 2 GHz 数出来的 100 万个 cycle 都是 100 万个 cycle,外推到目标频率就是 100 万 / f_target。
所以性能评估的全部技术,围绕三件事:
- 在原型里准确地数 cycle / 取性能计数器;
- 识别并扣除原型平台人为引入的伪周期(跨片、适配、替换模型);
- 用受控 A/B 拿到可信的相对趋势,再谨慎外推绝对值。
二、可信度量指标分级:哪些直接信、哪些要扣、哪些不能给
| 指标 | 原型可信度 | 原因/处理 |
|---|---|---|
| IPC、提交/退休周期数 | 高(直接数) | 核心内部行为,cycle 精确 |
| 缓存命中率/失效率、Miss 类型分布 | 高 | 由访问序列决定,与频率无关 |
| 分支预测、TLB miss | 高 | 同上,纯微架构事件 |
| 总线上的请求/响应周期数、占用率 | 中高 | 主设备/从设备同片时可信;跨片要扣 TDM |
| 访存延迟(cycle) | 中 | 真实 DRAM 经速率适配/替换模型时延迟失真,见下 |
| DMA 传输周期、吞吐(cycle/块) | 中 | 端点在片外、经适配器时延迟和突发形状失真(33 PCIe/SerDes 上原型 硬核/降速子卡/LTSSM) |
| 绝对带宽(GB/s)、绝对延迟(ns) | 低 | 只能由 cycle 外推,且平台伪延迟要扣净,43 原型结果可信度分级 可签核/可决策/仅参考与报告规范标"参考" |
| 中断响应实时性(RTOS 最坏延迟) | 低 | 跨片抖动和 FPGA 时序非芯片时序,30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算 |
| 物理接口线速(SerDes/PHY 速率) | 不可测 | PHY 被替换/降速,31 速率适配器 Speed Adapter 弹性FIFO/两种范式 |
经验法则:越是"核心/缓存/互连内部的纯微架构相对量",原型越可信;越是"绝对时间、片外接口、物理时序",越不能直接信。
三、三类必须扣除的"伪周期"
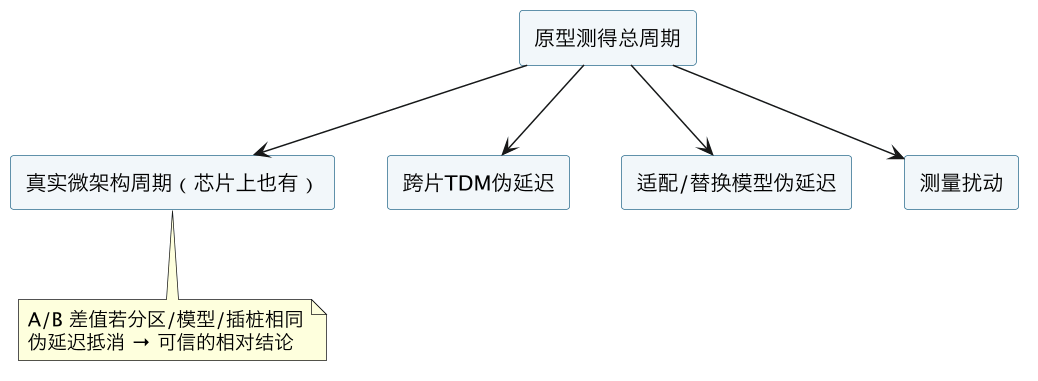
原型测到的总周期里,混着平台自身引入、芯片上不存在的延迟,做架构结论前要逐项识别:
- 跨片 TDM 延迟。一次访存/事务若跨越分区边界,割边信号经 TDM 传输引入固定的额外周期(13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频),可能高达十几到几十周期。处理:让 A/B 两版用完全相同的分区(使伪延迟成为常数、在差值里抵消),或从 trace 里按 TDM 时隙表(40 多板多 FPGA 全局触发与时间对齐 跨片 trace 同步)逐笔扣除。关键路径模块(CPU↔LLC↔内存控制器)尽量划在同片(12 多 FPGA 分区算法 割集/容量/图划分)。
- 速率适配器/替换存储延迟。真实 DDR 经降速桥、或用片上/替換存储建模时,延迟和刷新行为与真实 DRAM 不同(32 DDR/存储接入原型 真实DRAM/降速模型/容量墙)。做缓存层次/访存调度研究时,要在 BFM/存储模型里配置成目标 DRAM 的周期级延迟参数,并在报告里注明存储模型保真度;否则不同缓存大小的结论可能被模型延迟污染。
- **测量与探针扰动。**性能计数器读回、深 trace 占用互联和带宽可能让被测系统变慢(39 商用原型调试 IP 深跟踪/动态探针/可见性预算)。处理:性能计数用 DUT 内硬件计数器(只数不阻断),避免为取数频繁停系统;A/B 两版插桩完全一致。
四、受控 A/B 实验怎么做才可信
原型做架构探索(改缓存大小/路数、换总线位宽/仲裁、加预取、调 QoS、改 NoC 路由)的正确姿势是实验科学,不是"跑两版感觉一下":
- **一次只变一个变量。**A 版与 B 版除被测参数外,RTL、分区、时序、软件镜像、输入数据、trace 插桩全部相同;
- **伪延迟在差值中抵消。**只要两版分区和模型一致,TDM/适配引入的常数伪延迟在
B − A里抵消——这正是原型更适合回答"改了之后变好多少(相对)"而非"绝对是多少"的根本原因; - **用真实、固定的负载。**跑同一份软件/同一段视频/同一组网络流量(34 以太网/USB/MIPI 外设接入 子卡生态/等时实时性),用确定性种子,最好也跑多组负载看结论是否普适;
- **多 run 取数看方差。**偶发跨片抖动/握手会影响单次数值,重复运行取均值与分布,差异小于 run 间抖动就不能下结论;
- **以 cycle 和微架构事件比,不以秒比。**报告 IPC 变化、MPKI(每千指令 miss 数)、总线排队周期分布、加速比(B_cycles/A_cycles),再外推。
外推到芯片:芯片预期耗时 ≈ 测得 cycle 数 / f_target(对可直接采信的指标);比较类结论用加速比最稳——若两版在原型上 B 比 A 少 12% 的周期且伪延迟同构,有合理把握芯片上也接近 12%,但绝对带宽/延迟仍标注为参考(43 原型结果可信度分级 可签核/可决策/仅参考与报告规范)。
五、性能埋点规划:像设计特性一样设计计数器
性能评估的质量取决于有没有数对地方,而计数器在 RTL/网表阶段就要规划(事后加要重编译,39 商用原型调试 IP 深跟踪/动态探针/可见性预算):
- 复用架构性能计数器:CPU PMU、缓存/NoC/DMA 自带的 event 计数优先,软件可读、cycle 精确、不扰时序;
- 关键路径加分段计时:请求发出→总线授权→从设备响应→数据返回,各段单独计周期,才能定位瓶颈在仲裁、互连还是端点;
- 占用率/水位计:队列占用、buffer 水位、反压断言次数,判断瓶颈是容量还是仲裁;
- 全局周期基准:一个统一的 DUT 周期计数器(与 40 多板多 FPGA 全局触发与时间对齐 跨片 trace 同步全局时基一致)给所有事件盖时间戳;
- 读数不打断系统:批量读、内存映射快照或随 trace 带出,避免频繁停启污染时序。
六、典型可答与不可答问题
**原型性能评估能可靠回答:**把 LLC 从 1 MB 加到 2 MB 对这组负载的 MPKI/IPC 影响;A 仲裁策略是否在混合 QoS 下饿死低优先级;预取器打开后总线流量和命中的变化;某软件栈的热点和访存模式。
**不能直接回答:**芯片最终 SPECint/绝对主频性能;真实 DDR-XXXX 下的精确延迟;SerDes 链路误码相关性能;中断最坏响应时间是否满足硬实时(30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算只能工程估计)。这些要靠仿真分析、STA、硅后实测签核,原型只给趋势输入。
七、算例:一次 LLC 扩容实验的正确与错误算法
给一组示意数字,把原则落成算术。在 4 片 FPGA 原型上评估末级缓存 1 MB(A)vs 2 MB(B),DUT 跑在 5 MHz,目标芯片 2 GHz,同一分区、同一存储模型、同一编译开关:
- 固定负载跑完,性能计数器读出 A 版 4.00 亿 cycle、B 版 3.52 亿 cycle,MPKI 分别为 18 和 11,跨片访存事务两版次数相同(TDM 伪延迟结构一致)。
- 正确结论:B 相对 A 周期减少 12%,加速比 1.136;改善主要来自 MPKI 下降(18→11),这是与频率无关的微架构事实,置信度 L2(43 原型结果可信度分级 可签核/可决策/仅参考与报告规范)。
- 允许的外推:2 GHz 下该负载 A 版约 0.20 s、B 版约 0.176 s(cycle/频率),但必须注明"未含真实 DRAM tRC/tRFC、PHY 延迟和操作系统抖动,仅供趋势参考"。
- 错误做法一(看墙钟):A 版在原型上跑了 80 秒、B 版 70.4 秒就去汇报"快了 10 秒"——这两个数只反映 5 MHz 时钟,对芯片毫无意义。
- 错误做法二(分区不同):B 版因为容量大被重新分区、CPU 到 LLC 跨了一片,每访存多 20 cycle TDM;若拿这个 B 和原 A 比,12% 改善可能被伪延迟吃掉甚至反转,且无法分离变量。
- 错误做法三(单次下结论):只跑一遍,run 间抖动 ±3%,则 12% 仍可信;但若实验差异只有 2~3%,就必须加 run 数直到置信区间不跨零。
再给一个伪延迟扣除的算例:若关键路径实在无法同片,测得每笔跨片访存比片内多 16 个 DUT 周期,A/B 两版该事务各发生 2000 万次,则两版各含 3.2 亿"伪周期"的固定形状——比较绝对 cycle 前要么在 trace 中逐笔扣除,要么至少确认两版该事务数相同(本例相同,故差值比较仍然成立,但任何绝对值结论都要先扣)。
性能结论要能被三句话问住而不倒:数字来自哪个计数器、伪延迟怎么处理、跑了几个 run 方差多大。
八、一组典型的"测量失真"案例
除跨片 TDM 外,还有几种失真在实践中反复出现,每个都让人得出过错误架构结论:
- **速率适配器把突发拉平。**经降速桥接的以太网/PCIe 流量,适配器弹性缓冲把真实业务的突发整形成均匀流(31 速率适配器 Speed Adapter 弹性FIFO/两种范式),于是原型上"队列从不溢出、QoS 完美"——这不是仲裁设计好,而是输入被整形了。涉及突发/排队的结论要么在片内注入流量、要么用能保留突发形状的注入模型,结论注明适配器影响。
- **替换存储的刷新行为缺失。**片上/行为级存储模型不模拟真实 DRAM 的 tRFC 刷新停顿(32 DDR/存储接入原型 真实DRAM/降速模型/容量墙),长时间满载下的尾部延迟会被系统性低估。看 p99/p999 延迟的实验必须用带刷新参数的周期级模型,否则尾延迟结论不可信。
- **降频改变了软件的时间假设。**软件里的 busy-wait、基于默认节拍的超时、驱动轮询间隔是按真实频率调的,原型降频后有的超时提前误触发、有的等待被异常拉长(30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算),由此产生的"性能差异"其实是软件行为变了。性能实验前统一把软件时间基准改为读硬件 cycle 计数器。
- **trace 开启与关闭两轮不一致。**开深 trace 占用了额外互联/DDR 带宽,和关闭 trace 的基线不可比——A/B 两轮插桩必须完全一致,哪怕 A 版"用不到"这些探针。
- **冷缓存 vs 热缓存混淆。**启动后立即测(缓存冷、TLB 冷)和预热后测,cycle 数能差几倍;对比实验固定预热阶段和测量阶段的边界。
- **把功能模型的吞吐当硬指标。**被替换的 PHY/控制器模型很多是"尽快返回"的功能模型,吞吐可能比真实硬件还高——模型给出的乐观数字同样不能外推(43 原型结果可信度分级 可签核/可决策/仅参考与报告规范标 L3)。
识别失真的通用动作:测任何指标前先问一句"这个数字里,有多少周期是 DUT 逻辑产生的、有多少是平台/模型/软件适配产生的"。答得出来,数字才可用于决策。
九、性能实验的数据记录模板
受控实验最大的敌人是"两周后没人记得这个数字怎么来的"。每次 A/B 实验固定记录如下字段(可存成一页表或直接放 bug/实验跟踪系统):
| 字段 | 内容 |
|---|---|
| 实验编号/日期/负责人 | 归档与追责 |
| 假设 | 一句话:"把 LLC 从 1 MB 加到 2 MB 会把该负载 MPKI 降到 X 以下" |
| 变量 | 唯一变更项(参数名 + A 值 → B 值) |
| 不变量清单 | RTL commit、分区/割边版本、存储模型及时延参数、时钟频率、软件镜像、输入数据种子、trace/计数器插桩——逐项勾"两版一致" |
| 原始计数 | 总 cycle、提交指令数、各级 miss/hit、总线事务数与分段周期、反压次数;不是只记一个最终比值 |
| 统计 | run 次数、均值/极差/标准差,差异相对 run 间抖动是否显著 |
| 伪延迟处理 | 跨片路径、TDM 比、扣除/抵消方式 |
| 结论与级别 | 相对结论(L2)或仅参考(L3),外推算式与假设(43 原型结果可信度分级 可签核/可决策/仅参考与报告规范) |
| 后续 | 是否需仿真分析/STA 确认绝对量,决策落点(改/不改/再实验) |
两个常被忽略的纪律:其一,实验失败或"没差异"也是结论,同样归档(避免三个月后有人再做一遍同样的缓存路数实验);其二,原始计数要和比特流/镜像版本强绑定(20 比特流烧录与四方版本一致 manifest/门禁),否则数字无法复现,评审时只能当传闻。
十、原型之外:性能结论如何与其他工具交叉验证
再规范的单引擎测量也应有交叉验证点。常见的组合:对同一段热点代码,仿真里做 cycle-accurate 的微基准(只跑这一小段、不启动整系统),与原型的计数器数字比对,差异大说明平台伪延迟或模型配置有问题;用解析/排队论模型估算总线饱和点,看原型实测拐点是否在预期附近;回片后用真实 PMU 数字校准外推系数(43 原型结果可信度分级 可签核/可决策/仅参考与报告规范、05 原型到硅后衔接 pre/post-silicon 协同/errata)。三个来源一致的趋势才是高置信结论;只在原型上出现、在仿真分析中解释不了的"性能突变",先怀疑测量/平台问题而非宣称发现了架构现象。
十一、给软件团队的性能协作建议
架构性能实验不只是硬件团队的事,软件侧配合与否直接决定数据质量:驱动和 benchmark 应通过官方 PMU 接口读计数器而非自记时间戳;负载入口和结束点用固定的内存映射标记,硬件 trace 可据此精确截取测量窗口;基准程序要避免依赖墙钟和随机地址布局(固定链接脚本、固定数据集);一次实验输出结构化结果行(总 cycle、指令数、各事件计数),方便多 run 自动汇总而不是人工抄屏。软件侧把"性能可观测"当作 bring-up 的交付物之一,A/B 迭代速度能从按天变成按小时。
十二、常见坑速查
- 用墙钟秒表报告性能 → 一律改成数 cycle;
- A/B 分区不同 → 伪延迟不抵消,结论作废;
- 直接报绝对 GB/s/ns → 只能外推且标注参考;
- 存储模型延迟没配成目标 DRAM → 缓存研究被模型污染;
- 频繁读计数器停系统 → 测量本身改变结果;
- 单次 run 就下结论 → 看多 run 分布,差异要大于抖动;
- 事后才想要计数器 → 首轮构建就规划埋点。
与系列及现有篇目的链接
- 可信度与报告:43 原型结果可信度分级 可签核/可决策/仅参考与报告规范
- 平台伪延迟来源:13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频、32 DDR/存储接入原型 真实DRAM/降速模型/容量墙、31 速率适配器 Speed Adapter 弹性FIFO/两种范式、33 PCIe/SerDes 上原型 硬核/降速子卡/LTSSM
- 测量与时间基准:39 商用原型调试 IP 深跟踪/动态探针/可见性预算、40 多板多 FPGA 全局触发与时间对齐 跨片 trace 同步、30 Linux/RTOS 在原型上启动 启动链/降频补偿/时间换算、12 多 FPGA 分区算法 割集/容量/图划分、24 活动覆盖率与性能调试闭环 热点/瓶颈/回放
总结
一句话总结:原型比芯片慢一个数量级还被切成多片,墙钟时间毫无意义,但数字系统性能本质是"完成一件事花多少时钟周期",所以在原型里用 DUT 自己的时钟数 cycle 就能摆脱降频影响(2 MHz 和 2 GHz 数出的 100 万 cycle 同为 100 万,外推就是 100 万除以目标频率),方法围绕数对周期、扣净平台伪周期、做受控 A/B 三件事;可信度上越是核心/缓存/互连内部的纯微架构相对量越可直接采信(IPC、缓存命中率、MPKI、分支/TLB、同片总线排队周期),越是绝对时间、片外接口、物理时序越不能信(真实访存经速率适配或替换模型延迟失真、DMA 突发形状失真、中断最坏延迟受跨片抖动污染、SerDes 线速根本不可测);三类伪周期必须识别——跨片 TDM 的固定额外周期(最好把 CPU↔LLC↔内存控制器关键路径划同片,A/B 用相同分区让它成为常数在差值里抵消,或按时隙表逐笔扣除)、速率适配器和替换存储未配成目标 DRAM 周期级延迟导致缓存研究被污染、以及读计数器和深 trace 占用带宽带来的测量扰动(要用 DUT 内硬件计数器只数不阻断);A/B 实验要一次只变一个参数、RTL/分区/时序/软件镜像/输入/插桩全同、用确定性真实负载并跑多组看普适、重复 run 取均值与分布(差异小于 run 间抖动不下结论),报告 cycle 数、MPKI、排队周期分布和 B/A 加速比而非秒,芯片侧用"测得 cycle/目标频率"外推、相对趋势(如同构下 B 比 A 少 12% 周期)较有把握而绝对 GB/s 和 ns 只能标注参考(84 篇);埋点要在首轮构建就像设计特性一样规划,优先复用 CPU PMU 和缓存/NoC/DMA 自带事件计数,对请求→授权→响应→返回分段计时并加队列水位和反压计数,用统一全局周期基准盖时间戳、批量快照读数不打断系统;因此原型能可靠回答"改 LLC/仲裁/预取/QoS/NoC 后变好多少、软件热点在哪",但不能签核最终 SPECint 绝对性能、真实 DRAM 精确延迟、SerDes 误码和硬实时最坏响应——那些归仿真分析、STA 和硅后,原型只给趋势输入。